この記事の結論
基本操作の次に効いてくるのは、機能を増やすことではなくデータ構造を整えることです。カスタムオブジェクトで自社固有のデータをCRMの中に構造化し、計算プロパティと権限設計で「人に頼らず回る運用」に変える。これが応用フェーズの本質です。
基本操作の次に効いてくるのは、機能を増やすことではなくデータ構造を整えることです。カスタムオブジェクトで自社固有のデータをCRMの中に構造化し、計算プロパティと権限設計で「人に頼らず回る運用」に変える。これが応用フェーズの本質です。
基本操作の次に効いてくるのは、機能を増やすことではなくデータ構造を整えることです。カスタムオブジェクトで自社固有のデータをCRMの中に構造化し、計算プロパティと権限設計で「人に頼らず回る運用」に変える。これが応用フェーズの本質です。
「コンタクトと取引だけでは、うちの物件情報や請求データが管理しきれない」「結局、請求管理はスプレッドシートに戻ってしまった」「プロパティが増えすぎて、営業がどこに何を入れればいいか分からない」——HubSpotを一定期間使い込んだ企業から、私たちがよくいただくご相談です。基本機能は動いているのに、業務の一部だけがCRMの外に取り残されている状態と言い換えてもいいかもしれません。
HubSpotの応用機能とは、標準オブジェクト(コンタクト・会社・取引・チケット)だけでは表現できない自社固有のデータ構造を作り、その運用をAIと権限設計で仕組み化するための機能群です。カスタムオブジェクト、データモデル作成ツール、同期・計算プロパティ、Breeze、権限セットなどが該当し、多くはEnterpriseプランや上位プランで提供されます。
本記事は「AI × CRMで企業価値を上げる設計思想|経営者が知るべきAI CRM戦略」シリーズの一部です。この分野の体系的な情報はHubSpot機能ガイドでまとめています。
本記事はStartLinkの「AI活用完全ガイド」関連記事です。
応用機能は種類が多く、どれから手をつけるべきか迷いやすい領域です。ここでは、データ構造・画面・AI・権限という4つの切り口で、何をどの順番で押さえればよいかを整理します。
HubSpotの基本操作には慣れていて、管理者としてデータ構造を整備したい上級ユーザー・管理者の方に向けて書いています。最後まで読むと、10の応用機能を「自社ではどれをどの順番で使うか」という優先順位付きの計画に落とし込めるようになります。
応用機能は、新しい機能を覚える話ではなく、いま業務のどこがCRMの外に残っているかを見つける話から始まります。私たちがご支援に入るとき、最初にお聞きするのは「HubSpotを見れば全部わかる状態ですか」という一点です。ここが曖昧なまま機能を足すと、使われない項目とダッシュボードだけが増えていきます。
請求管理、物件情報、商品マスター、契約更新日の一覧。こうした情報は、CRM導入後もスプレッドシートで管理され続けているケースが少なくありません。問題は手間そのものではなく、同じ顧客の情報がHubSpotとシートの2カ所にあり、差分が起きることです。営業はHubSpotを見て、バックオフィスはシートを見る。数字を突き合わせる会議が毎月発生します。
棚卸しの手順はシンプルです。①定期的に更新されているスプレッドシートを全部挙げる、②それぞれが「顧客・取引に紐づく情報か」を判定する、③紐づくものだけを応用機能の検討対象にする。顧客に紐づかない純粋な社内集計表まで無理にCRMへ持ち込む必要はありません。
判断基準は「そのデータが1件ずつ独立したレコードとして存在し、他のレコードと多対多や1対多の関係を持つか」です。取引のプロパティを増やすだけで済むなら、カスタムオブジェクトは不要です。
| 状況 | 適した手段 | 理由 |
|---|---|---|
| 取引ごとに1つだけ持つ属性(契約期間など) | 取引のプロパティ | レコードを増やす必要がない |
| 1つの取引に複数ぶら下がる明細(請求が毎月発生する等) | カスタムオブジェクト | 件数が可変で、個別にステータス管理が必要 |
| 商品や物件などのマスターデータ | カスタムオブジェクト | 複数の取引から同じレコードを参照する |
| 一時的な集計・分析用の表 | レポートまたは外部ツール | CRMのデータ構造にする必要が薄い |
ただし、カスタムオブジェクトはEnterpriseプランで利用できる機能です。プランの制約がある場合は、取引パイプラインを分けて運用するなど、標準機能内での代替案を先に検討することをおすすめします。
10機能すべてを一度に入れる必要はありません。私たちがお客様と決める順番は、原則として「データ構造 → 画面 → 自動化 → AI → ガバナンス」です。構造が決まっていない状態で自動化やAIを載せると、前提が変わるたびに作り直しになるためです。まずは棚卸しで見つかった業務のうち、頻度が高く関係者が多いもの1つに絞って着手するのが現実的です。
カスタムオブジェクトは、標準オブジェクトでは管理しきれないデータを、CRM内のテーブルとして定義できる機能です。Enterpriseプランで利用できます。ここが応用フェーズの入り口であり、ここを間違えると後続の画面設計もレポートも歪みます。
作成は「設定」→「カスタムオブジェクト」から行います。設定するのはオブジェクト名(単数形・複数形)、プライマリー表示プロパティ、必須項目です。プライマリー表示プロパティは、コンタクトの「名前」や会社の「会社名」に相当する基本識別情報で、一覧やレコードのタイトルとして表示されます。請求データなら請求番号、物件なら物件名のように、一意で人が見て判別できる値を選ぶのがポイントになってきます。
作成後は、標準オブジェクトと同じようにデータの作成・インポート・プロパティの追加・関連付けが可能です。既存のスプレッドシートがあれば、そのままインポートで初期データを投入できます。
カスタムオブジェクトにもパイプラインを設定できます。請求データであれば「請求予定」→「請求実施」→「入金済み」→「未入金」というステージを作り、ボードビュー(カンバン形式)でドラッグ&ドロップ管理が可能です。取引パイプラインと同じ操作感なので、営業が新しく覚えることはほとんどありません。ボード設定から、カード上に表示するプロパティ(請求日、金額など)も選べます。
この考え方は、取引パイプライン設計と同じです。ステージは「状態が変わる節目」で切る、各ステージの定義を文章で社内共有する、移行時に必須入力を設ける。この3点を押さえておくと、担当者が変わってもデータの粒度が揃います。属人的な運用を、ステージ定義という形でシステム側に持たせるのです。
不動産業であれば物件や土地のデータ管理、SaaS企業であれば請求データや契約データ、製造業であれば商品マスターの管理などが代表的な活用例です。一方で、ただし向かないケースもあります。
こうしたデータまでCRMに持ち込むと、オブジェクトが増えた割に誰も見ない、という状態になりがちです。カスタムオブジェクトは「関連付けて意味が出るデータ」に絞ったほうが結果的に使われます。企業様によって最適な構成は異なりますので、まずは1オブジェクトから始めて、運用が回ってから次を追加する進め方が安全です。
カスタムオブジェクトを増やしていくと、オブジェクト間の関係性が急速に複雑になります。データモデル作成ツールは、CRMオブジェクト(会社・コンタクト・チケット)、セールスオブジェクト(取引・リード・見積もり)、カスタムオブジェクトの全体構成を1画面で俯瞰できる機能です。データを入れ始める前に、ここで図を描いておくことをおすすめします。
HubSpotの強みは、コンタクト・会社・取引・チケットが相互に紐づくリレーションデータベースである点にあります。スプレッドシートで顧客リストと担当者マスターを別々に持つと、どうしても差分が生まれますが、関連付けで表現すれば実体は1つです。カスタムオブジェクトを足すときも、この思想は変わりません。「この新しいテーブルは、既存のどのオブジェクトと、どちら向きに紐づくのか」を先に決めます。
なお、リレーションデータベースを持つCRMであれば同様の設計思想は成り立ちます。HubSpot固有の話ではなく、データ構造の一般論として押さえておくと、既存システムとの役割分担も判断しやすくなります。Salesforceでオブジェクトとリレーションを設計した経験がある方であれば、ほぼ同じ感覚で理解いただけるはずです。
各オブジェクト間の関連付け(アソシエーション)には制限を設定できます。たとえば「1つの請求に対して商品マスターは1つ」「1つの商品から請求は複数紐づけ可能」といった1対多の関係を明示的に定義できます。ここを空けたままにしておくと、現場が善意で多対多に紐づけてしまい、レポートの件数が合わなくなります。
Data Hubのプランでは、データ品質管理機能も利用できます。たとえば次のことが可能です。
とくに見ていただきたいのがフィルレートです。フィルレートが1%以下のプロパティは、実質的に使われていない項目と判断できます。SFAあるあるで、全然使っていない項目が大量にあり、実際に使われているのはごく一部というケースは珍しくありません。項目が少ないほうが担当者は集中できますので、定期的にフィルレートを確認して不要なプロパティを整理する運用を、四半期に一度などのサイクルで仕組みに組み込んでおくとよいかと思います。
データ構造が決まったら、次は現場が触る画面です。取引やコンタクトの詳細画面は、デフォルトのままでは使いにくいと感じられるケースもあり、ここを整えることで入力率の改善が見込める場合があります。人に「ちゃんと入力してね」と言うより、画面の側を変えるほうが伝わりやすいケースが多いです。
レコード画面の歯車アイコンから、画面構成そのものを変更できます。左カラムの案件情報や契約情報、中央カラムのスコアやレポート埋め込み、右カラムの関連付け表示——これらをドラッグ&ドロップで自由に配置できます。使わないセクション(プレイブックなど)を下部に移し、よく使うセクション(商品項目など)を上部に置くだけで、営業担当者の操作手数を減らせるケースがあります。
さらに条件付きロジックを使えば、パイプラインや事業部によって表示項目を切り替えられます。セールスパイプラインでは契約情報セクションを表示し、不動産パイプラインでは非表示にする、といった制御です。1つのポータルで複数事業を運用している場合、この機能があるかどうかで現場の納得度がかなり変わってきます。
レコードの「複製」は、既存の案件を丸ごとコピーする機能です。受注後にクロスセル案件を作る場合など、金額・会社・コンタクトの関連付けを維持したまま新規案件を作れます。
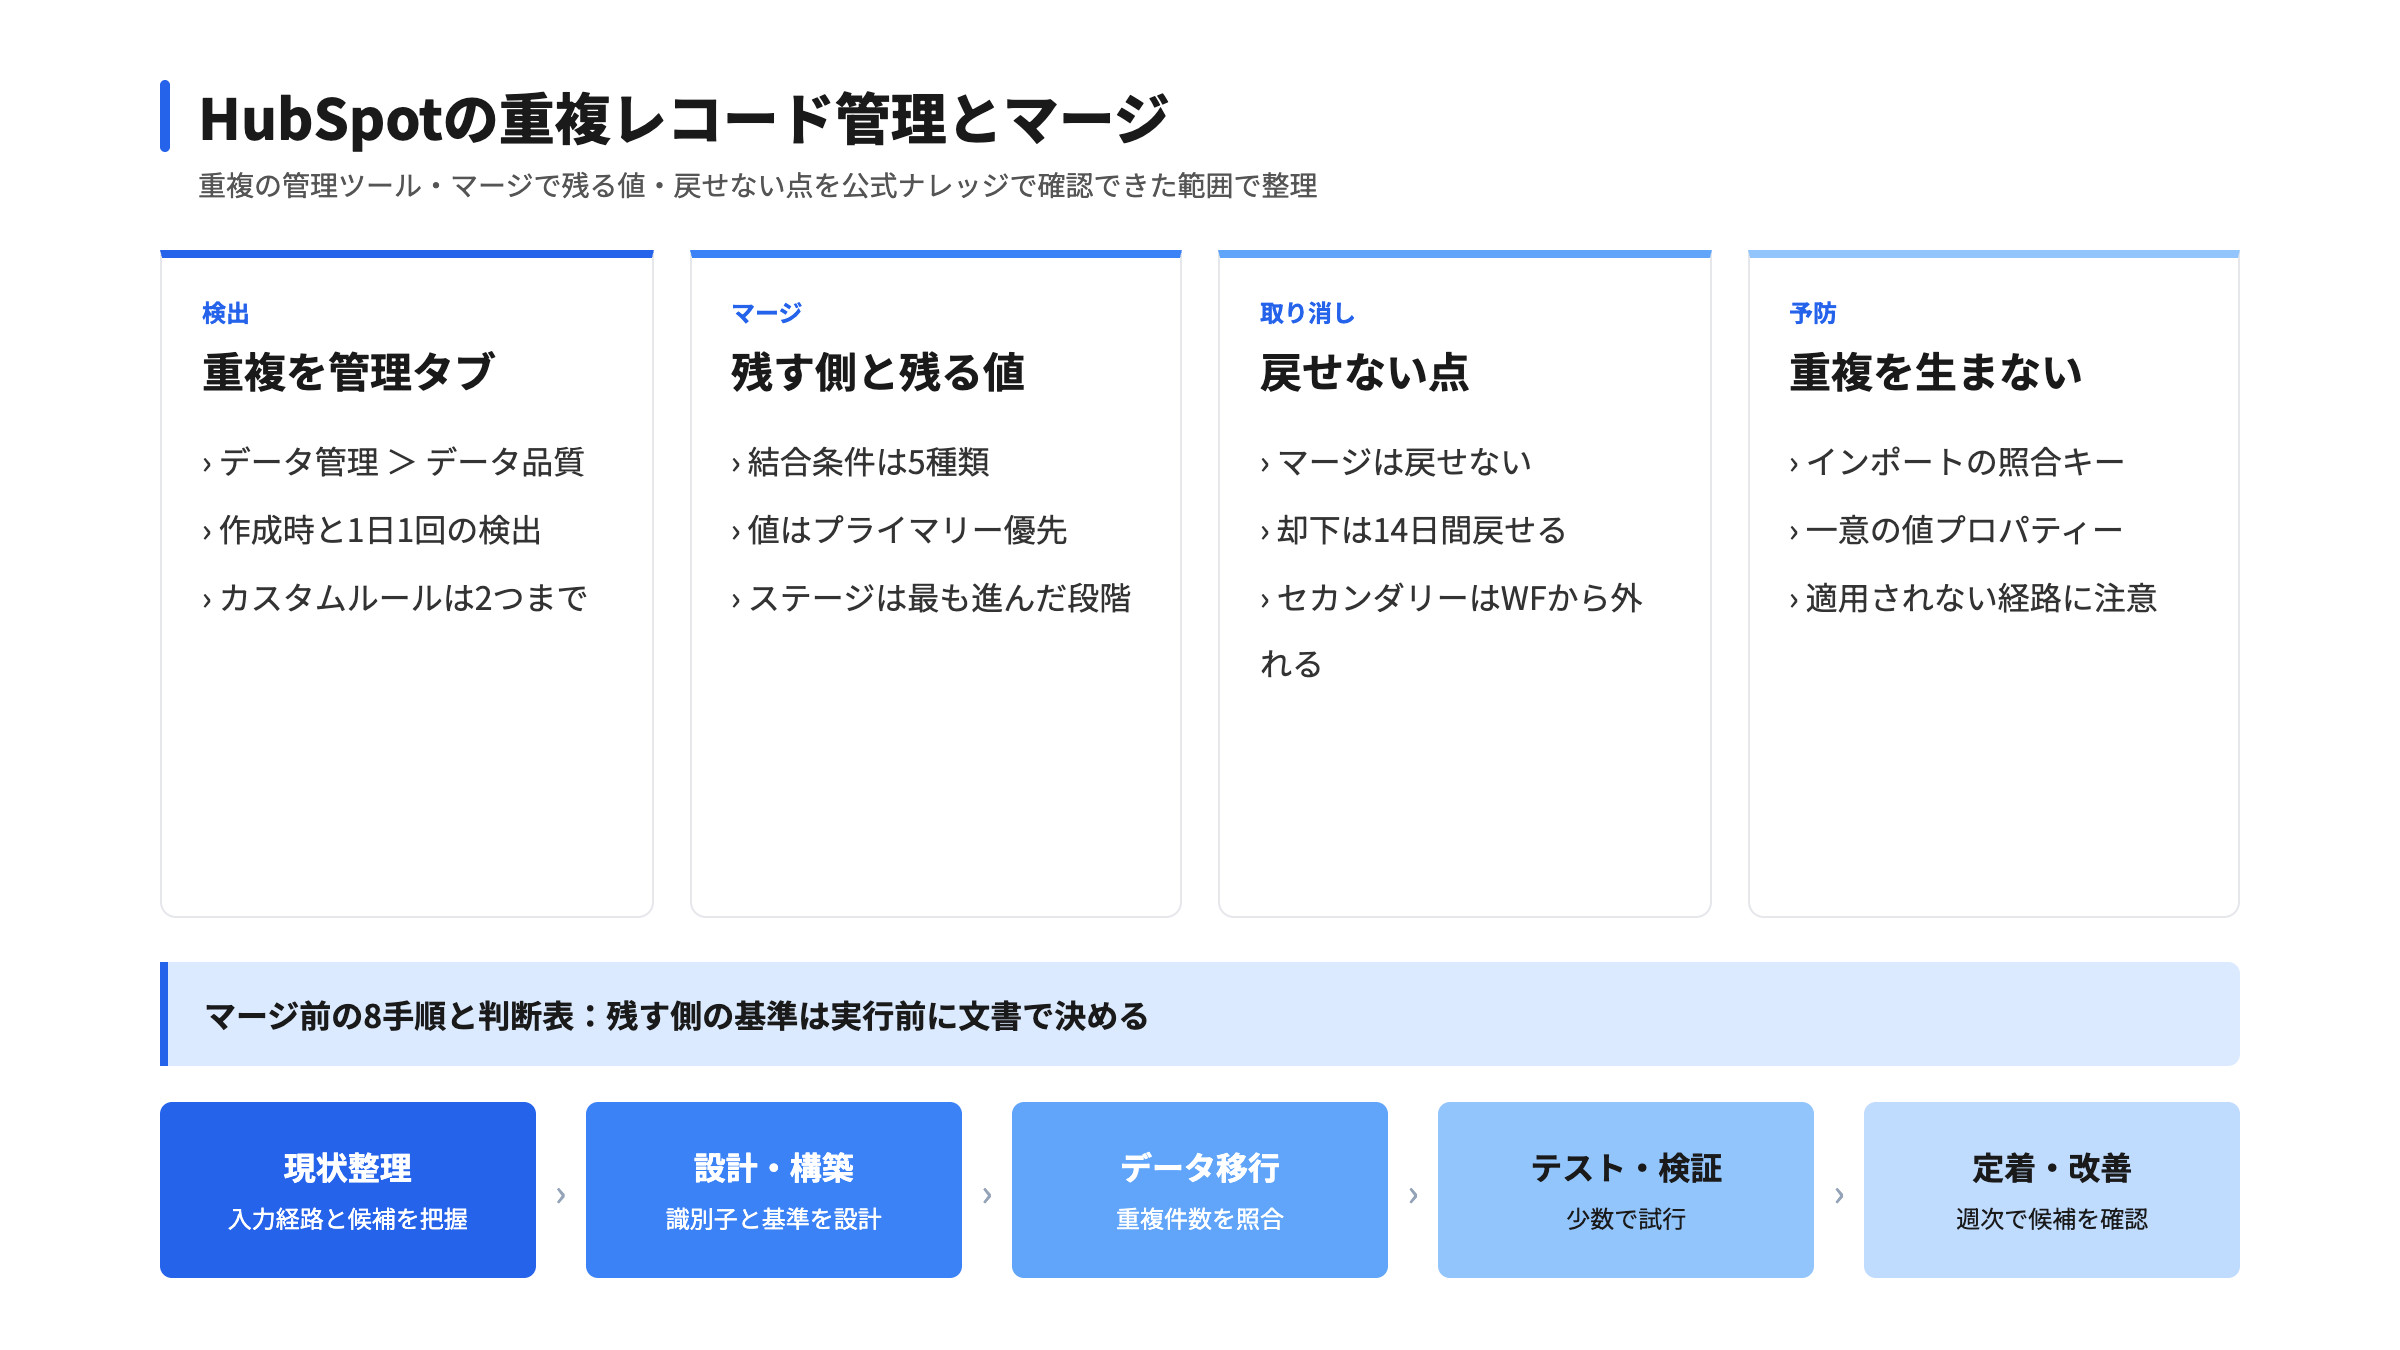
「マージ」は重複レコードを1つに統合する機能です。2つのレコードのどちらの情報を優先するかをプロパティ単位で選択でき、マージ後は両レコードに紐づいていた関連付けが新しいレコードに統合されます。マージ履歴も記録されるため、後から確認可能です。データ品質管理の重複検出とセットで、月次のクレンジング作業として定着させるのがおすすめです。
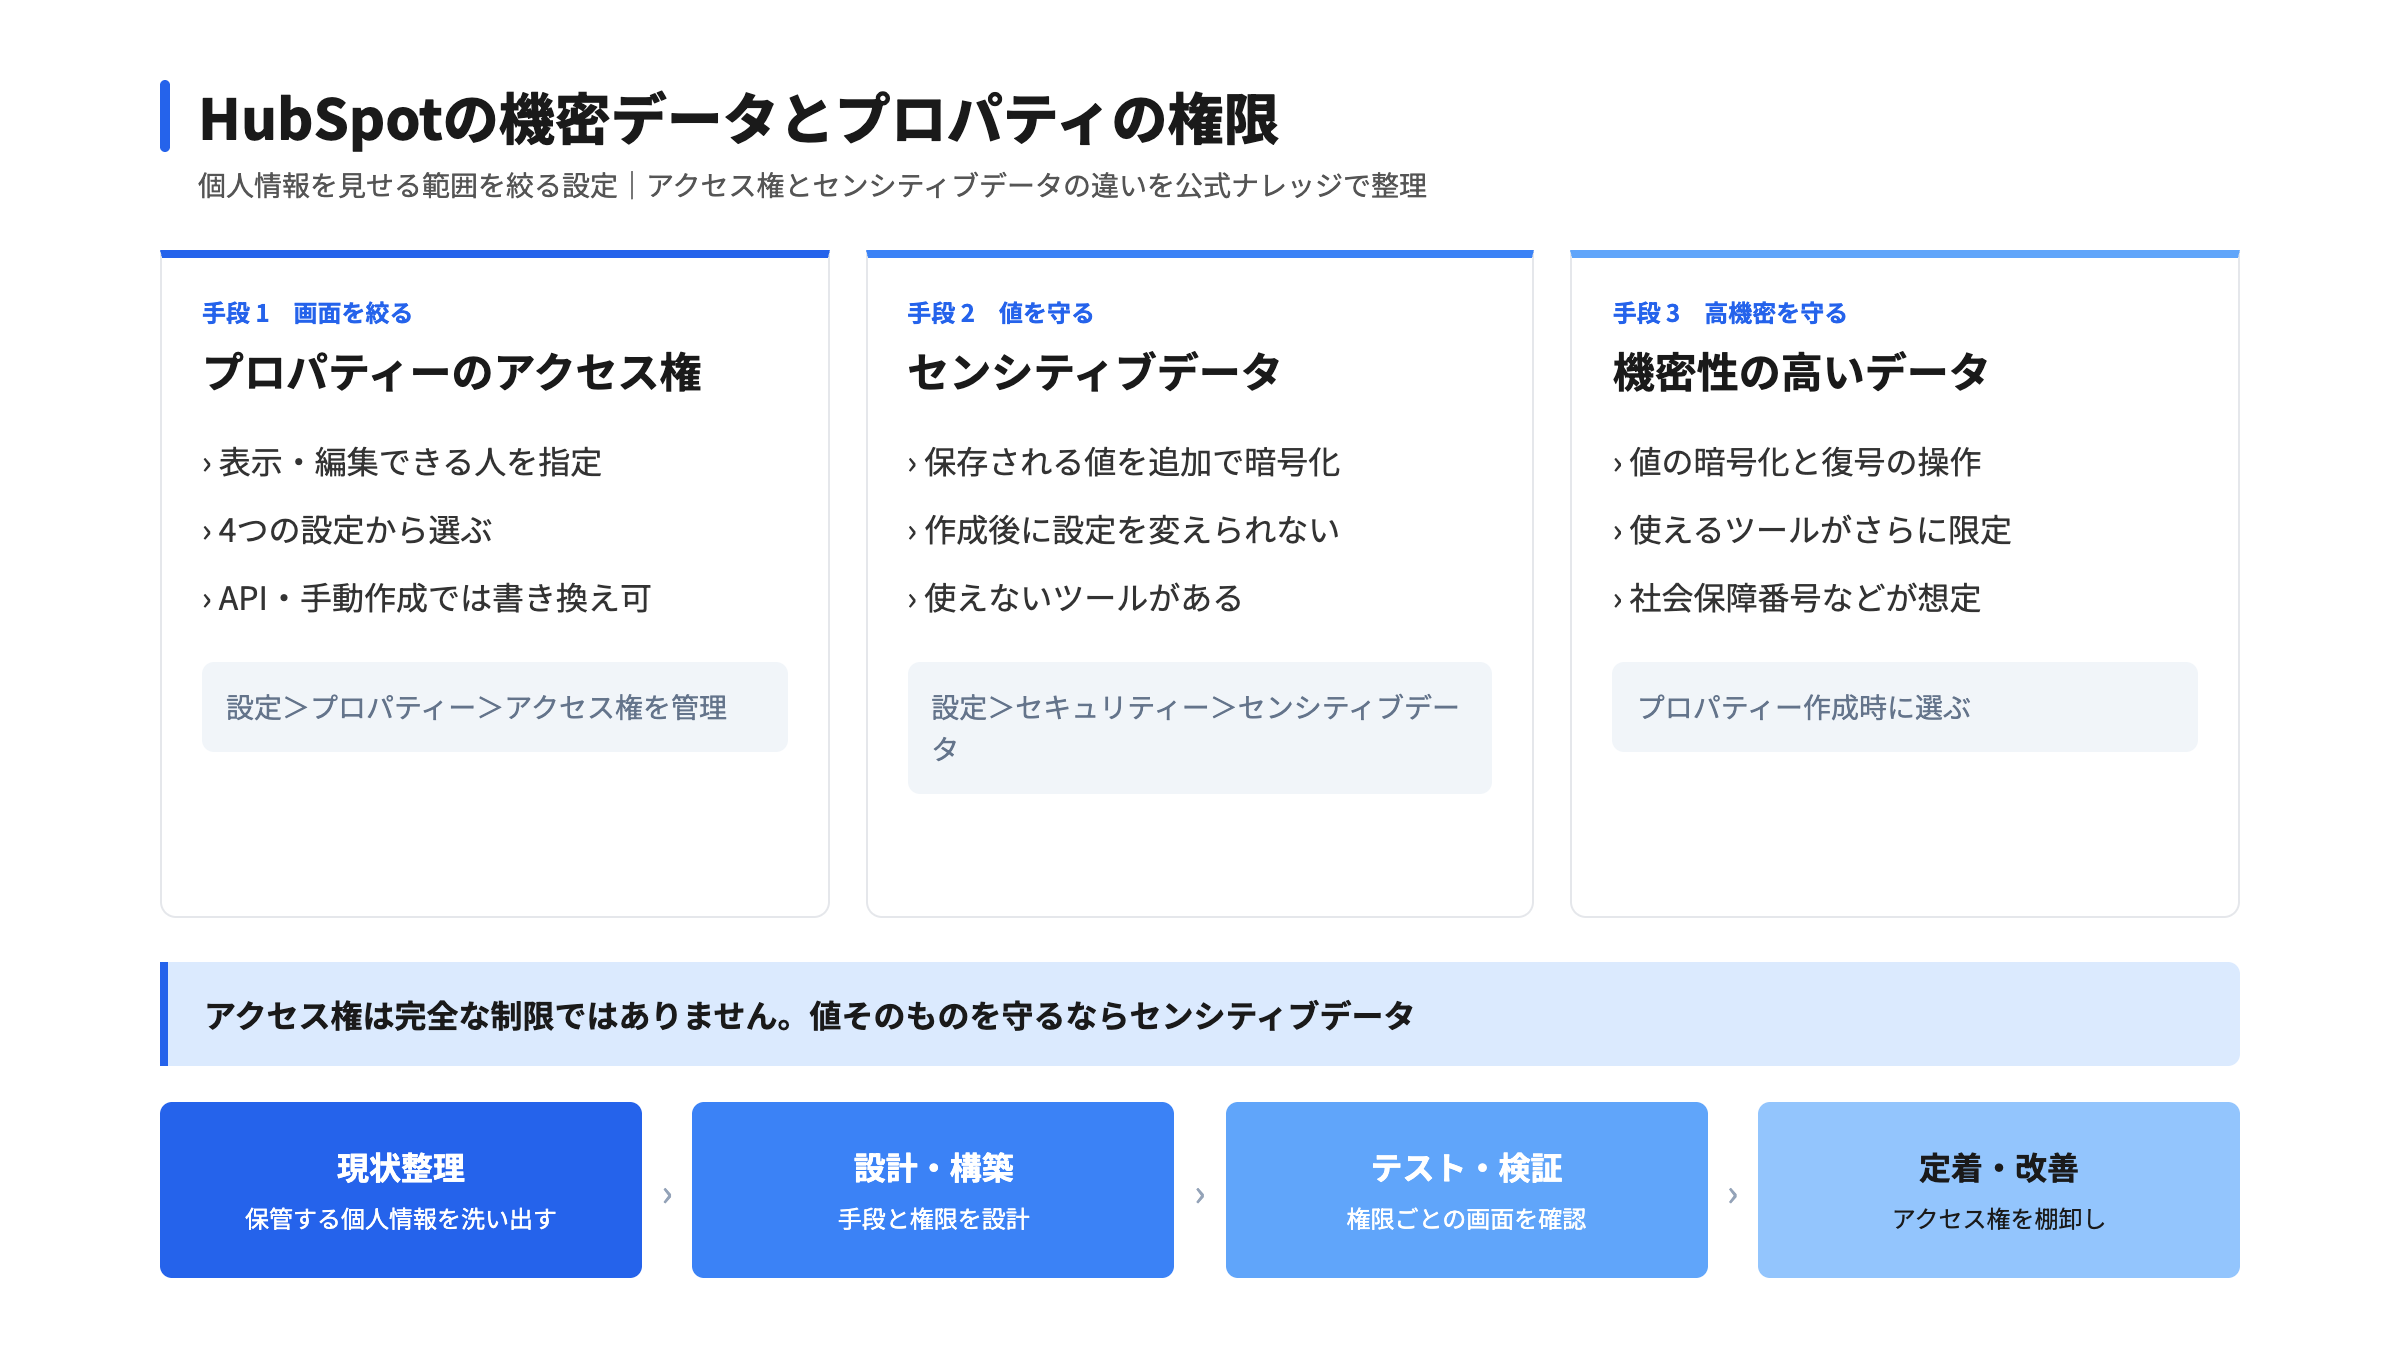
権限設計は、データ構造と同じくらい運用の安定性を左右します。HubSpotではユーザーをチーム単位で管理でき、営業チーム、マーケティングチーム、カスタマーサクセスチームなど組織構造に合わせてデータのアクセス権限を設定できます。
権限セットは、ユーザーに付与する権限のテンプレートです。「営業担当者用」「マネージャー用」「管理者用」を事前に作っておけば、新規ユーザー追加時にセットを選ぶだけで適切な権限が設定されます。新しいメンバーが入るたびに管理者が個別に権限を考える運用は、どうしてもどこかでブレが出てきますので、テンプレート化しておくことが仕組み化そのものです。
| 制御対象 | 設定できること | 主な目的 |
|---|---|---|
| CRMオブジェクト | 作成・編集・削除の可否 | 誤削除や想定外の編集を防ぐ |
| プロパティ | 特定プロパティを特定チームにのみ表示 | 原価や個人情報などの取り扱い制御 |
| パイプラインステージ | 特定ステージへの移動を制限 | 受注計上のルールを守る |
| ユーザー追加 | CSVによる一括追加、通知プロファイル | オンボーディングの効率化 |
プロパティ設定自体を管理者のみ変更可能にしておくと、無駄なプロパティの増殖も抑えられます。現場が自由に項目を追加できる状態は、一見柔軟ですが、半年後にフィルレート1%の項目が並ぶ原因になります。
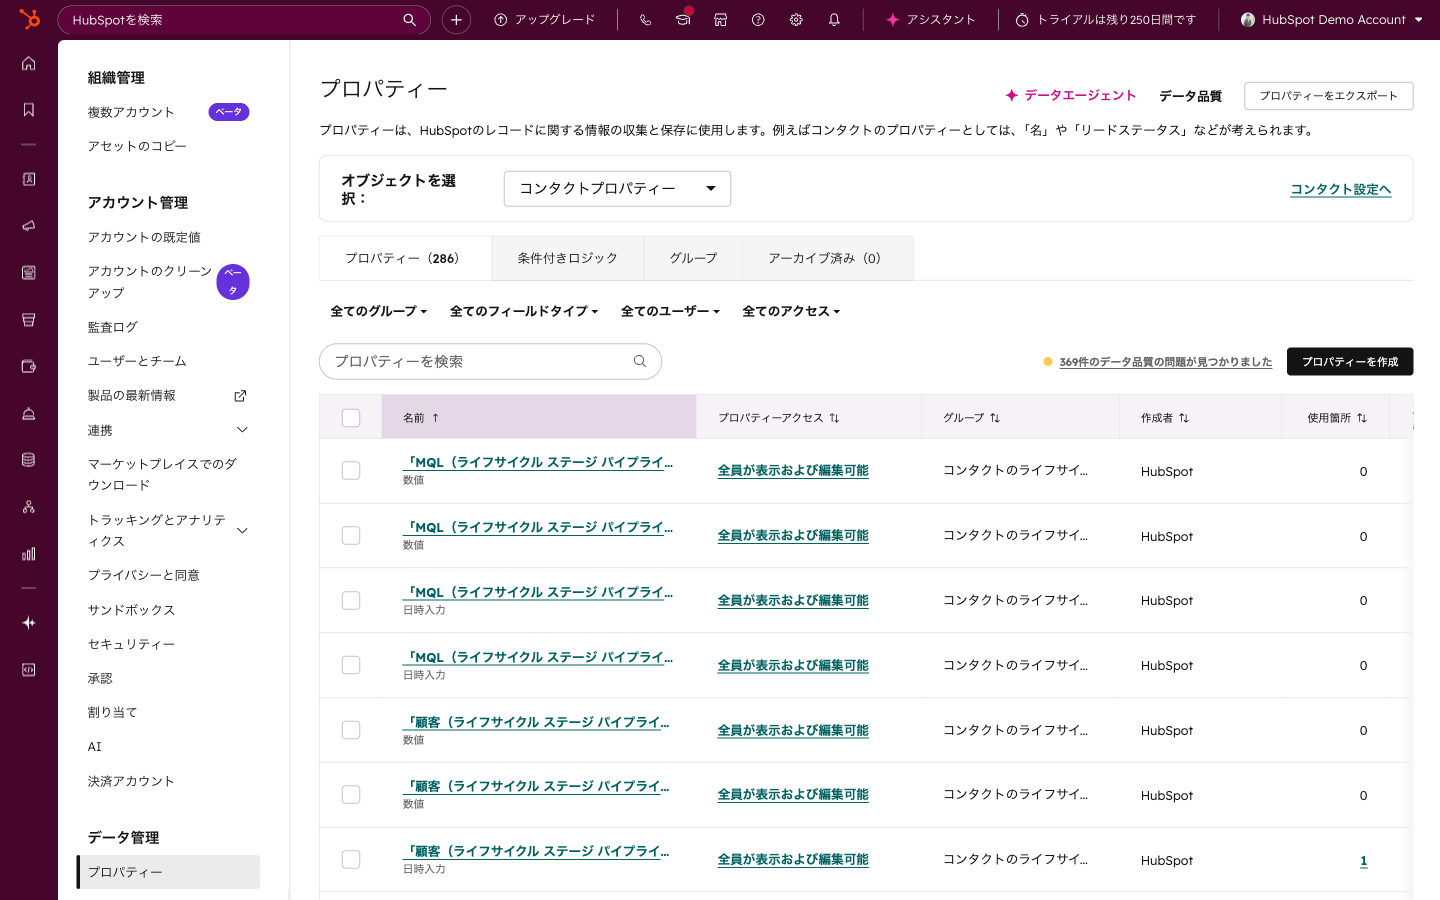
以下の画面は、コンタクトのプロパティ一覧です。どのプロパティを誰に見せるかという設計は、こうした一覧の単位で考えていくことになります。
応用フェーズでよく起きるのが、ワークフローの増殖です。判定や転記のために作ったワークフローが数十本になり、どれが何をしているか誰も把握できない——という状態です。同期プロパティと計算プロパティは、この問題をデータ側で解く手段になります。
同期プロパティは、関連付けられたレコードから特定の値を自動コピーする機能です。コンタクトに「同期会社名」プロパティを作れば、関連付けられた会社の会社名が自動的にコピーされます。
手動入力による表記揺れを防ぎ、マスターデータ(会社オブジェクト)の値を正として各オブジェクトに展開できる点が本質的な価値です。Salesforceの数式フィールドに近い概念と考えていただくと、経験者の方には伝わりやすいかと思います。1つのコンタクトに複数の会社が関連付いている場合は、直近に関連付けられた会社や最終作成の会社など、優先ルールを設定できます。
計算プロパティは、関数(IF文、CONTAINS、IS_KNOWNなど)を使ってプロパティ値を自動計算する機能です。
たとえば「姓(ラストネーム)に値があればtrue、なければfalse」というロジックをワークフローで実装している企業は多いのですが、これは計算プロパティ1つで置き換えられます。計算プロパティはリアルタイムで更新されるため、ワークフローのメンテナンスが不要になり、ワークフローの本数そのものを減らせます。レポート用のグルーピング(条件AならカテゴリX、条件BならカテゴリY)にも活用できます。
| 目的 | ワークフローで実装した場合 | 計算プロパティで実装した場合 |
|---|---|---|
| 値の有無による判定 | 登録・編集トリガーの設計が必要 | 関数1つ、常に最新の値 |
| レポート用の分類 | 分岐ごとにアクションを追加 | 条件式でカテゴリを返す |
| 保守 | 本数が増えるほど把握が困難 | プロパティ設定を見れば完結 |
| 過去データへの適用 | 再実行や一括登録が必要な場合がある | 定義時点の条件で評価される |
ただし、すべてのロジックが計算プロパティで置き換えられるわけではありません。通知やメール配信、担当者の割り当てなど「アクションを起こす」処理はワークフローの領域です。判定と加工はプロパティ、アクションはワークフローという切り分けを社内ルールにしておくと、設計の迷いが減ります。
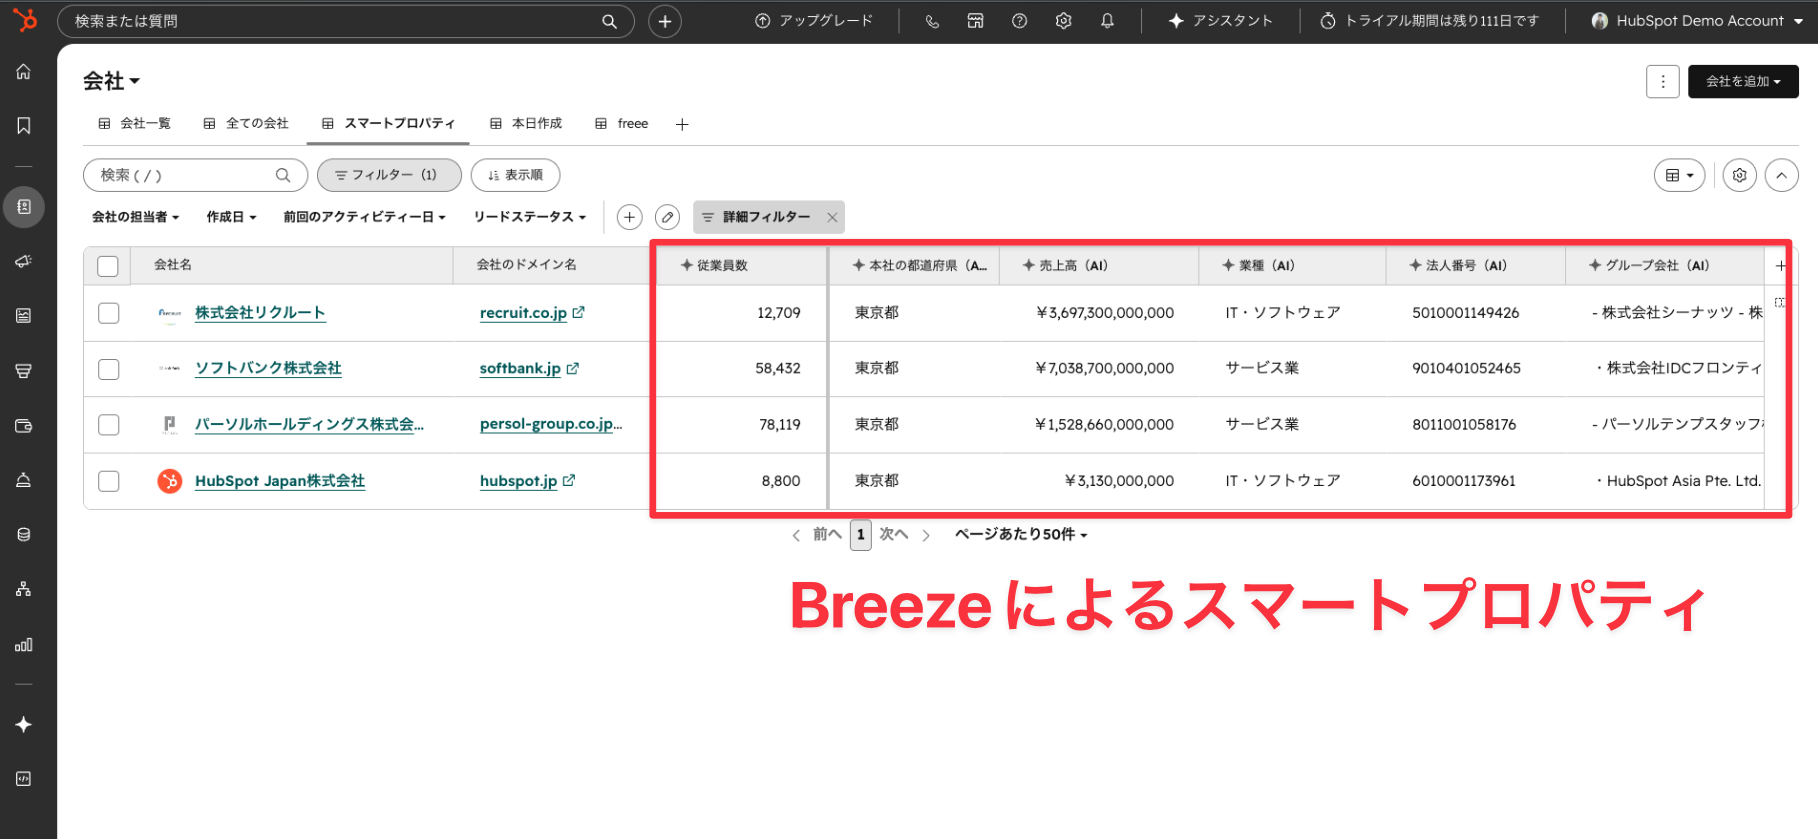
入力項目を減らすもう一つのアプローチが、自動補完です。スマートプロパティは、ウェブ上の情報を自動収集してHubSpotのプロパティに格納する機能で、プロンプトを設定することで会社のウェブサイトやプレスリリースから関連URL、年間売上高、従業員数、ウェブサイトの概要などを取得・整理できます。
Breeze Intelligenceは、外部データソースを活用してCRMのコンタクト・会社データを自動的に補完・更新する機能です。データエンリッチメント自体は、Starter以上のプランではHubSpotクレジットを消費しません(購買意向データ〈バイヤーインテント〉はHubSpotクレジットを消費します)。利用にはデータエンリッチメントのユーザー権限が必要です。
以下の画面は、スマートプロパティで会社の属性情報が自動入力された結果です。エンリッチメントで補完される企業属性は、こうした会社レコード上のプロパティとして蓄積され、リスト作成やレポートのグルーピングに使えるようになります。
AI機能は、使えるかどうかより「どこまで任せるか」を先に決めたほうがうまくいきます。私たちの基本スタンスは、AIは超一流の担当者というより、リサーチと下書きをしてくれるアシスタントに近い、という捉え方です。この前提で役割分担を決めていきます。
| 層 | 機能 | 主な用途 |
|---|---|---|
| ワークフロー内AI | テキストの要約・翻訳、フリーテキストからのデータ抽出 | 問い合わせ内容の分類、レコードの整形 |
| アシスタント | Breezeアシスタント(CRMデータ・社内ドキュメント参照) | 社内ナレッジを踏まえた回答、壁打ち |
| カスタムLLM連携 | ワークフローから外部LLMを呼び出し | 自社固有のプロンプトによる分析・スコアリング |
| エージェント | 案件創出・コンテンツ・顧客対応・SNSなど | 特定業務の自律的な実行 |
4つの層は、それぞれ次のとおりです。
| AIに任せやすい | 人が判断すべき |
|---|---|
| 問い合わせの分類・要約 | データモデルとパイプラインの設計 |
| 企業情報のリサーチと補完 | プロパティを増やすかどうかの意思決定 |
| パーソナライズメールの下書き | 最終的な送信可否の判断 |
| データのクレンジング・カテゴリ付け | 大型案件へのアプローチ方針 |
| ワークフローの初期案作成 | プロンプトの設計とチューニング |
運用上、私たちがお客様にいつもお伝えしているのは、送信系のアクションは人のレビューを挟むという原則です。AIが自動で送信する設定はリスクがありますし、確度が高い案件や規模の大きい案件ほど、リサーチはAIに任せても文面は自分で書くべきだと考えています。
プロンプトに「丁寧語で、日本のビジネス文書の作法に沿って」といった指示を明示的に入れておくと、出力の安定性が上がります。
ワークフローを初めて組む方であれば、AIに初期案を作らせてから手動で調整する、という使い方から入ると取っ掛かりがつかみやすいかと思います。
応用フェーズのゴールは、機能を増やすことではなく「HubSpotを見れば全部わかる」状態を作ることです。レポートの拡張機能と外部アプリ連携は、その最後のピースにあたります。
HubSpotのダッシュボードには、グラフだけでなくテキストや画像を埋め込めます。「ダッシュボードテキスト」機能を使えば、レポートの説明文や運用ルールをダッシュボード上に直接記載できます。指標の定義が書かれていないダッシュボードは解釈がブレますので、各レポートの下に定義を1行添えておくだけでも会議の質が変わります。
さらに、GoogleスプレッドシートやGoogleスライドといった外部コンテンツも埋め込めます。HubSpotのレポート機能だけでは表現しきれない分析やプレゼン資料を、ダッシュボード上で一元管理できるため、経営層や他部門向けのダッシュボードにHubSpotデータとGoogle Workspace上の資料を統合して表示する、といった運用が可能です。
| 連携先 | できること | 向いているケース |
|---|---|---|
| Slack | 取引のステージ変更やフォーム送信をチャンネルに自動通知。ワークフローからの条件付き通知も可能 | 商談の動きを営業チーム全体で即座に共有したい |
| Googleスプレッドシート | ワークフローのアクションとして行を追加 | 既存のシートベース報告フローを残したまま自動化したい |
| Zoom | ウェビナー登録者・参加者をコンタクトとして作成・更新。録画データも参照可能 | ウェビナー後の後追い営業をCRM上で完結させたい |
| Zapier・Yoom | マーケットプレイスにない外部サービスとノーコードで接続 | 業種特化ツールや国内サービスとつなぎたい |
ここでも原則は同じで、全部つなぐ必要はありません。通知が多すぎると誰も見なくなりますし、連携が増えるほど障害時の切り分けが難しくなります。まずは「情報が分散していて確認に時間がかかっている経路」を1つ選んで連携する、という進め方をおすすめしています。
レポートの拡張機能やアプリ連携は単体で評価するものではなく、コンタクト獲得 → 取引管理 → 顧客化 → 請求・契約管理という全体フローの中でどこを担うかで価値が決まります。たとえばZoom連携はコンタクト獲得の入口、カスタムオブジェクトの請求管理は顧客化の後工程、ダッシュボードはそれら全体の可視化です。レポートで見たい指標から逆算してデータ構造を決めると、無駄なオブジェクトやプロパティが生まれにくくなります。
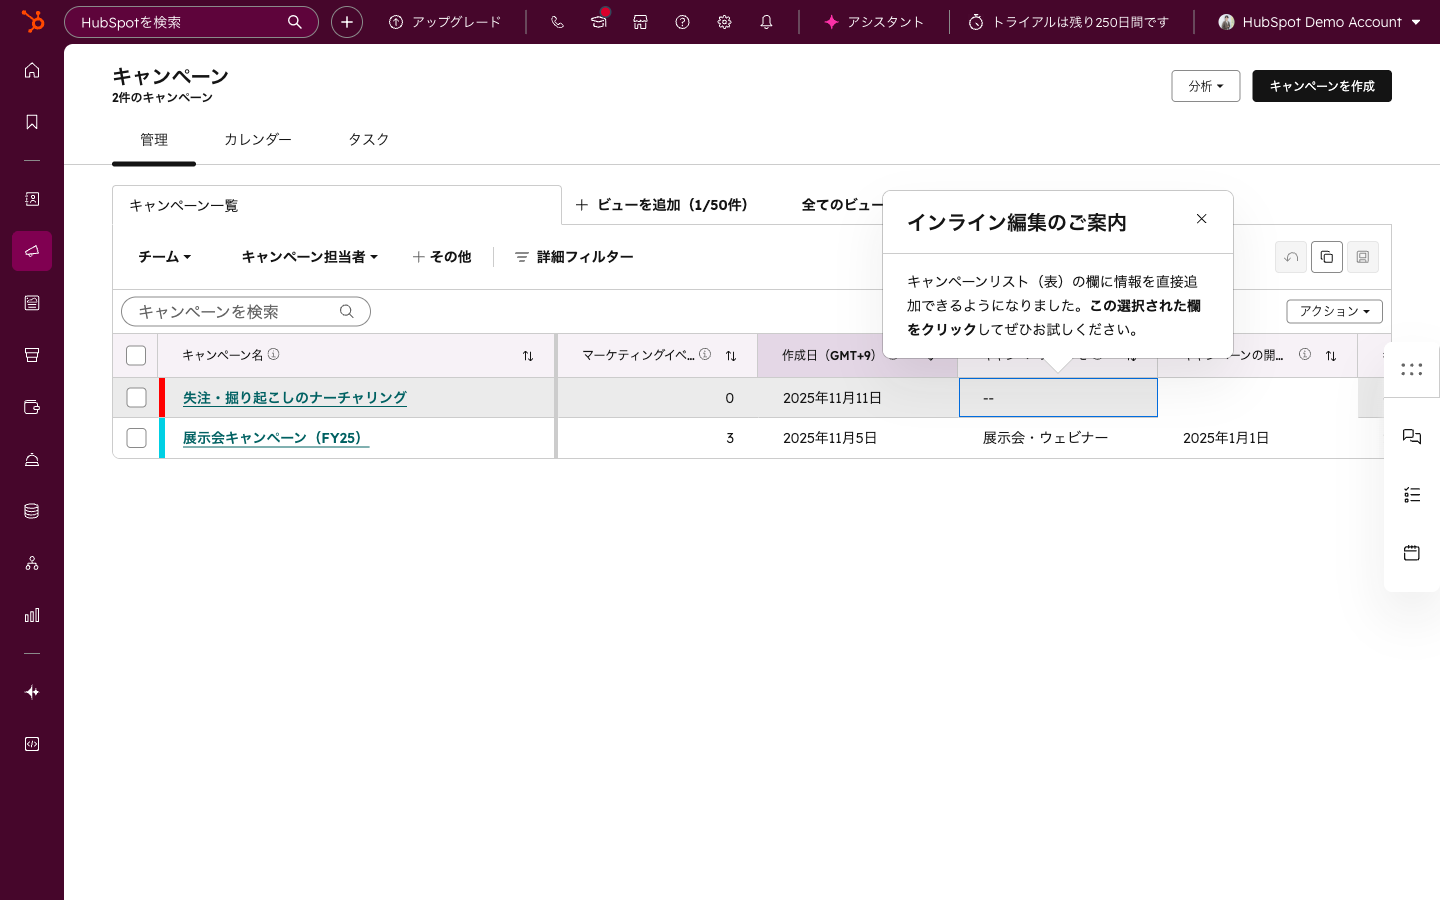
以下の画面は、HubSpotのマーケティングキャンペーン一覧です。キャンペーン経由で獲得したコンタクトがCRMに蓄積され、その先の取引・レポートまでつながっていく流れをイメージいただけるかと思います。
最後は、日々は意識しないけれど事故が起きたときに効く領域です。応用機能でデータ構造を作り込むほど、そのデータを守る設計の重要度も上がります。
HubSpotにはスケジュールバックアップ機能があり、CRMデータの定期バックアップを自動化できます。14日間の保持期間内であれば、バックアップからデータを復元することが可能です。裏を返すと、保持期間を過ぎたものは戻せません。大量インポートや一括編集を行う前にバックアップの状態を確認する、という手順を作業マニュアルに書いておくことをおすすめします。
Enterprise向けのセキュリティ機能として、次の設定が用意されています。
これらは一度設定すれば終わりではなく、人の入れ替わりに合わせて棚卸しする運用とセットで意味を持ちます。権限セットとチームを整備しておけば、この棚卸しも「誰がどのセットに属しているか」を見るだけで済みます。
HubSpotは継続的に機能アップデートを行っています。「設定」→「プロダクトアップデート」から最新の機能追加やベータ機能を確認でき、ベータ機能は事前に有効化して先行利用できます。
ただし、ベータ機能は仕様が変わる可能性があるため、基幹的な業務フローに最初から組み込むのは避けたほうが無難です。影響範囲の小さいところで試し、自社の運用に合うと判断できてから広げる。この順序を守れば、アップデートの速さをリスクではなく利点として享受できます。定期的にアップデートを確認する担当と頻度を決めておくのも、立派な仕組み化の一つです。
Enterpriseプランで利用できる機能です。物件・契約・請求など、標準オブジェクト(コンタクト・会社・取引・チケット)では管理しきれないデータをテーブルとして構造化でき、作成後は標準オブジェクトと同様にデータの作成・インポート・プロパティ追加・関連付けが可能です。パイプラインを設定すれば「請求予定→請求実施→入金済み→未入金」のようにボードビューで進捗も管理できます。まずは1オブジェクトに絞って運用が回ることを確認してから、次のオブジェクトを追加する進め方をおすすめします。
計算プロパティへの置き換えが有効です。「姓に値があればtrue、なければfalse」といった判定は、IF文やCONTAINS、IS_KNOWNなどの関数を使った計算プロパティ1つで実現でき、リアルタイムに更新されるためワークフローのメンテナンスが不要になります。レポート用のグルーピングにも活用できます。ただし通知やメール配信、担当者割り当てといった「アクションを起こす」処理はワークフローの領域ですので、判定と加工はプロパティ、アクションはワークフローという切り分けで整理してください。
Data Hubのプランで使えるデータ品質管理機能で、フィルレート(各プロパティの使用率)を確認します。フィルレートが1%以下のプロパティは実質的に使われていない項目のため、整理対象を判断する材料になります。あわせて重複データの検出、類似プロパティのアラート、急激なデータ変更を知らせる異常値検出も利用できます。今後の増殖を防ぐには、プロパティ設定の変更権限を管理者のみに限定する運用が効果的です。
スケジュールバックアップ機能でCRMデータの定期バックアップを自動化しておけば、14日間の保持期間内であればバックアップから復元できます。保持期間を過ぎると戻せないため、大量インポートや一括編集の前にバックアップ状態を確認する手順を作業ルールに入れておくと安心です。あわせてSSOや二要素認証の強制、IPアドレス制限、90日以上操作がないアカウントの自動無効化も設定できます。
原則として「データ構造 → 画面 → 自動化 → AI → ガバナンス」の順です。構造が固まっていない状態で自動化やAIを載せると、前提が変わるたびに作り直しが発生します。ただし、企業様によって最適な順序は異なります。すでにデータ構造が整っていてワークフローの本数が課題という場合は、計算プロパティによる整理から着手するほうが効果を実感しやすいかと思います。
HubSpotの応用機能は、機能のカタログではなく「自社のデータ構造をCRMの中でどう表現するか」という設計の話です。本記事で扱った10領域を整理すると、次のようになります。
まずは、いまスプレッドシートで管理している業務の棚卸しから始めてください。そのうえで、次の3ステップで着手すると無理なく進められます。
いきなり10機能すべてを入れる必要はありません。1つの業務がCRMの中で完結する体験を作れれば、次に何を構造化すべきかは自然に見えてきます。企業様によって最適な構成は異なりますので、自社の業務に合わせた形に落とし込んでいくことが結果的な近道になるかと思います。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。