この記事の結論
企業データ基盤とは、社内のデータを収集・統合し、分析や業務に利用できる状態にする仕組みです。DWHとデータレイクを目的に応じて使い分け、収集から可視化までを一気通貫で設計します。
企業データ基盤とは、社内のデータを収集・統合し、分析や業務に利用できる状態にする仕組みです。DWHとデータレイクを目的に応じて使い分け、収集から可視化までを一気通貫で設計します。
企業データ基盤とは、社内のデータを収集・統合し、分析や業務に利用できる状態にする仕組みです。DWHとデータレイクを目的に応じて使い分け、収集から可視化までを一気通貫で設計します。
「顧客情報はCRM、売上は会計システム、施策の実績はスプレッドシートに分かれている」「会議のたびにExcelを集計し直している」「部門ごとに同じ指標の数値が違う」——こうした状態では、集計作業のたびに定義や対象範囲を確認する必要があり、会議で数字の意味をそろえることから始めなくてはなりません。
企業データ基盤の構築では、データを集める場所より先に、何を判断するか、どのシステムの値を基準にするかを決めます。CRM内で必要な分析ができるなら、その入力とレポートを整えるところから始められます。複数システムのデータを同じ条件で照合する必要があるなら、DWHなどを検討します。
本記事は「データドリブン経営の進め方|データに基づく意思決定を組織に実装するステップ」シリーズの一部です。判断に使う指標とデータの扱い方を整理したうえで、基盤の構成を検討したい方に向けて解説します。
DXのツール選定について体系的に学びたい方は、DXツール・インフラガイドで関連する領域の全体像を確認できます。本記事では、そのうちデータの収集、統合、分析に必要な設計判断を扱います。
企業データ基盤を検討する際に必要な、目的の整理から構成の選択、運用開始後の見直しまでを順に説明します。各方式の特徴に加え、どの差異を解消すれば次の段階へ進めるか、どの条件なら現在の運用を続けるかも確認できます。
最初に決めるのは製品ではなく、データを使って行う判断です。例えば「受注と売上の差を確認したい」という目的なら、受注と売上をそれぞれ何と定義し、どの単位で照合するかを明確にします。この定義が決まると、必要な項目と連携範囲を絞れます。
「差があるかを知りたい」だけでは、取引ごとに照合するのか、顧客ごとの合計を見るのかが決まりません。会議で使う数字を一つ選び、対象とする取引の状態、基準日、集計単位を書き出します。同じ条件で関係者が数字を再現できたら、必要なデータの所在を確認します。
スプレッドシートによる管理は、担当者が対象データと計算方法を把握できる間は有効です。一方、CRMの会社名と会計システムの取引先名が異なる、担当者の変更が一方にしか反映されない、集計ファイルごとに計算式が違うといった差分が生じると、数字の照合に手作業が必要になります。
まず、同じ指標を作る際に各部門が使っているファイルと計算条件を並べます。差が出る原因が入力漏れなら入力ルールを、顧客の結び付け方なら識別子を、計算式なら指標定義を整えます。原因が複数ある場合は、元レコードを確認して差異を種類ごとに記録します。原因を区別できるまでは、集計の自動化だけを進めても数字への疑問は解消できません。
担当者の経験に依存した集計では引き継ぎも難しくなるため、共通の項目定義と連携ルールを残します。どのファイルのどの列を参照し、例外をどう扱ったかまで記載すると、別の担当者も結果を確かめられます。
売上の着地、施策ごとの商談創出、顧客対応の状況など、確認したい判断を選びます。次に、判断に使う指標、指標の計算に必要な項目、項目を保持するシステム、値の更新責任者を順に書き出します。
営業から請求までを捉える場合は、コンタクト、会社、取引、顧客、請求をどの識別子で結ぶか確認します。結び付けられないデータがあれば、その対応方法を決めてから集計に使います。名称が似ているだけのレコードは自動的に同一とみなさず、確認が必要なものとして分けます。CRMを単なる名簿として扱わず、営業プロセスと指標の定義を共有する起点にします。
企業様によって最適な形は異なります。自社の業務と判断目的に照らし、CRM内のレポートで足りる範囲と、ほかのシステムとの照合が必要な範囲を分けて決めます。
データ基盤の役割は、一元管理、自動化、可視化に分けると整理しやすくなります。一元管理では顧客や取引を識別子で結び、自動化では更新時の転記を減らし、可視化では合意した定義で指標を表示します。
| 役割 | 解決する課題 | 設計時に決めること |
|---|---|---|
| 一元管理 | 顧客名や取引情報の重複・不一致 | 基準となるシステム、識別子、マスターデータ |
| 自動化 | CSV出力や転記による更新漏れ | 連携対象、更新方向、実行条件、エラー時の処理 |
| 可視化 | 部門ごとに指標の定義が異なる状態 | 指標の定義、集計単位、更新頻度、閲覧者 |
元データの入力ルールが曖昧なまま集約すると、誤った値も集まります。レポートで差異を見つけたときに元のレコードと更新責任者まで戻れるかを確認し、戻れない場合は入力と連携のルールを先に整えます。
一元管理の対象が決まっていても、更新元が曖昧なら自動化へ進みません。更新元と例外時の担当が決まり、連携後の値を元レコードと照合できたら、自動更新の範囲を広げます。可視化は、その数字を使う人が対象範囲と更新時点を説明できる状態で公開します。
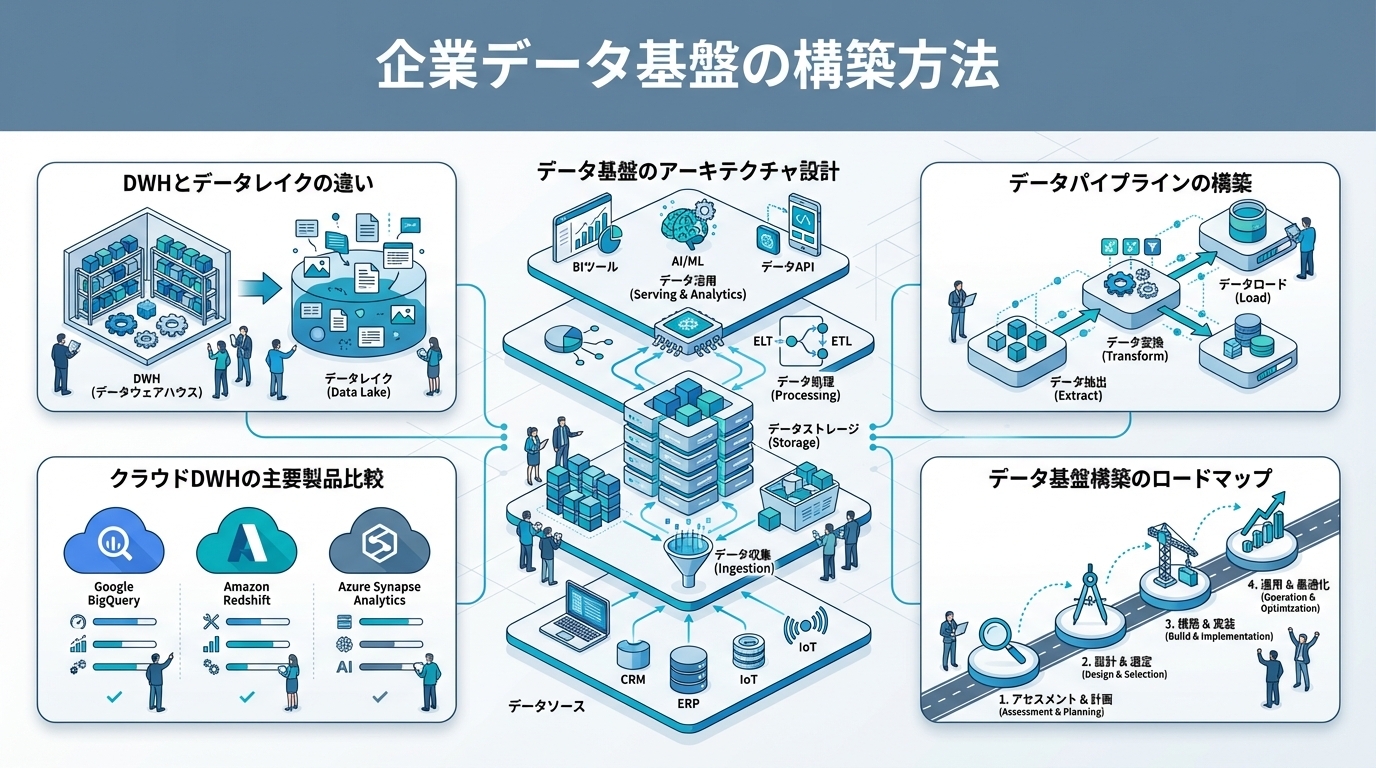
DWHとデータレイクは、保持するデータと利用目的から選びます。定義済みの指標を継続して集計するならDWHが候補です。元の形式に近いデータを保持して探索的に使う目的があるなら、データレイクを検討します。
DWHはデータウェアハウスの略で、分析しやすい形に整理した構造化データを蓄積する仕組みです。売上、商談、顧客、会計など、行と列で扱うデータを共通の定義で集計する用途に向いています。
CRM上の取引金額と会計上の売上を比較するなら、最初に両者の意味の違いを確認します。そのうえで対象期間、集計単位、顧客や取引の識別子をそろえます。同じ条件で再計算でき、差が出たレコードを追跡できることが、継続利用へ進む条件です。
差異が見つかったら、元データに存在しないレコード、識別子が結び付かないレコード、集計条件から外れたレコードに分けて確認します。説明できない差異を残したまま指標を増やさず、まず代表的なレポートの定義を確定します。
データレイクは、構造化データに加え、半構造化データや非構造化データを元の形式に近い状態で蓄積する仕組みです。利用時に読み取り方を決めるため、定型レポートの対象に限らないデータを保持する用途があります。
ただし、保存目的や管理ルールが曖昧なまま集めると、利用できるデータと確認前のデータを区別しにくくなります。保管対象、利用者、更新日の確認方法、削除方針を決められない場合は、用途が定まっているデータの整理を先に進めます。
形式の異なるデータを残す必要がある場合も、「誰が何を確かめるために使うか」を先に示します。利用時の読み取り方と管理責任者を決められたデータから扱い、目的を説明できないデータの収集は保留します。
| 比較項目 | DWH | データレイク |
|---|---|---|
| データの種類 | 構造化データ | 構造化+半構造化+非構造化 |
| スキーマ | 事前定義(Schema on Write) | 利用時定義(Schema on Read) |
| 用途 | 定型的な分析・レポーティング | 探索的分析、機械学習 |
| データ品質 | クレンジング済みの高品質データ | 生データを含む |
| ユーザー | 経営層、ビジネスアナリスト | データサイエンティスト、エンジニア |
| コスト | 中〜高 | 低〜中 |
表は用途を整理するための比較です。コスト欄の区分だけで費用の大小は判断できません。実際の比較では、保存、処理、転送、監視、運用を同じ範囲で見積もり、何を含めた費用かをそろえます。
DWHとデータレイクを組み合わせるレイクハウスも選択肢です。DatabricksやDelta Lakeなどを検討する場合も、まず利用者が必要とする集計とデータの種類を書き出します。DWHで目的を満たせるならその構成を検証し、別のデータの保持や利用が必要になった時点で構成を見直します。見直しの際は、追加するデータの利用目的と、現在の構成では扱いにくい理由を明確にします。
システム間でどの項目を受け渡すかを決める際は、API連携とシステム統合の設計も参照してください。連携先を選ぶ前に、更新元、更新方向、失敗時の扱いを整理するための観点として役立ちます。
クラウドDWHの比較では、保存と集計を担う製品に加え、データを取り込む工程も確認します。表に挙げる取り込み・連携ツールは検討対象の例です。表中の接続先、機能、価格に関する記載は選定時の確認項目とし、採用判断の前に提供元の最新情報と自社の利用条件を照合します。まずは必要なデータを取得できるか検証します。
| ツール | 特徴 | 価格 |
|---|---|---|
| Fivetran | マネージドETL、300+コネクタ | 従量課金 |
| Airbyte | オープンソース、自前運用可 | 無料〜 |
| trocco | 日本製、国内SaaS対応 | 月額5万円〜 |
| Stitch | シンプル、Talend傘下 | 従量課金 |
| 製品 | 提供元 | 特徴 | 価格モデル | 適する企業 |
|---|---|---|---|---|
| BigQuery | Google Cloud | サーバーレス、SQL対応、高速 | 従量課金(クエリ量) | 全規模 |
| Snowflake | Snowflake | マルチクラウド、コンピュートとストレージ分離 | 従量課金(使用量) | 中堅〜大企業 |
| Amazon Redshift | AWS | AWS統合、高パフォーマンス | 固定+従量 | AWS環境の企業 |
| Azure Synapse | Microsoft | Microsoft統合、PaaS | 従量課金 | Microsoft環境の企業 |
表の特徴や価格モデルだけで結論を出さず、同じデータ範囲と集計条件で候補を比較します。担当者が必要な権限を管理できるか、既存のBIツールで結果を確認できるか、利用量を把握できるかまで確かめます。
比較用のレポートは、参照する元データ、変換条件、表示する指標を共通にします。結果が異なった場合は、製品の優劣を決める前に、取り込んだレコードの範囲と計算条件を確認します。そのうえで、日常の更新確認とエラー対応を担当できる構成を選びます。
BigQueryの費用を試算する場合は、BigQueryの料金で該当する処理と保存の課金条件を確認します。ほかの候補も同じ利用条件で見積もり、料金表の一項目だけを比較しないようにします。
BigQueryを候補にする場合は、必要なデータを取り込めるか、担当者がSQLで指標を再現できるか、Looker Studioなど利用予定の画面で結果を確認できるかを検証します。
代表的なレポートを一つ選び、参照する期間、列、更新方法を決めて実行します。結果が元データと照合でき、利用量と運用担当を把握できれば候補に残します。既存のAWSやMicrosoft環境との接続が判断を左右する場合は、同じレポートを条件にほかの製品も比較します。
検証結果には、集計値だけでなく、更新が失敗したときの確認場所と対応者も残します。レポートは作れても運用時の差異を追えない場合は、構成を確定する前に確認手順を整えます。
選定表には機能と費用に加え、日常の更新確認、権限管理、エラー対応を誰が担うか記載します。検証中に集計値の差が出た場合は、製品の評価を進める前に、元データ、変換条件、指標定義のどこで差が生じたか確認します。
CRMの標準レポートで必要な指標を確認できるなら、その運用を続けます。会計など複数システムのデータを同じ条件で集計する必要が明確になった時点で、DWH導入を判断します。
照合前のデータに重複や表記揺れがある場合は、データクレンジングの方法も参照してください。どの値を修正し、どの値を例外として残すかを決めてから連携設計へ進めます。
データ基盤は、データソース、データ統合、データ活用の流れで整理します。データが発生した場所からレポートの数字までたどれるように、各工程の入力、処理、出力を記録します。
| 層 | 役割 | 構成要素 |
|---|---|---|
| データソース層 | データの発生源 | CRM、ERP、Webサイト、SaaS各種 |
| データ統合層 | 収集・変換・格納 | ETL/ELTパイプライン、DWH |
| データ活用層 | 分析・可視化・活用 | BIツール、機械学習、レポート |
データソース層では、各項目の基準となるシステムを決めます。統合層では、識別子の対応、変換条件、更新失敗時の扱いを定義します。活用層では、誰がどの数字を見て何を判断するかを決めます。利用目的のない項目は、取り込む前に必要性を見直します。
設計図には、データの流れとともに、差異が起きたときの確認順序も記載します。表示した数字から変換結果、取り込み結果、元レコードへ戻れれば原因を調べられます。途中で追跡が切れる場合は、その工程の記録方法を決めてからレポートの利用範囲を広げます。
| 方式 | 処理順序 | 特徴 | 適する場面 |
|---|---|---|---|
| ETL | Extract→Transform→Load | 変換してからDWHに格納 | データ品質を重視 |
| ELT | Extract→Load→Transform | まずDWHに格納し、DWH上で変換 | BigQuery等のクラウドDWH向け |
ETLを選ぶなら、格納前に確定すべき変換と、失敗したデータの退避先を決めます。ELTを選ぶなら、生データと変換済みデータを分け、レポートが参照するデータを固定します。どちらも、元データと表示結果を照合できることが必要です。
判断の分かれ目は、どの工程で変換結果を確認したいかです。格納前に不備を判定する運用なら、失敗時に元レコードへ戻る手順を確認します。格納後に変換する運用なら、確認前のデータがレポートに混ざらないよう、参照先を明確にします。
dbtを変換工程の候補にする場合は、指標の計算条件を共有し、変更時にどのレポートへ影響するか確認できるようにします。処理方式はツール名から決めず、変換を行う場所と運用担当者から選びます。
会社名や担当者名には表記揺れがあるため、名称だけでデータを結合しません。CRMの会社ID、取引ID、会計システムの取引先IDなどを対応表で管理し、対応先を決められないレコードは例外として確認します。
マスターデータには、項目名、定義、入力元、更新責任者、更新頻度を記載します。識別子が重複した場合や対応先が見つからない場合の処理も決めます。代表的なレコードで結合結果を確かめてから、対象範囲を広げます。
対応表を更新するときは、誰が根拠となる元レコードを確認し、変更を承認するかも決めます。同じ取引先に複数の対応先が見つかった場合は自動で選ばず、業務上の関係を確認します。この例外を処理できることが、定常的な集計へ進む条件です。
AIによるデータ分析の自動化を検討する場合も、先に指標とデータの定義を整えます。分類や要約の結果を使う前に、人が元データへ戻って確認できる方法と、結果を採用する判断者を決めます。
CRMデータの統合では、コンタクトから取引、顧客、請求へ進む業務の流れに沿って、どの情報を照合するか決めます。HubSpot内で確認できる指標と、会計などのデータが必要な指標を分けると、連携範囲が明確になります。
HubSpotでは、コンタクト、会社、取引などを関連付けて管理できます。まず、必要な関連付けと入力項目を整え、標準ダッシュボードで確認したい指標を作ります。数値から対象レコードへ戻れるかも確かめます。
会計データとの照合が必要になったら、CRMと会計でそれぞれ何を基準値とするか決めます。HubSpot APIや連携ツールを利用する構成を検討する際は、取得対象、更新方法、利用する権限を確認します。CRMとデータウェアハウス連携の設計も、CRM側の項目と横断分析の対象を整理するために参照できます。
例えば取引と請求を照合するなら、取引のどの状態を対象にするか、請求と結び付かない取引をどう扱うかを先に決めます。対象外の理由を説明できない場合は、連携項目を増やす前に業務上の対応関係を確認します。
以下は、HubSpotとfreeeのデータを収集し、BigQueryで照合して可視化する場合の構成例です。表にある製品やAPIを組み合わせる場合は、必要なデータの取得方法と接続条件を個別に確認します。構成を決める前に、各工程の完了をどう判断するか明確にします。
| 工程 | 使用する構成例 | 完了の判断 |
|---|---|---|
| 収集 | HubSpot API、freee API、Fivetran | 対象データが欠損なく取得されている |
| 格納 | BigQuery | 元データを更新日時とともに参照できる |
| 変換 | dbt | 顧客や取引を共通の識別子で結合できる |
| 可視化 | Looker Studio、Tableau | 定義済みの指標を同じ条件で再計算できる |
最初は照合対象を限定し、CRMと会計それぞれの元レコードを確認します。識別子の対応が取れないレコードや集計値の差異を記録し、原因を説明できるようになってからレポートの対象を広げます。
各工程の確認では、収集したレコードが元データの対象範囲と一致するか、変換後に除外したレコードの理由を説明できるか、表示結果から元レコードへ戻れるかを順に見ます。途中で不一致があれば、その工程で止めて確認します。
次の画面は、HubSpotの会社レコードにSync for freeeの連携カードが表示され、freee取引先との連携操作を確認できる状態です。
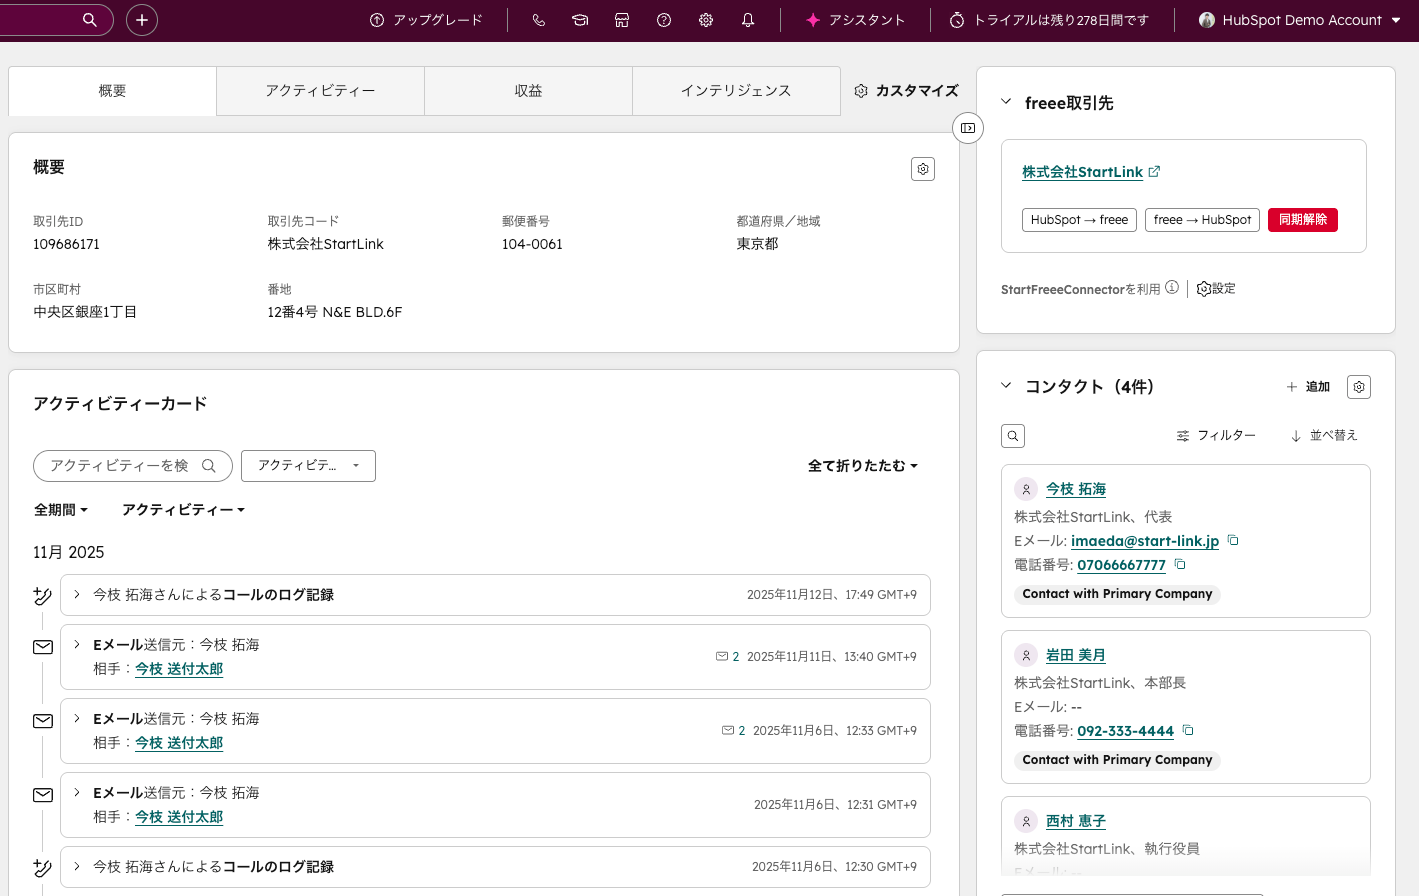
CRMのレコード上で連携状況を確認する場合も、DWHで分析する項目は別途定義します。会社、取引、請求のうち何を結び、どちらのシステムの値を指標に使うかを決めます。
項目ごとに更新元、更新先、実行条件、失敗時の再実行方法を定義します。両方のシステムで同じ項目を編集できる場合は、どちらの変更を優先するか決めてから連携します。
エラー時には対象レコードのID、処理日時、失敗理由を記録し、修正したレコードを再処理できるようにします。再実行後は、元レコード、連携先、レポートの値を照合します。差異が残るなら対象を広げず、変換条件か識別子の対応を見直します。
同じエラーが繰り返される場合は、再実行だけで済ませず、入力ルール、識別子の対応、更新の順序を調べます。原因に応じて担当者と確認方法を変え、修正後のレコードがレポートへ反映されたことまで確かめます。
CRM側のデータ同期や自動化を検討する際は、HubSpot Data Hubとは?データ同期・自動化・レポート機能を徹底解説も参照してください。必要な更新をCRM内で扱うか、DWHでの横断分析に進めるかを整理する際の参考になります。
データ基盤は、意思決定に使う範囲を決め、各段階の結果を確認しながら広げます。次の表の期間は進行計画の例であり、移行日を確定する基準ではありません。次へ進むかどうかは、指標の再現性、データの照合、運用担当の準備状況で判断します。
| フェーズ | 期間 | 内容 |
|---|---|---|
| Phase 1 | 0〜3ヶ月 | CRMのダッシュボード活用(DWH不要) |
| Phase 2 | 3〜6ヶ月 | CRM + 会計データのDWH統合 |
| Phase 3 | 6〜12ヶ月 | 全社データの統合、高度な分析 |
| Phase 4 | 12ヶ月〜 | AI/ML活用、予測分析 |
HubSpotのコンタクト、会社、取引の関係を確認し、指標に必要なプロパティと入力ルールを決めます。営業プロセスのステージは、名称だけでなく、どの状態になれば移るかを共有します。その定義に沿って標準ダッシュボードで指標を確認します。
次へ進む前に、同じ条件なら同じ集計結果になるか、数字から元の取引へ戻れるかを確認します。結果が担当者の手作業によって変わる場合は、連携範囲を増やす前に入力と集計の条件を見直します。
この段階で欲しい指標がCRM内の情報だけで作れるなら、その運用を継続します。別システムの値が判断に必要になったら、どの数字を照合したいのかを明示して次の段階へ進みます。
CRM上の受注と会計上の売上は、同じ値として扱わず、それぞれの発生時点と集計単位を定義します。取引と請求の対応を確認し、対応しないものがあれば理由を記録します。
連携対象は判断に使う項目へ絞ります。対象レコードで照合でき、差異の扱いと更新責任者が決まったら、横断レポートへ進みます。照合できない場合は、項目を増やす前に識別子と業務上の定義を確認します。
横断レポートの利用を始めた後も、差異の内訳を確認します。新しい差異が生じたときに、入力、連携、変換のどこを調べるか担当者が判断できれば、ほかの指標への拡張を検討できます。
CRMと会計の指標を同じ条件で扱えるようになった後で、ほかの業務システムやデータレイクへの拡張を検討します。追加するデータには、利用目的、更新責任者、品質の確認方法を設定します。
AIや機械学習を利用する場合は、入力に使ったデータと結果を人が確認できるようにします。分類や予測をどの判断に使うかを決め、結果が業務上の確認に耐えない場合は、元データや評価方法を見直します。結果を利用する人が根拠を確認できるまでは、判断への利用範囲を広げません。
| 段階 | 主な対象 | 次へ進む基準 |
|---|---|---|
| CRM整備 | 顧客、会社、取引、標準レポート | 項目定義と入力ルールが共有され、同じ条件で集計できる |
| 会計連携 | 取引、請求、売上 | 共通IDでCRMと会計データを照合できる |
| 全社統合 | 複数部門の業務データ | 利用目的、責任者、品質基準が決まっている |
| AI活用 | 分類、要約、予測分析 | 人が根拠データを確認し、結果を評価できる |
DX戦略の策定方法と組み合わせ、事業上の判断とデータ整備の順序を対応させてください。CRMの入力や運用から着手する場合は、CRM導入の進め方完全ガイドも参照できます。
構築後も同じ指標を使い続けるには、入力、連携、変換、可視化の各工程で問題を見つけられる状態が必要です。数値に差が出たら、表示結果から変換条件、連携記録、元レコードの順にたどって確認します。
入力項目は、業務、レポート、連携のいずれかで使うものに絞ります。追加の要望が出たら、使う画面や指標、入力者、更新責任者を確認します。既存項目で目的を満たせるなら、その定義を共有します。
使い道を説明できない項目は追加を保留します。既存項目の統合や廃止を検討する際も、参照しているレポートと連携を確認してから判断します。似た項目が見つかった場合は、値が異なる理由を調べ、どちらを基準にするか決めます。
ステージ移行時に必要な項目、入力責任者、更新タイミング、エラーの通知先を運用ルールとして残します。入力漏れが起きたら担当者への注意だけで終えず、入力する場面と確認する仕組みを見直します。
新人でも同じ手順で処理できるように、項目の説明、入力例、判断に迷った場合の連絡先を記載します。項目定義の変更時には管理者が利用先を確認し、似た項目が増えないようにします。
変更後は、その項目を使うレポートと連携結果を確認します。表示値が変わった場合に定義変更の影響か入力の問題かを区別できるよう、変更内容と確認結果を残します。
元データの定義が決まっていない場合、DWHへ集めても差異の意味は判断できません。CRMの標準レポートで目的を満たせる場合も、まずその指標を安定して運用できるか確認します。
次の表で分析対象、指標、識別子、運用体制を確認します。DWHへ進む条件が一部だけ満たされているなら、不足している条件を整えてから再判断します。
| 確認項目 | DWHへ進む判断 | CRM整備を続ける判断 |
|---|---|---|
| 分析対象 | 複数システムの横断集計が必要 | CRM内のデータだけで足りる |
| 指標定義 | 部門間で計算条件が合意されている | 同じ指標の意味が部門ごとに異なる |
| 識別子 | 顧客や取引を共通IDで結合できる | 名称の表記だけで突合している |
| 運用体制 | 更新責任者とエラー対応者が決まっている | 集計が特定の担当者に依存している |
判断に迷う場合は、横断集計が必要な指標を選び、表の各条件について根拠となるレコードや運用手順を確認します。識別子や指標定義が未確定ならその整備を先に行い、条件がそろってから構成を比較します。
構成を選ぶ前に、作りたい指標と現在のデータで確認できる範囲を整理します。以下では、DWHとデータレイクの選択、CRMとの役割分担、変換方法、費用の見積もり方を確認します。それぞれ、比較を始める前に決めることと、次へ進む条件を示します。
売上や商談など、定義済みの構造化データを継続して集計するならDWHが候補です。元の形式に近いデータを保持し、探索的に利用する目的があるならデータレイクを検討します。
最初に作りたいレポートと必要な項目を書き出してください。DWHで実現できるならその構成で検証し、別のデータを保持して利用する必要が明確になった時点で、レイクハウスを含めて比較します。どちらを選ぶ場合も、利用者とデータの管理責任者を決めてから対象を広げます。
データサイロとは、部門ごとに異なるシステムやExcelへデータが分散し、相互に参照しにくい状態です。同じ顧客の登録名や指標の計算条件が異なり、部門間で数字を照合できない場合は、その原因を確認する必要があります。
解消するには、まず比較したい指標を決め、基準となるシステムと識別子を確認します。名称だけで一致を判断せず、どのシステムが各項目を更新するかまで定義します。対応できないレコードは例外として記録し、扱いを決めてから集計に含めます。
営業、マーケティング、顧客対応のデータをCRM内で必要な条件に沿って分析できるなら、まず標準ダッシュボードを整えます。指標の値から元レコードへ戻れ、関係者が同じ定義で判断できるか確認してください。
会計など別のシステムと横断して分析する必要があり、CRM内では同じ粒度で照合できない場合にDWHを検討します。その際は、追加するデータと改善したい判断を具体的に示します。照合する識別子と指標の定義が決まってから、連携方法を選びます。
格納前に変換を確定する必要があるならETL、元データを先に格納してから変換する運用が適しているならELTを検討します。選択時には、変換を担当する人、元データの保持方法、失敗時の確認手順を比較します。
ETLでは変換失敗時の退避先、ELTでは生データと変換済みデータの区別を決めます。どちらでも、レポートが参照するデータと計算条件を固定し、元の値まで追跡できるようにします。その確認手順を担当者が実行できる方式を選びます。
製品の利用料に加え、データの取り込み、保存、処理、転送、BIツール、監視、運用担当者の作業を分けて見積もります。候補ごとに対象データ、更新方法、代表的なレポートをそろえて試算します。
試算した利用量は、検証環境でレポートを実行して確認します。想定との差が大きければ、参照するデータの範囲や実行方法を見直します。CRMの標準機能で確認できる指標と、横断分析が必要な指標を分けておくと、必要な構成を判断しやすくなります。
企業データ基盤の構築では、意思決定に使う指標を定義し、元データから結果まで追跡できる流れを作ります。CRMの入力とレポートを整えたうえで、別システムとの照合が必要な範囲をDWHなどへ広げます。
まずはCRMで確認したい指標を一つ決め、次の順番で着手してください。
差異が見つかった場合は対象レコードと原因を記録し、定義や識別子を見直します。同じ条件で数字を再現でき、更新時の確認担当も決まったら、次のデータへ対象を広げます。
StartLinkはHubSpotゴールドパートナーとして、CRM・SFA・MAの設計、導入、運用を一気通貫で支援しています。なお、DWH・データレイクの構築代行、大規模データ基盤の設計実装、基幹システムのリプレースは対応範囲外です。HubSpotを起点にした顧客データ、会計データ、AIの連携をご提案します。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのStartLinkまでお気軽にお問い合わせください。
データ基盤の設計を進める際は、識別子と項目定義、データ品質、可視化、クラウド環境、AIでの利用を順に確認すると、次に整えるべき範囲が明確になります。以下の記事を、現在確認している課題に合わせて参照してください。識別子がそろわない場合はマスターデータ管理、照合前の値にばらつきがある場合はデータクレンジングから確認できます。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。