この記事の結論
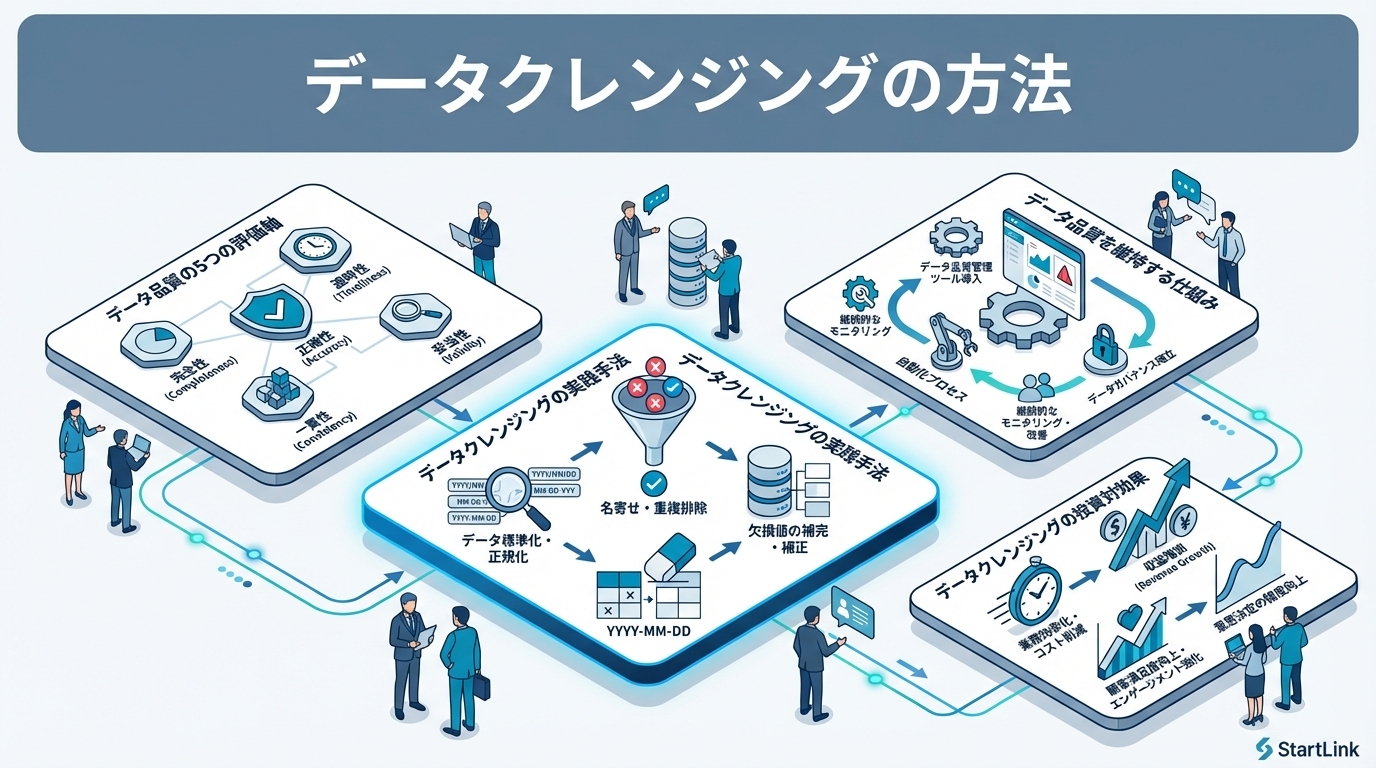
データクレンジングとは、業務データの重複・欠損・表記揺れ・異常値を検出して修正し、データ品質を保つプロセスです。既存データを整える作業と、入力時に汚れを防ぐ管理・入力後に問題を見つけるチェックを組み合わせます。
データクレンジングとは、業務データの重複・欠損・表記揺れ・異常値を検出して修正し、データ品質を保つプロセスです。既存データを整える作業と、入力時に汚れを防ぐ管理・入力後に問題を見つけるチェックを組み合わせます。
データクレンジングとは、業務データの重複・欠損・表記揺れ・異常値を検出して修正し、データ品質を保つプロセスです。既存データを整える作業と、入力時に汚れを防ぐ管理・入力後に問題を見つけるチェックを組み合わせます。
「同じ顧客が複数のレコードに分かれている」「必要な項目が空欄で、集計の対象から漏れる」。こうした状態では、レポートの数字を読む前に、どのデータを同じ顧客として扱うかを確認しなければなりません。
進め方の基本は、名寄せ・欠損補完・表記の標準化・異常値の修正です。ただし、すべてのレコードを一度に直す必要はありません。まず業務判断に使う項目を選び、現状を測り、修正ルールに合意してから作業します。その後、入力時のルールと継続的なチェックに移ります。
本記事は「データドリブン経営の進め方|データに基づく意思決定を組織に実装するステップ」シリーズの一部です。
DXのツール選定について体系的に学びたい方は、DXツール・インフラガイドで、データを扱う基盤やツールを検討する際の全体像を確認できます。
顧客データの重複や表記揺れに悩むDX推進・営業企画・マーケティングの担当者に向けて、修正対象の選び方から、品質を保つ運用への移し方までを整理します。
データクレンジングは、不正確・不完全・重複したデータを見つけ、修正・統合・削除の要否を判断する作業です。既存データを整えても、入力する場所や更新の責任が曖昧なままでは、同じ問題が再び生じます。まずは汚れの種類と、そのデータが使われる業務を対応づけましょう。
業務データの汚れは、おおむね次のように分けられます。検出方法も修正方法も異なるため、自社のデータでどれが判断を妨げているかを先に確認します。
| 汚れの種類 | 典型例 | 放置したときの影響 |
|---|---|---|
| 重複 | 同じ顧客が別々のレコードとして複数存在する | 同じ相手への重複アプローチ、顧客数の過大計上 |
| 欠損 | 業種・電話番号・担当部署が空欄 | セグメント配信や分析の対象から漏れる |
| 表記揺れ | (株)ABC/株式会社ABC/ABC(株) | 集計が分かれ、名寄せの精度が下がる |
| 異常値 | 売上がマイナス、契約開始日が終了日より後 | レポートの数字そのものが信用されなくなる |
たとえば重複が問題なら、レコードを統合する前に「同一顧客」の判定基準が必要です。欠損が問題なら、その項目を本当に業務で使うかを確認します。汚れの件数だけで優先順位を決めず、影響を受ける判断から修正対象を選びます。
営業の顧客リスト、展示会の名刺リスト、経理の取引先一覧が別々に管理されていると、同じ会社の情報が複数のファイルに現れます。一方だけを更新した場合、どちらを参照すべきかが分からなくなります。
最初に確認したいのは、各項目の更新元と参照先です。たとえば会社名を営業のリストで直した場合、ほかのリストにも反映する決まりがあるでしょうか。決まりがなければ、表記をそろえる作業と並行して、誰がどこを更新するかを決めます。
CRMで顧客データを一元管理する際も、コンタクト・会社・取引の関連付けを確認し、同じ情報を複数箇所に入力している項目の更新元と参照先を整理します。置き場所を決めた後は、実際の更新手順で差分が残らないかを確かめてください。
顧客データは、コンタクトの獲得から取引、顧客化、請求まで使われます。どの段階の判断に影響するかを確認すると、優先して直す項目を選びやすくなります。
| 業務の段階 | 汚れの例 | 判断への影響 |
|---|---|---|
| コンタクト・会社 | 重複・表記揺れ | リード数や見込み企業数が実態より多く見える |
| 取引 | 金額・クローズ日の欠損 | 売上見込み(フォーキャスト)が立てられない |
| 顧客 | 担当者・契約情報の鮮度低下 | 更新やフォローのタイミングを逃す |
| 請求 | CRMと会計の取引先名の不一致 | 請求漏れの検知や売上の突合に手間がかかる |
まず、日常のレポートや顧客対応で参照している項目を挙げます。その項目に汚れがあるレコードを確認し、判断結果が変わり得るものから着手します。利用していない項目の空欄を埋める作業は、必要性を確認してからにします。
「データが汚い」という感覚だけでは、改善対象も終了条件も決められません。品質を評価軸に分け、同じ条件で測り直せるようにします。ここでは各軸の確認方法と、着手時に使う指標を整理します。
データ品質は、次の5つの軸で確認できます。
| 評価軸 | 内容 | 測定方法 |
|---|---|---|
| 完全性 | 必須項目にデータが入っているか | 空欄率の計測 |
| 正確性 | データが正しいか | サンプル抽出による検証 |
| 一貫性 | 同じデータが複数の場所で矛盾していないか | システム間のデータ突合 |
| 鮮度 | データが最新の状態か | 最終更新日の確認 |
| 一意性 | 同じエンティティが重複していないか | 重複検出ロジックの実行 |
完全性は空欄を数えれば確認できます。一方、値が入っていても正しいとは限りません。正確性を確認するときは、業務で使う項目からサンプルを選び、元資料や担当者が確認できる情報と照らし合わせます。
一貫性と鮮度は、何を正しい情報源とし、いつの状態を必要とするかを決めてから確認します。比較先や更新条件が決まっていなければ、数値だけで品質の良し悪しを判定しないようにします。
着手時は、対象を会社とコンタクトなどに絞り、重複率(一意性)と空欄率(完全性)を測ります。重複率は「重複として確認したレコード数÷対象レコード数」、空欄率は「対象項目の空欄件数÷その項目を確認すべきレコード数」として、集計対象を明記します。
重複の疑いがあるだけのレコードと、同一と確認できたレコードは分けて記録します。また、入力が不要なレコードを空欄率の分母に含めるかも先に決めます。こうしておけば、作業前後の数字を同じ条件で比較できます。
測定日、対象範囲、判定ルール、結果を一緒に残します。対象やルールを変えた場合は、前回との差をそのまま改善効果として扱わず、変更内容を添えて比較してください。
品質を測る前に、「レポートや業務判断で使う項目」と「現在は使っていない項目」を仕分けます。使っていない項目の空欄を埋めても、必要な判断に役立つとは限りません。
項目を外すか迷ったら、その値を参照する画面、レポート、業務手順があるかを確認します。参照先があれば利用者と必要な入力条件を決めます。参照先が確認できなければ、入力を求め続ける理由を見直します。対象が定まってから品質を測ると、修正の要否を判断しやすくなります。
既存データを整える方法は、重複の名寄せ、欠損補完、表記標準化、異常値修正に分けられます。各手法で「検出できたこと」と「正しい値を確定できたこと」を区別してください。検出結果をそのまま一括修正せず、確認方法を決めてから反映します。
名寄せは、同じ顧客や企業を指す複数のレコードをまとめる作業です。検出には次の方法を組み合わせます。
| 検出方法 | 内容 | 判断の分かれ目 |
|---|---|---|
| 完全一致検索 | メールアドレス、電話番号、法人番号で照合 | 一致すれば統合候補として扱ってよい |
| あいまい一致検索 | 企業名・個人名の類似度でスコアリング | 類似のみで一致キーがなければ人が判断する |
| ルールベース検索 | 同じ会社ドメイン名などを照合候補にする | ドメインだけで同一企業と決めず、法人名や関連会社の関係も確認する |
一致する値があっても、統合してよいかは別の判断です。共有の電話番号やドメインなど、複数の相手に使われ得る情報は、会社名、担当者、関連付けられた取引も確認します。判断できない場合は統合を保留し、確認する担当者を決めます。
統合するときは、次のルールをあらかじめ決めておきます。
これらは機械的に適用する順位ではありません。新しい値が誤っている場合や、空欄の少ないレコードの関連付けが不正確な場合もあります。統合前に残すレコードと各項目の採用元を確認し、判断理由を記録します。
完全一致は機械で抽出し、あいまい一致は担当者が確認します。統合後は、コンタクトや取引との関連付けが意図した状態かも確かめてください。
空欄は、値を確認できるか、その項目を業務で使うかによって扱いを変えます。
| 補完方法 | 内容 | 適する場面 |
|---|---|---|
| 直接入力 | 担当者が手動で補完 | 少量のデータ |
| 外部データ照合 | 法人番号DB、住所DB等と照合 | 企業情報の補完 |
| エンリッチメント | データエンリッチメントサービスを利用 | 大量のBtoBデータ |
| デフォルト値 | 不明な場合のデフォルト値を設定 | 分析に影響しない項目 |
まず、空欄によって配信・分析・営業判断のどれが止まるかを確認します。次に、担当者や照合先から値を確かめられるかを判断します。確認できる場合だけ補完し、確認できない場合は「不明」として扱うか、判断に使う対象から外すかを決めます。
デフォルト値を使うときは、実際に確認した値と区別できるようにします。不明な業種を特定の業種として埋めると、空欄率は下がっても分類の正確性を損ないます。
表記の標準化は、同じものを指す値の書き方をそろえる作業です。
| 対象 | Before | After |
|---|---|---|
| 企業名 | (株)ABC / 株式会社ABC / ABC(株) | 株式会社ABC |
| 電話番号 | 03-1234-5678 / 0312345678 | 03-1234-5678 |
| 住所 | 東京都中央区銀座1-12-4 / 銀座一丁目12番4号 | 東京都中央区銀座1丁目12番4号 |
| 部署名 | 営業部 / セールス部 / 営業本部 | 統一ルールに従う |
表記ルールは、名寄せの照合前に決めます。ただし、名称が似ていることと、同じ企業・部署であることは分けて確認します。たとえば部署名は、単なる呼び方の違いか、組織上の別部署かを担当者に確かめてから統一します。
ルールには、対象項目、採用する表記、例外、変更を承認する担当者を記載します。入力する人が参照できる場所に置き、例外が続けて見つかったらルールを見直します。
異常値は、値の範囲、項目間の関係、入力形式から確認します。
検出された値には、入力ミスだけでなく、例外的でも正しい値が含まれ得ます。元資料や入力担当者に確認し、修正するか、例外として残すかを決めます。入力ミスだった場合は、同じ誤りを入力時に見つけられるかを確認し、必要な入力規則を追加します。
クレンジングは、対象を決めて現状を測り、ルールに合意してから修正します。表記だけ先に直しても同一顧客の判定が曖昧なら名寄せで止まり、統合だけ急いでも誤った関連付けを残すおそれがあります。各段階の結果を確認してから次へ進みます。
まずはCRMの会社とコンタクトのうち、営業やマーケティングが日常的に使う項目を対象にします。対象を決める際は、項目の利用者、利用する判断、確認できる元情報を並べます。
判断に使われ、元情報も確認できる項目から始めます。利用目的が曖昧な項目は管理の要否を先に決め、正しい値を確認できない項目は補完方法を決めるまで一括修正を保留します。手順が確かめられたら、取引やほかのシステムへ対象を広げます。
各ステップの終了条件を、関係者が確認できる形で残します。数字が変わったかだけでなく、未判断のレコードを誰が扱うかも確認します。
| ステップ | やること | 次に進む目安 |
|---|---|---|
| 1. 現状計測 | 重複率・空欄率を計測する | 数値が日付つきで記録され、関係者に共有されている |
| 2. ルール策定 | 表記ルール・統合ルール・必須項目を文書化する | 営業とマーケティングの責任者が内容に合意している |
| 3. バックアップ | 対象データを全件エクスポートする | 復元の手順を担当者が説明できる |
| 4. 表記の標準化 | 企業名・電話番号・住所をそろえる | 同じ企業の表記揺れ候補が検出されなくなる |
| 5. 名寄せ | 完全一致→あいまい一致の順で統合する | 完全一致の重複が残っておらず、あいまい候補の判断が済んでいる |
| 6. 補完・異常値修正 | 優先項目の空欄と異常値を直す | 必須項目の空欄率がステップ1の数値より下がっている |
| 7. 再計測 | ステップ1と同じ条件で測り直す | Before/Afterを報告し、月次計測に移行している |
ステップの目安に達しない場合は、件数だけを追わず、原因を分けます。表記揺れが残るならルールの例外を、空欄が残るなら入力の必要性と確認元を、重複が残るなら判定に必要な情報を見直します。判断を保留したレコードは一覧に残し、担当者と再確認の条件を決めてください。
CRMの顧客データで手順を確認できたら、ほかのシステムや部門のデータに広げます。その際は、マスターデータ管理(MDM)の整備を参照し、どのシステムのどの項目を正とするか、誰が変更を承認するかを決めます。
広げる前には、CRMで使った表記・統合ルールが移行先の業務にも当てはまるかを確認します。同じ顧客でも、部門によって管理する単位が違う場合があります。単位が異なるなら、名寄せの基準をそろえる前に利用目的を確認します。
既存データを直した後は、入力時に汚れを防ぐ仕組みと、入力後に問題を見つける仕組みを用意します。各チェックについて「誰が結果を見るか」「何が起きたらルールを見直すか」を決めておくと、発見した問題を修正につなげられます。
新しいデータを登録する時点で、必要な情報と入力方法を示します。
入力者が正しい値をまだ確認できない項目を一律に必須にすると、仮の値が入る可能性があります。必須にする前に、誰が、どの場面で値を確認できるかを確かめます。
入力後は、同じ定義で品質を測り、例外を確認します。
計測の頻度や通知条件は、業務でデータを使うタイミングと、担当者が対応できる量に合わせて決めます。通知が届いても判断に使われていなければ、閾値、通知先、確認する項目を見直します。数値が悪化した場合は、どの入力経路や項目で増えたかを調べ、入口のルールへ戻って修正します。
運用を引き継げるよう、入力ルール、変更権限、品質を確認する担当者を明文化します。
| 仕組み | 内容 | 人に頼る状態との違い |
|---|---|---|
| ルールをシステムに埋め込む | 選択式・必須項目・形式制約をCRM側で設定する | 覚えていなくても正しい形でしか入力できない |
| 項目を増やせる人を限定する | プロパティの追加・変更は管理者だけが行う運用にする | 似た項目が乱立して表記が割れる事態を防げる |
| データオーナーを決める | 会社・コンタクト・取引ごとに品質の責任者を置く | 月次レポートの数値が悪化したときの対応者が明確になる |
必須項目を設定した理由と、入力時に判断できない場合の扱いもガイドラインに残します。新しい業務で項目が必要になったときは、既存項目で足りるか、利用者は誰か、品質を誰が確認するかを決めてから追加します。
HubSpotで仕組み化する場合も、先に対象項目と判断ルールを決めます。そのうえで、重複管理、プロパティ、ワークフローをどの業務段階で使うかを整理します。CRM上での作業手順は、CRMのデータクレンジング実践ガイドも参照してください。
インポート時の識別方法を検討する際は、HubSpotのインポートに関する説明を確認し、取り込むデータに使える識別子が入っているかを調べます。識別子が欠けている行や、同じ値が別の相手にも使われる行は、取り込み前に扱いを決めます。
名刺や展示会のリストでは、メールアドレスや会社ドメイン名が空欄の行を分けて確認します。補完できる行は元情報で確かめ、確認できない行は取り込み後の照合担当者を決めます。重複として検出された場合も、関連会社や共有ドメインの可能性を確認してから統合します。
統合後は、コンタクト・会社・取引の関連付けと、参照するレポートの集計単位を確認します。
項目の入力形式を見直す際は、HubSpotナレッジベース:Property field types in HubSpotを参照できます。まず、自由記述になっている項目のうち、取り得る値を業務上決められるものを洗い出します。
選択式に変更する前に、現在入っている値を分類し、例外をどう扱うかを決めます。日付や数値の項目も、形式をそろえるだけで意味が正しくなるわけではありません。必要な確認元と入力担当者を定めます。
必須項目は、フォームや登録画面でその時点に確認できる情報を基準に選びます。確認できない値を仮入力させていないか、実際の登録手順で確かめてください。
ワークフローでは、条件に合うレコードの抽出や、担当者への確認依頼を検討できます。たとえば業種が空欄の会社について、まず「その業務段階で業種が必要か」を決め、必要な場合に確認担当者へ渡す流れを設計します。空欄を別の値で埋める前に、正しい値を確認できるかを確かめます。
データの同期や自動化を広く検討する場合は、「HubSpot Data Hubとは?データ同期・自動化・レポート機能を徹底解説」で検討対象を整理できます。これから設定を始める場合は、HubSpot初期設定・オンボーディング完全マニュアルを参照し、プロパティの用途と入力ルールを決めてから運用を始めます。
一貫性を確認する際は、CRMの会社名と会計システムの取引先名を文字列だけで比較せず、同じ取引先を指すかを確認します。名称が異なる場合は、どちらを更新元にするか、変更後にどこで照合するかを決めます。
StartLinkでは、HubSpotとfreee会計をリアルタイムで連携する Sync for freee を独自に開発しています。次の画面を参考に、会社レコードと連携先の取引先が意図した組み合わせかを確認してください。
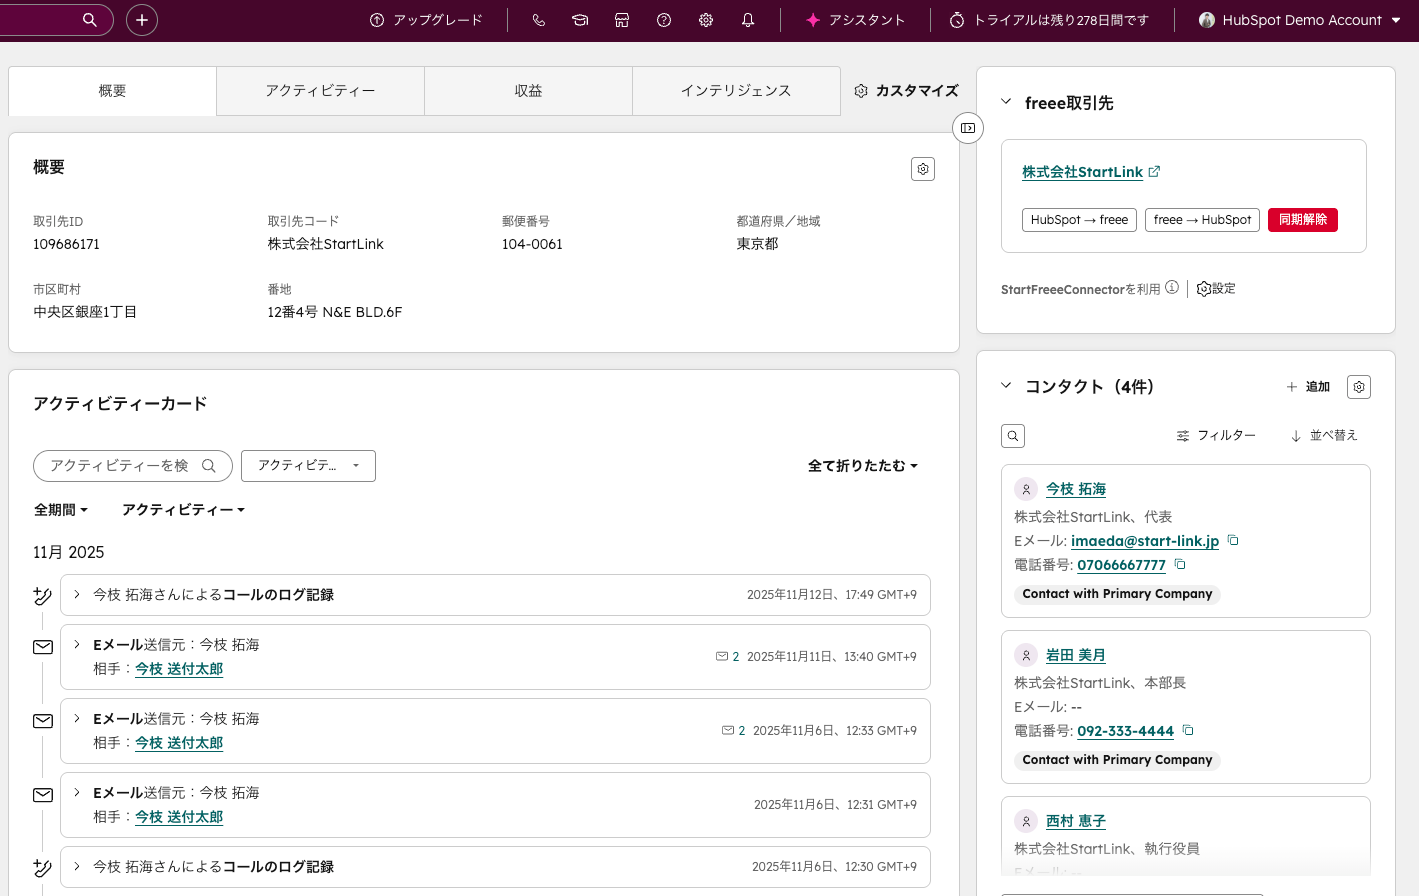
会社情報をどちらで管理するかを決めたら、連携後に同じ取引先として対応づいているかを確認します。コンタクト・会社・取引から請求までの流れでは、それぞれの段階で必要な項目と確認担当者を明らかにしておくことが、一貫性を保つ判断の土台になります。
AIは、大量のデータから似た表記や確認を要するレコードを見つける作業に使えます。ただし、同じ顧客として統合してよいか、どの値を正とするかは、業務上の関係を確認して決めます。作業を分け、反映前に人が確認する条件を設けます。
表記揺れの抽出、問い合わせ内容や業種の分類案、自由記述の要約は、確認対象を整理する用途で使えます。HubSpotのAI機能であるBreezeや、Claude Codeのような外部のAIエージェントを検討する場合も、入力データ、判定ルール、出力を確認する担当者を先に決めます。
出力結果をそのまま正解として反映せず、誤分類や別企業の混同が見つかった場合に、どのルールを見直すかまで決めておきます。
| AIに任せやすい | 人が判断する |
|---|---|
| 表記揺れ・重複候補の抽出 | 表記ルール・統合ルールそのものの決定 |
| 業種や問い合わせ内容の分類 | 分類カテゴリの定義 |
| 空欄項目の補完候補の提示 | どの項目を必須にするかの決定 |
| 異常値の検出 | あいまい一致の候補を統合するかどうか |
人が決めるのは、データを使う目的と、誤って統合・修正した場合に影響する業務です。同じ名称でも別の企業かもしれず、異なる表記でも同じ取引先かもしれません。判定できないときは反映を保留し、確認元を探します。
AIを使う場合は、次の順番で進めます。
判断理由を記録しておけば、同じ状況に再び出会ったときに参照できます。新しい例外が出た場合は、既存ルールで扱えるかを確かめ、扱えなければ担当者がルールを見直します。
データクレンジングにかける手間を判断するには、作業前後で何を比較するかを決める必要があります。重複率や空欄率が改善しても、業務で使う判断が変わらなければ、次に直す項目を見直します。ここでは確認する領域と、自動化の限界を整理します。
| 効果項目 | 内容 |
|---|---|
| 分析精度の向上 | 正確なデータに基づく意思決定が可能に |
| 営業効率の向上 | 重複アプローチの防止、正確な顧客情報での対応 |
| マーケ効率の向上 | 正確なセグメントに基づく施策の実行 |
| システム連携の安定化 | データ不整合によるエラーの削減 |
| コンプライアンス対応 | 個人情報の適切な管理 |
効果を確認するときは、表の各領域で実際に使う判断を決めます。たとえば営業なら重複した相手への対応履歴、マーケティングならセグメントから漏れたレコード、連携なら照合時に人が確認したレコードを見ます。作業前後で対象と集計条件をそろえ、変化の理由を確認します。
AIによるデータ分析の自動化を検討する際も、分析に使う元データの範囲と品質を確認します。CRMの整備をどの段階で進めるかは、CRM導入の進め方完全ガイドも参考になります。分析基盤の選び方を比較する際は、中小企業向けBIツール比較で検討項目を確認できます。
形式の統一や条件に合うレコードの抽出は自動化を検討できます。一方、あいまいな名寄せや、正しい値の根拠がない空欄の補完には、人による確認が必要です。確認できないデータを推測で埋める運用は避けます。
過去の全データを一律に修正する前に、現在の営業・マーケティング・請求で参照しているかを確認します。参照していないデータは、利用目的と管理の要否を決めてから扱います。利用しているデータでも正しい値を確かめられなければ、未確認として残す判断が必要です。
クレンジングツールを検討する際は、入力場所、更新元、重複時の判断担当者が決まっているかを先に確認します。修正後も同じ問題が生じたら、ツールの処理結果だけでなく、入力・更新手順を見直します。
StartLinkは、CRM・SFA・MAの設計・導入・運用を一気通貫で支援しています。HubSpotの重複排除・プロパティ設計・入力ルールを整えることで、顧客データの品質を継続的に維持できる仕組みづくりをご提案します。加えて、Sync for freeeによるHubSpotとfreee会計のリアルタイム連携や、Claude Codeエージェントを活用したデータ名寄せ・定型クレンジング業務の省力化もご提案可能です。
なお、全社データクレンジングツールの開発、DWH構築代行、基幹システムのリプレースは対応範囲外です。HubSpotを起点にした顧客データ×会計データ×AIの領域に特化してご支援しています。企業様によって最適な形は異なります。現在使っている項目と判断に困っている場面を確認し、着手する範囲を一緒に整理します。
データクレンジングとは、不正確・不完全・重複したデータを見つけ、修正・統合・削除の要否を判断するプロセスです。表記の統一、異常値の確認、重複データの名寄せ、欠損値の補完などが含まれます。最初に業務で使う項目を選び、正しい値を確認できる方法を決めてから修正します。
CRMへのデータ移行や、レポート・配信で顧客データを使う前に、対象範囲の品質を確認します。運用開始後は、入力経路や利用する項目が変わったとき、重複や空欄が増えたときに見直します。定期チェックの頻度はデータを使う業務に合わせて決め、発見した問題を入力ルールの改善につなげます。
表記の形式をそろえる処理や、重複・空欄の確認対象を抽出する処理は自動化を検討できます。ただし、別の企業を誤って統合しないため、あいまいな名寄せの最終判断は担当者が行います。自動処理の前に判定ルールと例外の扱いを決め、反映後は関連付けや集計結果を確認します。
関数やフィルタを使って、表記の違いや重複を調べられます。まず対象のファイルと更新担当者を確認し、同じ顧客の情報が別のファイルにもある場合は、どちらを更新元にするかを決めます。そのうえで表記・統合ルールを適用し、修正後にファイル間の差分が残っていないかを確認します。CRMへの集約を検討する場合も、この更新ルールを先に整理しておくと移行対象を判断しやすくなります。
着手する際は、次の順番で対象と修正ルールを決めてください。
次に、対象データを保全して修正し、同じ条件で測り直します。数値が改善しても業務上の問題が残る場合は、測る項目や判定ルールを見直します。
DX推進の全体像についてはDX完全ガイドで、基礎から実践までの進め方を体系的に解説しています。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。