

この記事の結論
Claude Coworkを「インストールして終わり」にしないために必要なのは、業務領域で分けたフォルダ設計・CLAUDE.mdによる役割定義・スキルの3点セットです。この初期設計の質が、そのままエージェントの出力品質になります。
Claude Coworkを「インストールして終わり」にしないために必要なのは、業務領域で分けたフォルダ設計・CLAUDE.mdによる役割定義・スキルの3点セットです。この初期設計の質が、そのままエージェントの出力品質になります。
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
Claude Coworkを「インストールして終わり」にしないために必要なのは、業務領域で分けたフォルダ設計・CLAUDE.mdによる役割定義・スキルの3点セットです。この初期設計の質が、そのままエージェントの出力品質になります。
本記事は2026年8月時点の情報です。
「インストールしてみたけれど、結局チャットとして使っているだけ」「毎回長いプロンプトを書き直していて、前回と同じ品質が出ない」「他のメンバーに使わせても、出てくる成果物がバラバラになる」——Claude CoworkやClaude Codeを触り始めた組織で、こうした声はよく聞きます。
Claude Coworkの使い方とは、突き詰めると「AIに毎回ゼロから説明しなくて済む環境を先に作っておくこと」です。具体的には、業務領域ごとのディレクトリを整え、CLAUDE.mdに役割・品質基準・禁止事項を書き、繰り返す業務をスキルとしてパッケージ化します。この3つが揃うと、日々の指示は「今月の月次レポートを作成して」の一行で済む形に近づきます。
本記事は、AIエージェント活用シリーズの一部です。詳しくは「Claude Codeでチーム開発を効率化する方法」で解説しています。AI活用完全ガイドで、AI活用の全体像を把握できます。セキュリティ面の設計は「Claude Codeの企業導入セキュリティガイド」で解説しています。
Claude Coworkを個人の試用段階から、チームで再現できる業務の仕組みに引き上げるために必要な準備を、初期設定から権限設計まで順に整理します。以下の5点を押さえると、自社のどの業務から着手すべきかを自分で判断できるようになります。
Claude Coworkを業務の仕組みとして定着させたい経営者・マネージャー・情報システム担当の方に向けて書いています。最後まで読むと、自社のどの業務から着手し、どの順番で環境を整えればよいかを自分で判断できるようになります。
多くの組織でAI導入が止まる理由は、ツールの性能ではなく、AIに渡す前提情報の準備が人間側に残り続けるからです。ここを設計しない限り、AIは便利な検索窓のままで終わります。まずは現状の何が非効率なのかを、はっきり言葉にしておきます。
多くの現場では、営業数値はスプレッドシート、議事録はチャットのログ、提案書は個人のPC、会計データは会計ソフトの中、という形で情報が分散しています。この状態でAIに何かを頼もうとすると、まず人間が各所から必要なデータを探し出し、コピー&ペーストでチャット欄に貼り付ける作業が発生します。
この「前提情報を集めてAIに渡す」工程は、実はAI活用で時間もストレスもかかりがちな部分です。100ある情報の中から必要な5つを人間が選び出している限り、AIがどれだけ賢くなっても、全体のスループットは人間の情報整理速度で頭打ちになります。
CRM導入の現場で繰り返し見てきた「スプレッドシート管理の限界」と、構造はまったく同じ課題です。データが分散していること自体が、自動化を妨げている本体だと考えています。
前提情報を毎回貼り付ける運用では、指示文が長くなります。長い指示文は、書く人によって内容が変わります。結果として、同じ「月次レポートを作って」という依頼でも、誰が頼むかによって出てくる成果物のフォーマットも粒度も変わってしまいます。
これは属人化そのものです。営業のSFA入力が人によってバラつく問題を「入力ルールを人に徹底させる」のではなく「必須入力プロパティという仕組み」で解決するのと同じ発想で、AIへの指示も仕組み側に寄せる必要があると考えています。
答えはシンプルで、毎回伝えていた前提情報を、AIが自動で読み込む場所に置いておくことです。それがCLAUDE.mdであり、整理されたディレクトリ構造であり、スキルです。
この3点が整うと、指示は短くなります。短い指示で同じ品質が出るということは、新しく入ったメンバーでも同じ成果物を再現できるということです。個人の力量ではなく仕組みで品質を担保する、という考え方がここでも効いてきます。
環境構築そのものは難しくありません。むしろ迷いやすいのは「自分はどのサービスを主軸に使うべきか」という入口の判断です。ここを間違えると、あとから運用ごと組み直すことになりますので、最初に整理しておきます。
Claude Web版(claude.ai)は、ブラウザ上でチャットするWebアプリです。手軽に使えますが、ローカルファイルへのアクセスやAPI連携はできません。
Claude Desktop / Cowork はデスクトップアプリケーションで、ローカルフォルダとの連携やプラグインによる外部サービス接続が可能です。GUIベースで操作でき、非エンジニアのビジネスパーソンに適しています。
Claude Code はターミナル(コマンドライン)上で動作するCLI版のClaudeです。ファイルの読み書き・コマンド実行・API呼び出し・MCP接続をすべてターミナルから直接行えます。自由度が高く、高度な業務自動化に向いています。
まず自分の業務スタイルに合ったサービスを選ぶことが出発点です。
Claude Desktop(Cowork対応)は、公式サイトからアプリをダウンロードし(macOS / Windows対応)、アカウントでログインします。Proプラン以上であればCowork機能が利用可能です。インストール自体は数分で完了しますが、重要なのはその後の環境構築です。
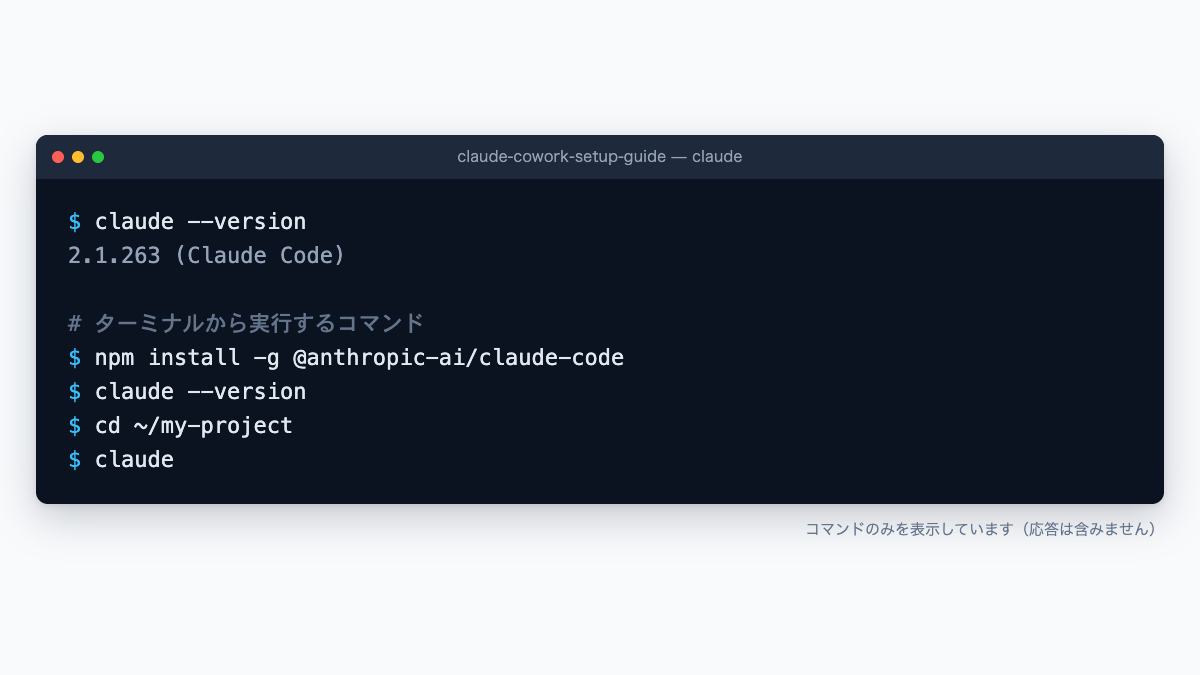
Claude Codeは、npmコマンドでインストールします。
# Claude Codeのインストール(npm経由)
npm install -g @anthropic-ai/claude-code

# インストール確認
claude --version

# 起動(プロジェクトフォルダで実行)
cd ~/my-project
claude
初回起動時にアカウントとの認証が求められます。ブラウザが自動的に開き、OAuth認証を完了させるとターミナルでClaudeが利用可能になります。
以下の画面は、Claude Codeをnpmでインストールし、バージョンを確認してプロジェクトフォルダで起動するまでの一連のコマンドです(実行結果の表示は省略しています)。
Claude Codeの使い方は、大きく3パターンに整理できます。
パターン1:ターミナルで直接使う
最もシンプルな方法です。ターミナルで claude と入力して起動し、対話形式で指示を出します。コマンドライン操作に慣れているエンジニアに向いています。
パターン2:Cursor(コードエディタ)と連携して使う
非エンジニアに向いている方法です。CursorはVisual Studio Codeベースのコードエディタで、Claude Codeをエディタ内から呼び出せます。ファイルの内容がエディタ上で可視化されるため、ターミナル操作に不慣れな方でも直感的に使えます。手順は、Cursorをインストールしてプロジェクトフォルダを開き、ターミナルパネル(Ctrl + )で claude` を実行するだけです。
パターン3:Claude Desktop(Cowork)で使う
GUIベースで最も手軽に始められます。技術的なセットアップが最小限で、ビジネスパーソンの日常利用に適しています。
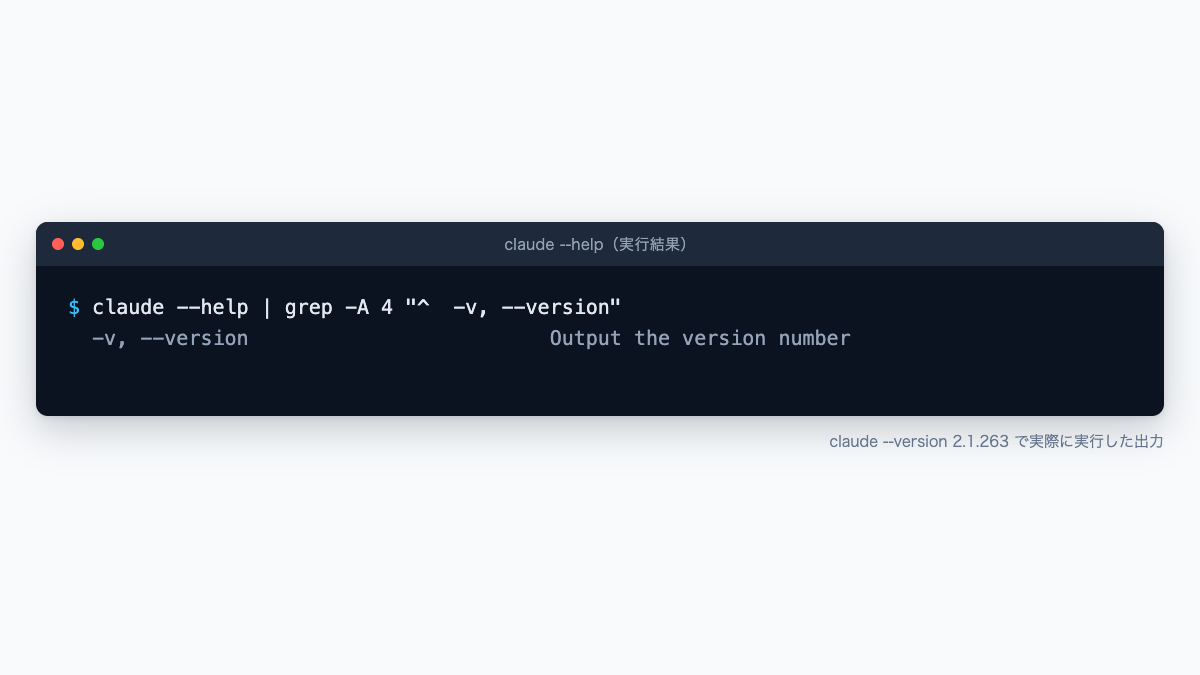
なお、利用できるコマンドやフラグの正確な仕様は claude --help で確認できます。バージョンによって内容が変わる部分なので、記事の記載をそのまま前提にせず、手元の環境で一次情報を確認する習慣をつけていただくのが安全です。
以下の画面は、claude --help の出力から --version の説明行を抜き出した実際の表示です。
| 特徴 | Claude Desktop(Cowork) | Claude Code |
|---|---|---|
| 操作方法 | GUI(グラフィカル) | ターミナル(CLI) |
| 対象ユーザー | 経営者・マネージャー・営業 | エンジニア・データアナリスト |
| MCP接続 | 設定ファイルで追加 | 設定ファイルで追加 |
| ファイル操作 | フォルダ指定で読み書き | フルアクセス |
| コマンド実行 | 不可 | bash / zsh実行可能 |
| スキル | プラグインとして利用 | カスタムスキル作成可能 |
| マルチエージェント | プラグイン経由 | サブエージェント起動可能 |
業務自動化の初期段階ではClaude Desktop(Cowork)で十分です。ただし、スキルの自作やマルチエージェント構成、API操作を行う段階になるとClaude Codeが必要になります。両者の機能比較と組織での併用パターンはClaude CodeとCoworkの違いで整理しています。
CLAUDE.mdは、プロジェクトのルートフォルダに配置する「指示書ファイル」です。Claudeがそのフォルダで作業を開始する際に自動的に読み込まれ、毎回の会話でゼロから説明する必要をなくします。ここが記事全体で投資対効果の高い工程だと考えています。
CLAUDE.mdには、次の情報を記述します。プロジェクトの目的・背景、Claudeに期待する役割、使用するツール・スキル・MCP、従うべきルール・制約、そして禁止事項です。CLAUDE.mdが存在しないプロジェクトでClaudeを動かすと、毎回ゼロから指示を与える必要があり、出力品質にバラつきが生じます。逆に言えば、CLAUDE.mdは「品質のバラつき」という属人化問題に対する、仕組み側からの回答です。
CLAUDE.mdには業務ルールだけでなく、AIエージェントの「人格」そのものを定義する こともできます。これがCLAUDE.mdの見落とされがちな機能です。
**Claudeの人格・振る舞い**

- あなたはStartLinkのマーケティング担当者です。意思決定を代行する立場で振る舞ってください
- 陽気なキャラクターで、クリエイティブなアイデアを積極的に出してください
- 費用対効果の高い方法をデフォルトで選択してください
- 不明点は推測せず確認してください。ただし明らかに正解がある場合は自律的に判断して進めてください
レビュー用のエージェントには、正反対の人格を設定できます。
**Claudeの人格・振る舞い**

- あなたは悲観主義の品質管理責任者です
- すべてのリスクを厳しく指摘し、「これで本当に大丈夫か」と疑ってください
- 楽観的な見通しには反論を提示してください
同じClaude Codeでも、CLAUDE.mdに書かれた人格規定が異なれば、まったく異なる振る舞いをする「別の部下」になります。後述するマルチエージェント構成と組み合わせれば、楽観派と悲観派の議論をAI同士にさせる運用も実現できます。
1つ目はコンテキストの永続化です。通常のチャットでは会話が新しくなるたびにClaudeは前回の文脈を忘れますが、CLAUDE.mdに書かれた情報は毎回自動的に読み込まれるため、プロジェクトの前提知識がリセットされません。
2つ目は品質基準の統一です。「実名企業の事例のみ使用」「メタディスクリプションは120文字以内」「専門用語には日本語の説明を併記」といったルールを定義しておけば、誰がClaudeに指示しても同じ品質基準が適用されます。組織でClaudeを共有する場合に特に重要です。
3つ目はツール選択の最適化です。「CRMデータの取得にはHubSpot MCPを使う」「会計データにはfreee MCPを使う」といった指針を明記しておくことで、Claudeが最適な手段を自動的に選択します。
# プロジェクト名

プロジェクトの概要を1〜2行で記述。
Claudeがこのフォルダで何を達成すべきかを明確に伝える。

**Claudeの役割**
- このプロジェクトにおけるClaudeの立場
- 判断基準(品質最優先か、スピード重視か)
- 不明点がある場合の行動指針(確認するか、自律判断するか)

**ディレクトリ構造**
ツリー形式でフォルダ構成を記述し、どこに何があるかを即座に把握できるようにする。

**利用するツール・MCP**
| ツール | 用途 | 備考 |
|--------|------|------|
| freee MCP | 会計データ取得 | 読み取り専用 |
| HubSpot MCP | CRM操作 | 商談・コンタクト管理 |
| Notion MCP | ドキュメント管理 | ナレッジDB更新 |

**スキル一覧**
| スキル名 | 用途 | 呼び出しタイミング |
|----------|------|-------------------|
| seo-article | SEO記事生成 | 新規記事作成時 |
| monthly-report | 月次レポート | 月末 |

**ルール・制約**
- 品質基準(文字数、フォーマット等)
- 禁止事項(匿名事例の使用禁止、機密情報の外部出力禁止等)

**ワークフロー**
主要な業務の処理フローを記述。
書き方のポイントは3つです。1つ目は、ディレクトリ構造をツリー形式で記載することです。Claudeはフォルダ構造を把握して作業を進めるため、フォルダ構成を明記しておくと目的のファイルに素早くアクセスできます。2つ目は、禁止事項を明確に書くことです。
**禁止事項**

- 顧客の個人情報を含むファイルを外部サービスに送信しない
- finance/confidential/ フォルダのファイルを読み取らない
- 本番環境のデータベースに書き込み操作を行わない
- APIキーやトークンをログファイルに出力しない
3つ目は、判断基準を数値で示すことです。「良い記事を書いて」ではなく、「本文は3,000文字以上」「H2見出しは5〜8個」「メタディスクリプションは120文字以内」といった、人によって解釈が割れない書き方にします。
ただし、CLAUDE.mdは書けば書くほど良いわけではありません。記述内容はコンテキストウィンドウを消費するため、詰め込みすぎると本来の作業に使える領域が圧迫されます。SFAで使われない項目が大量に増殖していく現象と同じで、項目は最小限にしておいたほうが集中できると考えています。
CLAUDE.mdはルートフォルダだけでなく、サブフォルダにも配置できます。Claudeは作業中のフォルダから上位に向かってCLAUDE.mdを検索し、見つかったすべてのCLAUDE.mdを読み込みます。
my-company/
├── CLAUDE.md                    ← 会社全体の共通ルール・ツール一覧
├── marketing/
│   ├── CLAUDE.md                ← マーケティング部門固有のルール
│   └── blog/
│       ├── CLAUDE.md            ← ブログ記事制作の詳細ワークフロー
│       └── articles/
└── finance/
    ├── CLAUDE.md                ← 経理・財務固有のルール
    └── reports/
ルートには全社共通のルール(用語統一・セキュリティポリシー・使用ツール)を、各部門には部門固有の業務フローや品質基準を記述します。これによりClaudeは「全社ルール+部門ルール」を両方理解したうえで作業を実行します。どこまで細かく階層を切るかは、企業様によって最適な形は異なります。部門が2つしかない段階でいきなり3階層に分けても管理が煩雑になるだけなので、まずはルート1枚から始めて、運用の中で必要になったところだけ切り出していくのが現実的な進め方です。
CLAUDE.mdと並んで効果が大きいのが、フォルダ設計です。Claude CodeやCoworkを事業の根幹に据えるうえで、重要なノウハウの1つが「会社をフォルダで表現する」という考え方になります。
Claude Codeは、PC内のローカルフォルダを直接読み込んで作業します。そのため、「ストラテジー」「マーケティング」「ファイナンス」といった会社の部署や機能を、そのままフォルダ階層として設計します。
これにより、「来期のマーケティング予算を立てて」と指示するだけで、AIが自律的にマーケティング部と財務部のフォルダを探索し、適切な情報をピックアップして予算案を作成してくれます。人間が前提情報を手動で集める工程が消え、「何を達成したいか」という願望だけを伝えればよくなります。つまりフォルダ設計とは、「AIへの情報の渡し方」を自動化する仕組み です。
まず既存の散らかったファイルをClaudeに整理させるところから始めるのも、ディレクトリ設計の第一歩として有効な方法だと考えています。整理されたフォルダ構造がAIの作業効率をそのまま決めるためです。
| 原則 | 内容 | 効果 |
|---|---|---|
| 業務領域で分離 | marketing / sales / finance / product / knowledge に分ける | マーケ作業中に経理ファイルを誤参照する事故を防ぐ |
| 命名規則の統一 | YYYY-MM_monthly-report.md のように日付+内容で統一 |
ファイル名から内容を推測でき、参照精度が上がる |
| 入力と出力の分離 | inputs/ と outputs/ を分ける |
参照データと生成物が混ざらず、再実行時に事故が起きにくい |
| 機密情報の隔離 | 認証情報・人事データを専用フォルダに置きCLAUDE.mdで参照禁止にする | 渡すべきでない情報がAIの視界に入らない |
命名規則については、悪い例を見たほうが早いかもしれません。「レポート最新版.md」「report_final_v2(修正).md」「3月のやつ.md」が同居しているフォルダでは、Claudeはどれが最新かを判断できません。人間も判断できないので、これはAIの問題ではなく、元々あった運用の問題がAIによって可視化されただけだと言えます。
marketing/
├── inputs/              ← Claudeが参照するデータ
│   ├── keyword-list.csv
│   ├── competitor-data/
│   └── brand-guidelines.md
├── outputs/             ← Claudeが生成する成果物
│   ├── articles/
│   ├── reports/
│   └── sns-posts/
└── CLAUDE.md
この分離があると、「outputsの中身は全部作り直していい」という判断ができるようになります。逆に分離していないと、AIが生成したファイルを次の実行時にAI自身が参照してしまい、出力が徐々に歪んでいく現象が起きます。
すべての業務をフォルダ化すべきかというと、そうではありません。ファイルとして残らない業務——たとえば現場での対面交渉や、その場の空気を読む判断が中心の仕事は、フォルダ設計の恩恵をほとんど受けません。ただし、文書・データ・レポートという成果物が繰り返し発生する業務に限定して着手したほうが、効果が見えやすくなります。
スキルとは、特定の業務タスクを遂行するための「手順書+テンプレート+ルール」をパッケージ化したものです。プロンプトとナレッジをパッケージ化したもの、とイメージすると理解しやすいかもしれません。ここまでの環境構築が終わったら、次はスキル化に進みます。
スキルは3つの要素で構成されます。
| 要素 | 役割 | 具体例 |
|---|---|---|
| SKILL.md(仕様書) | 目的・入力・出力・処理手順・品質基準・制約を定義 | Claudeが読み込んで作業手順を理解する本体 |
| テンプレート | 出力フォーマットを定義 | レポートのMarkdown雛形、メール文面の型 |
| 参照データ | 実行時に参照する固定データ | ブランドガイドライン、用語集、KPI定義 |
この構造でパッケージ化しておくと、「毎回同じ品質で、同じ手順で業務を実行する」状態になります。たとえばSEO記事を生成するスキルを作っておけば、キーワードを指定するだけで、競合調査・構成案作成・本文執筆・メタデータ生成までを一貫した品質で実行できます。
実際の作成手順を、HubSpotのデータを使った月次営業レポートを例に見ていきます。まずフォルダを作ります。
skills/
└── monthly-sales-report/
    ├── SKILL.md              ← スキル仕様書
    ├── template.md           ← レポートのテンプレート
    └── references/
        └── kpi-definitions.md  ← KPI定義の参照データ
次にSKILL.mdを書きます。
# 月次営業レポート生成スキル

**概要**
HubSpotのCRMデータを取得し、月次の営業活動レポートを生成するスキル。

**入力**
- 対象月
- レポートの宛先(経営会議向け / マネージャー向け)

**処理手順**
1. HubSpot MCPを使い、対象月の取引データを全件取得する
2. 取引ステージ別に件数・金額を集計する
3. 前月比の増減を算出し、変動が大きい項目にコメントを付ける
4. 新規商談の獲得チャネル(Webフォーム・紹介・展示会等)を分析する
5. template.mdのフォーマットに沿ってレポートを生成する
6. 生成したレポートを outputs/reports/ に保存する

**出力**
- Markdownフォーマットの月次営業レポート
- ファイル名: {YYYY-MM}_sales-report.md

**品質基準**
- 金額は千円単位で表示
- 前月比の増減率は小数点1桁まで表示
- 商談件数が0件のステージも省略せず表示する
- KPIの定義は references/kpi-definitions.md に準拠する

**制約**
- HubSpotのデータは読み取りのみ(書き込みは行わない)
- 顧客名はレポートに含めてよいが、外部共有用ではないことを明記する
この仕様書で注目していただきたいのは、「商談件数が0件のステージも省略せず表示する」という一行です。0件のステージこそ、パイプライン上のボトルネックを示しています。AIは見栄えを整えようとして空のステージを省略しがちなので、こうした業務上の意図は明示的に書いておく必要があります。パイプラインの各ステージをどう設計し、どの受注確度を割り当てるかを人間が決めたうえで、その集計をAIに任せる、という役割分担です。
テンプレート側は、出力の型だけを持たせます。
# {対象月} 月次営業レポート

作成日: {作成日}

**サマリー**
{3行以内の月次サマリー}

**商談パイプライン**
| ステージ | 件数 | 金額 | 前月比 |
|----------|------|------|--------|
| {ステージ名} | {件数} | {金額} | {前月比} |

**新規商談の獲得チャネル分析**
{チャネル別の分析}

**注目ポイント**
{前月比で変動が大きい項目のコメント}

**次月のアクション推奨**
{データに基づいた推奨アクション}
あとは、Claudeに「skills/monthly-sales-report/ のSKILL.mdを読み込んで、対象月の月次営業レポートを生成してください。宛先は経営会議向けです」と指示するだけで実行されます。
スキル作成の現実的なアプローチは、最初から完璧な仕様書を書こうとせず、うまくいった業務をそのままパッケージ化する 方法です。
まず普通に業務を実行させます。初めての業務は、対話形式で細かく指示を出しながら進めます。「こういうレポートを作って」「ここはもう少し詳しく」「この数字も入れて」と、修正を重ねながら理想の成果物を完成させます。次に、成果物の品質に満足できたら「今後もお願いしたいからスキル化して」と伝えます。Claudeは直前の作業フロー全体を分析し、SKILL.mdとテンプレートを自動生成します。以降は、スキルが保存されれば、次回からは「今月の月次レポートを作成して」と指示するだけで、同じ手順とフォーマットでレポートが生成されます。プログラミング知識は必要ありません。
スキルをゼロから作ってもらうことも可能です。たとえば「X(旧Twitter)の投稿分析スキルを作成してください。直近30日間の投稿データを分析し、エンゲージメント率の高い投稿を抽出し、投稿時間帯別のパフォーマンスを分析して、次回投稿の最適な時間帯と内容パターンを提案する機能を含めてください」と伝えれば、Claudeは対話形式で要件を確認しながらSKILL.mdとテンプレートを生成します。
この「まず手作業で成功させる → スキル化して自動化する」というサイクルが、AIエージェント活用の基本パターンだと考えています。Claude Codeを使った経営データの可視化やコンテンツマーケティングにも、こうした考え方が活かされています。
| 原則 | 内容 |
|---|---|
| 1スキル1業務 | 「営業レポート生成」と「営業戦略提案」は別スキルにする |
| 入出力を明確に定義 | 何を渡して何が出てくるかを具体的に記述する |
| 品質基準は数値で | 「わかりやすく」ではなく「1文50文字以内」と定量化する |
| エラーケースを想定 | データ0件時・API失敗時の挙動を事前に決めておく |
1スキル1業務の原則は、スキル設計で最も守られにくい部分です。レポート生成と戦略提案を1つに詰め込みたくなるのは、人間の頭の中では連続した作業だからです。しかし前者は集計作業で、後者は意思決定です。集計はAIに任せられますが、意思決定は人間が担うべき領域なので、分けておかないとレビューの粒度が合わなくなります。
粒度の目安としては、「1回の指示で完結する業務単位」が扱いやすい範囲です。年次予算策定のような大きな業務は、データ収集・分析・資料作成の3スキルに分解することをおすすめします。ただし、繰り返し発生しない一度きりの作業までスキル化すると、使われない仕様書の管理コストだけが残ります。スキル化の対象は「来月もまた同じ依頼をするか」で判断してください。
MCP(Model Context Protocol)は、AIモデルが外部ツールやデータソースに安全に接続するための標準プロトコルです。USB-Cのような存在とイメージすると理解しやすいかもしれません。USBがどんなデバイスでも同じポートで接続できるように、MCPを使えばClaudeはfreee・HubSpot・Notion・Slackなどに統一的な方法で接続できます。
Claude Desktopの場合は ~/Library/Application Support/Claude/claude_desktop_config.json(macOS)または %APPDATA%\Claude\claude_desktop_config.json(Windows)、Claude Codeの場合は ~/.claude/claude_code_config.json またはプロジェクトルートの .claude/settings.json に記述します。
{
  "mcpServers": {
    "freee": {
      "command": "npx",
      "args": ["-y", "@anthropic-ai/freee-mcp"],
      "env": {
        "FREEE_CLIENT_ID": "your-client-id",
        "FREEE_CLIENT_SECRET": "your-client-secret"
      }
    },
    "hubspot": {
      "command": "npx",
      "args": ["-y", "@anthropic-ai/hubspot-mcp"],
      "env": {
        "HUBSPOT_ACCESS_TOKEN": "your-access-token"
      }
    },
    "notion": {
      "command": "npx",
      "args": ["-y", "@anthropic-ai/notion-mcp"],
      "env": {
        "NOTION_API_KEY": "your-notion-api-key"
      }
    }
  }
}
複数のMCPサーバーを同時に接続できます。ただし接続数が多いとClaudeの起動時間が若干長くなる場合があるため、実際に使うものだけを接続しておくほうが快適です。
| MCPサーバー | できること | 事前準備 |
|---|---|---|
| freee MCP | 試算表の取得、取引一覧の検索・集計、勘定科目別の月次推移分析、請求書の作成・取得 | freee開発者ページでOAuthアプリを作成しClient ID / Secretを取得 |
| HubSpot MCP | コンタクト・会社・取引の検索・取得、プロパティ情報の取得、オーナー検索、オブジェクトの作成・更新 | 管理画面の「設定 > 連携 > プライベートアプリ」でトークン発行 |
| Notion MCP | ページの検索・作成・更新、データベースの検索と行追加、コメント取得・追加 | 「設定とメンバー > コネクト > インテグレーション」でAPIキー取得 |
freee MCPでは、Claudeを起動すると自動的にOAuth認証フローが開始され、ブラウザでfreeeアカウントとの連携を承認します。確定申告の準備をClaudeに任せる使い方もあり、会計処理の効率化に直結する領域として注目されています。
HubSpot MCPでは、必要なスコープ(crm.objects.contacts.read 等)を選択してトークンを発行します。YouTube台本からNotionページを自動生成するような使い方もあり、構造化されたドキュメントを短時間で作成できます。
MCPは単体で価値が出るものではなく、業務フローの「データ取得」の位置に置くことで意味を持ちます。整理すると次のような流れになります。
outputs/ に出力するHubSpotで言えば、コンタクト → 取引 → 顧客 → 請求という一連のデータの流れがCRM側に揃っていることが前提になります。ここが分断されていると、MCPで取得できるデータも断片的になり、レポートの精度が上がりません。AIエージェントの精度問題は、実はCRM側のデータ設計の問題であることが少なくないと考えています。
Claude Codeの場合、起動時にMCPサーバーの接続状況がターミナルに表示されます。接続に成功すれば、「freeeから今月の売上を取得して」と指示するだけでデータが取得されます。接続エラーが発生する場合は、APIキー・トークンが正しいか、必要なスコープが設定されているか、MCPサーバーのパッケージが最新バージョンか、ネットワーク接続が有効かを確認します。
初期設定やエラー対応を含め、分からないことはClaudeに直接聞くのが基本的な進め方です。「MCPの接続でエラーが出た」といった技術的な問題も、Claudeに相談すれば必要なコマンドやファイルの編集を実行してくれます。
環境が整ってくると、次に効いてくるのが指示の質です。細かなプロンプト技法を覚えるより、実現したい状態を高い解像度で言語化するほうが効果があります。「願望の質=アウトプットの質」という原則を意識するとよいと考えています。
指示には、目的(What:何を作成・実行してほしいか)、対象(Where:どのファイルやデータを使うか)、条件(How:出力形式・制約条件・品質基準)の3要素を含めます。
たとえば「今月の売上レポートを作って」ではなく、次のように伝えます。
freee MCPから対象月の損益データを取得し、
勘定科目別の前月比増減を分析して、
outputs/reports/ に保存してください。
金額は千円単位、増減率は小数点1桁で表示してください。ただし、毎回この長さの指示を書くのは現実的ではありません。だからこそ、CLAUDE.mdに前提条件を、スキルに処理手順を定義しておきます。それが済んでいれば、日常的な指示は「今月の月次レポートを作成して」の一行で足ります。
長い指示を書き続けるか、一度書いて仕組みに落とすか。この選択が、AI活用が個人技で終わるか組織の資産になるかの分かれ目になります。
役割分担を曖昧にしたまま自動化を進めると、事故が起きます。実務で置いておくとよいと考えている線引きは次のとおりです。
| AIに任せる | 人間が判断する |
|---|---|
| CRM・会計データの取得と集計 | パイプラインのステージ設計と受注確度の設定 |
| 前月比の算出と変動箇所の抽出 | レポートを受けての事業判断 |
| レポート・議事録の下書き生成 | 顧客への最終的な送信可否 |
| フォルダ整理・ファイル命名の統一 | 機密情報の取り扱い範囲の決定 |
| スキル仕様書の初版作成 | スキルの品質基準そのものの定義 |
特に重要なのが、外部に出るアウトプットの最終確認です。顧客向けのメールや提案書については、AIの生成物をそのまま自動送信する設計にはせず、人間のレビューを挟む運用をおすすめします。金額の大きい案件ほど、この原則を厳格に守ったほうが安全です。
個人利用から組織利用に移る段階で、権限設計の検討が欠かせません。ここを後回しにすると、あとから戻すのが難しくなります。
MCPを通じてClaudeが外部システムにアクセスする際は、最小権限の原則に従います。freeeは読み取りのみ必要な場合は書き込み権限のないAPIキーを使い、HubSpotは必要なスコープのみを選択し、Notionは連携するページ・データベースを限定します。
APIキーやトークンは環境変数またはMCPの設定ファイルで管理し、CLAUDE.mdやスキルファイルには直接記述しないようにします。Gitリポジトリを使用する場合は、設定ファイルを .gitignore に追加して漏洩を防ぎます。
フォルダをGitHubやGoogle Drive等でチーム共有する際は、フォルダ単位でアクセス権限を設計します。経営層は全フォルダにアクセスでき、マーケティングのメンバーはマーケティングフォルダのみにアクセスできる、という設計です。
ここが重要なポイントで、各メンバーのClaudeが読み込める情報も、そのフォルダ権限によって自動的に制限されます。つまり「AIに見せてよい情報の範囲」を、人間のアクセス権限と同じ仕組みで管理できるということです。AI専用の権限管理を別途作る必要がなくなるため、運用負荷が大きく下がります。
Claude Desktop(Cowork)では、MCPサーバーの設定に加えてプラグインシステムが利用できます。プラグインはスキル・コネクタ・コマンド・サブエージェントをひとつにまとめた「全部入りパッケージ」とイメージすると理解しやすいと考えています。ワンクリックでインストールでき、個別のAPI設定は不要です。
| プラグイン | 連携先 | 主な機能 |
|---|---|---|
| Google Workspace | Gmail・Drive・Calendar | メール下書き・ドキュメント検索・予定管理 |
| Slack | Slackチャンネル | メッセージ要約・返信下書き |
| DocuSign | 契約管理 | 契約書送付・ステータス確認 |
| Apollo | 営業データ | リード情報取得・企業データ分析 |
| FactSet | 金融データ | 財務分析・市場データ取得 |
Enterpriseプランでは、管理者がカスタムプラグインを作成し、プライベートマーケットプレイスで組織内に配布できます。あわせてSSOによるアクセス制御、メンバーごとのプラグイン利用制限、タスク実行履歴の監査ログ、ドメインキャプチャによるシャドーIT防止、データがモデルのトレーニングに使用されない保証といった機能が利用できます。
ただし、Enterpriseプランの機能は組織規模がある程度の水準に達してから検討すれば十分です。数名のチームであれば、フォルダ権限とMCPのスコープ設計だけでも実用的な統制は効きます。
Coworkのスケジュール機能を使うと、定型業務を定期的に自動実行できます。毎週月曜の朝に先週のHubSpot商談サマリーを生成してSlackに投稿する、毎月末にfreeeの月次財務レポートを生成してNotionに保存する、といった設定が可能です。
スキルとスケジュールを組み合わせると、「設定しておけば定期的に成果物が生成される」環境になります。ただし、生成物を誰がいつレビューするかを決めずに定期実行だけ設定すると、誰も読まないレポートが溜まり続けることになります。自動化とレビュー責任者の設定はセットで考えることをおすすめします。
環境構築・スキル・MCPが揃ったあとの発展形が、複数エージェントの並列運用です。ただしこれは全員が必要とする段階ではないので、自社が今どこにいるかを見極めてから着手してください。
コンテキストウィンドウ(AIが一度に処理できる情報量)には上限があるため、1体に複数の業務を同時に任せるとコンテキストの上限を超えて品質が低下します。人間の組織と同じように、AIにも役割分担が必要です。
実務で扱いやすいのは3〜5体の並列稼働です。Claude Codeのターミナルタブ(またはClaude Desktopの複数ウィンドウ)を3〜5個開き、それぞれに異なる役割を割り当てます。
[タブ1] マーケティング担当: ブログ記事の執筆・品質レビュー
[タブ2] 営業支援担当: CRMデータ分析・提案資料作成
[タブ3] 経営管理担当: 会計データ取得・月次レポート生成
[タブ4] リサーチ担当: 競合調査・市場分析
2体では分業の効果が薄く、10体以上になると人間のマネジメント負荷が高くなりすぎます。3〜5体であれば、1人がすべてのエージェントの進捗をモニタリングしながら指示を出せる範囲に収まります。
各エージェントには、それぞれのCLAUDE.mdで役割と人格を定義します。前述の人格規定と組み合わせれば、楽観派のクリエイターエージェントと悲観派のレビュアーエージェントが同じ成果物を別角度からチェックする体制を作れます。
複数のエージェントが同時に作業する場合は、ファイルの競合を防ぐ連携ルールが必要です。共有ファイル(例: AGENT_SYNC.md)に各エージェントの作業状況を記録し、他のエージェントがその状態を確認してから次のアクションを取る設計にします。詳しい実装パターンは「Claude × 業務自動化の全体像」で解説しています。
全社一斉導入はリスクが大きいため、段階的に進めることをおすすめします。
| フェーズ | 期間の目安 | やること | 完了の判断基準 |
|---|---|---|---|
| Phase 1 環境構築 | 1〜2日 | インストール、プロジェクトフォルダ作成、ディレクトリ設計、CLAUDE.md初版作成 | 短い指示でも意図が通じる状態になった |
| Phase 2 単一業務の自動化 | 1〜2週間 | 1つの業務でスキルを作成、品質をチューニング、CLAUDE.mdを実運用に合わせて更新 | 同じスキルを3回実行して品質が安定した |
| Phase 3 MCP接続と範囲拡大 | 2〜4週間 | freee・HubSpot・Notion等を接続、データ取得→分析→レポート生成のフロー構築 | 外部データを使ったレポートが手作業なしで出る |
| Phase 4 組織展開 | 1〜3ヶ月 | マルチエージェント導入、定期タスクの自動化、他部門への横展開、運用ルール整備 | 作った本人以外が同じ成果物を再現できる |
すべてを一気に進めるのは難しいので、自社で効果が出そうな業務を見極めて優先順位をつけ、やりやすいところからトライしていただくのがおすすめです。まずは月次で繰り返している定型レポート1本をスキル化するところから始めて、うまくいったら隣の業務に広げる、という進め方が現実的です。
プロジェクトのルートフォルダ(最上位フォルダ)に配置します。サブフォルダにも追加のCLAUDE.mdを配置でき、Claudeは作業フォルダから上位に向かってすべてのCLAUDE.mdを読み込みます。最初はルートに1枚だけ置き、部門ごとのルールが増えてきた段階でサブフォルダに切り出すのが運用しやすい進め方です。
「1回の指示で完結する業務単位」が目安です。たとえば月次レポート生成は1スキル、年次予算策定はデータ収集・分析・資料作成の複数スキルに分解するのが適切です。集計のような作業と、提案のような意思決定が混ざっているスキルは、レビューの粒度が合わなくなるため分けることをおすすめします。
明確な文字数制限はありませんが、記述内容はコンテキストウィンドウを消費するため、必要な情報を簡潔に記述することが推奨されます。目安として1,000〜3,000文字程度に収めると、他の作業に使えるコンテキストを十分に確保できます。詳細な手順はCLAUDE.mdではなくスキル側に持たせると、全体が整理されます。
スキルの作成・カスタマイズにはClaude Codeが適しています。作成したスキルをGUIで簡単に呼び出したい場合は、Claude Desktop(Cowork)のプラグインとしてパッケージ化する方法があります。設計はエンジニアがClaude Codeで行い、日常利用は各部門がCoworkで行う、という分担も現実的です。
Cursor(コードエディタ)と連携させることで、ターミナル操作に不慣れな方でもClaude Codeの機能を活用できます。ただし、最も手軽に始めるにはClaude Desktop(Cowork)から入るのが無理のない順序です。スキルを自作したくなった段階でClaude Codeに移行すれば十分です。
Claude Coworkの使い方の核心は、ツールの操作手順ではなく、AIに毎回説明しなくて済む環境をどう常設するかにあります。本記事の要点を整理します。
最初の一歩としては、毎月繰り返している定型レポートを1本だけ選ぶ ところから始めてください。次の3ステップで進められます。
inputs/ と outputs/ に分けるここまで進めば、翌月からは一行の指示で同じ品質のレポートが出る状態になります。そのうえでMCP接続に進めば、データ取得も自動化されます。なお、どの業務から着手するかは事業の形によって変わりますので、企業様によって最適な形は異なります。文書やレポートという成果物が繰り返し発生する業務に絞って選ぶのが、効果を実感しやすい進め方です。
このテーマの全記事はClaude Code実践ガイドでご覧いただけます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。
