

この記事の結論
リサーチは「情報を集める作業」ではなく「意思決定に使える形に落とす作業」です。ChatGPT Deep Researchを業務に組み込む鍵は、出力をどこに蓄積し、誰が検証するかを先に決めること。
リサーチは「情報を集める作業」ではなく「意思決定に使える形に落とす作業」です。ChatGPT Deep Researchを業務に組み込む鍵は、出力をどこに蓄積し、誰が検証するかを先に決めること。
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
リサーチは「情報を集める作業」ではなく「意思決定に使える形に落とす作業」です。ChatGPT Deep Researchを業務に組み込む鍵は、出力をどこに蓄積し、誰が検証するかを先に決めること。
「競合調査を頼むと、担当者によって切り口も深さもバラバラになる」「調べた結果がスプレッドシートや個人のローカルに散らばって、次に誰も参照できない」「レポートは上がってくるが、出典が追えないので経営会議で使えない」——こうした声は、リサーチ業務を抱える多くの現場で共通しています。
ChatGPT Deep Researchとは、OpenAIが提供する深層調査機能で、Web上の複数の情報源を自律的に探索・分析し、出典付きのレポートを自動生成するものです。従来は何時間もかかっていた調査作業を、数分から最長30分程度で完了できる点が特徴です。ただし、ツールを契約すれば調査品質が安定するわけではありません。本記事では、機能の仕組みに加えて「業務フローのどこに置くか」「出力をどう資産化するか」まで踏み込んで整理します。
本記事はStartLinkの「AI活用完全ガイド」関連記事です。
この記事では、ChatGPT Deep Researchを「便利な検索の代わり」としてではなく、自社の調査業務の仕組みとして組み込むための設計を整理しています。
スプレッドシートや個人フォルダでのリサーチ管理に限界を感じている、マーケティング・営業企画・経営企画の方に向けて書いています。最後まで読むと、Deep Researchを自社の意思決定フローに組み込んだ仕組みとして設計できるようになります。
Deep Researchは、キーワードに合致するページを並べる検索エンジンとは役割が異なります。集めた情報の中から何が重要か、どの情報源が信頼できるかを判断してから、ひとつのレポートに構成するところまでを担います。まずはこの違いを押さえておくと、後述する活用設計の判断がしやすくなります。
Deep Researchは、最新の「o3」モデルを使って、ウェブ上の膨大な情報を自動で集め、分析し、ひとまとめのレポートとして出力してくれるサービスです。ある商品について知りたい情報があれば、キーワードを入力するだけで、複数のサイトからデータを抽出し、出典付きの情報にまとめてくれます。同じくOpenAIが提供する自律型エージェント「ChatGPT Operator」と合わせて注目されている機能です。
私たちがAI活用のご相談をいただくときにお伝えしているのは、AIの出力は「超一流の専門家の最終報告書」ではなく「調査アシスタントが持ってきた一次成果物」として扱うのが現実的だということです。方向性と論点の当たりをつけてくれる存在として位置づけると、期待値がずれません。
以下の画面は、ChatGPTでDeep Researchを実行している様子です。指示文を入力すると、調査の進行と生成されたレポートが画面上で確認できます。
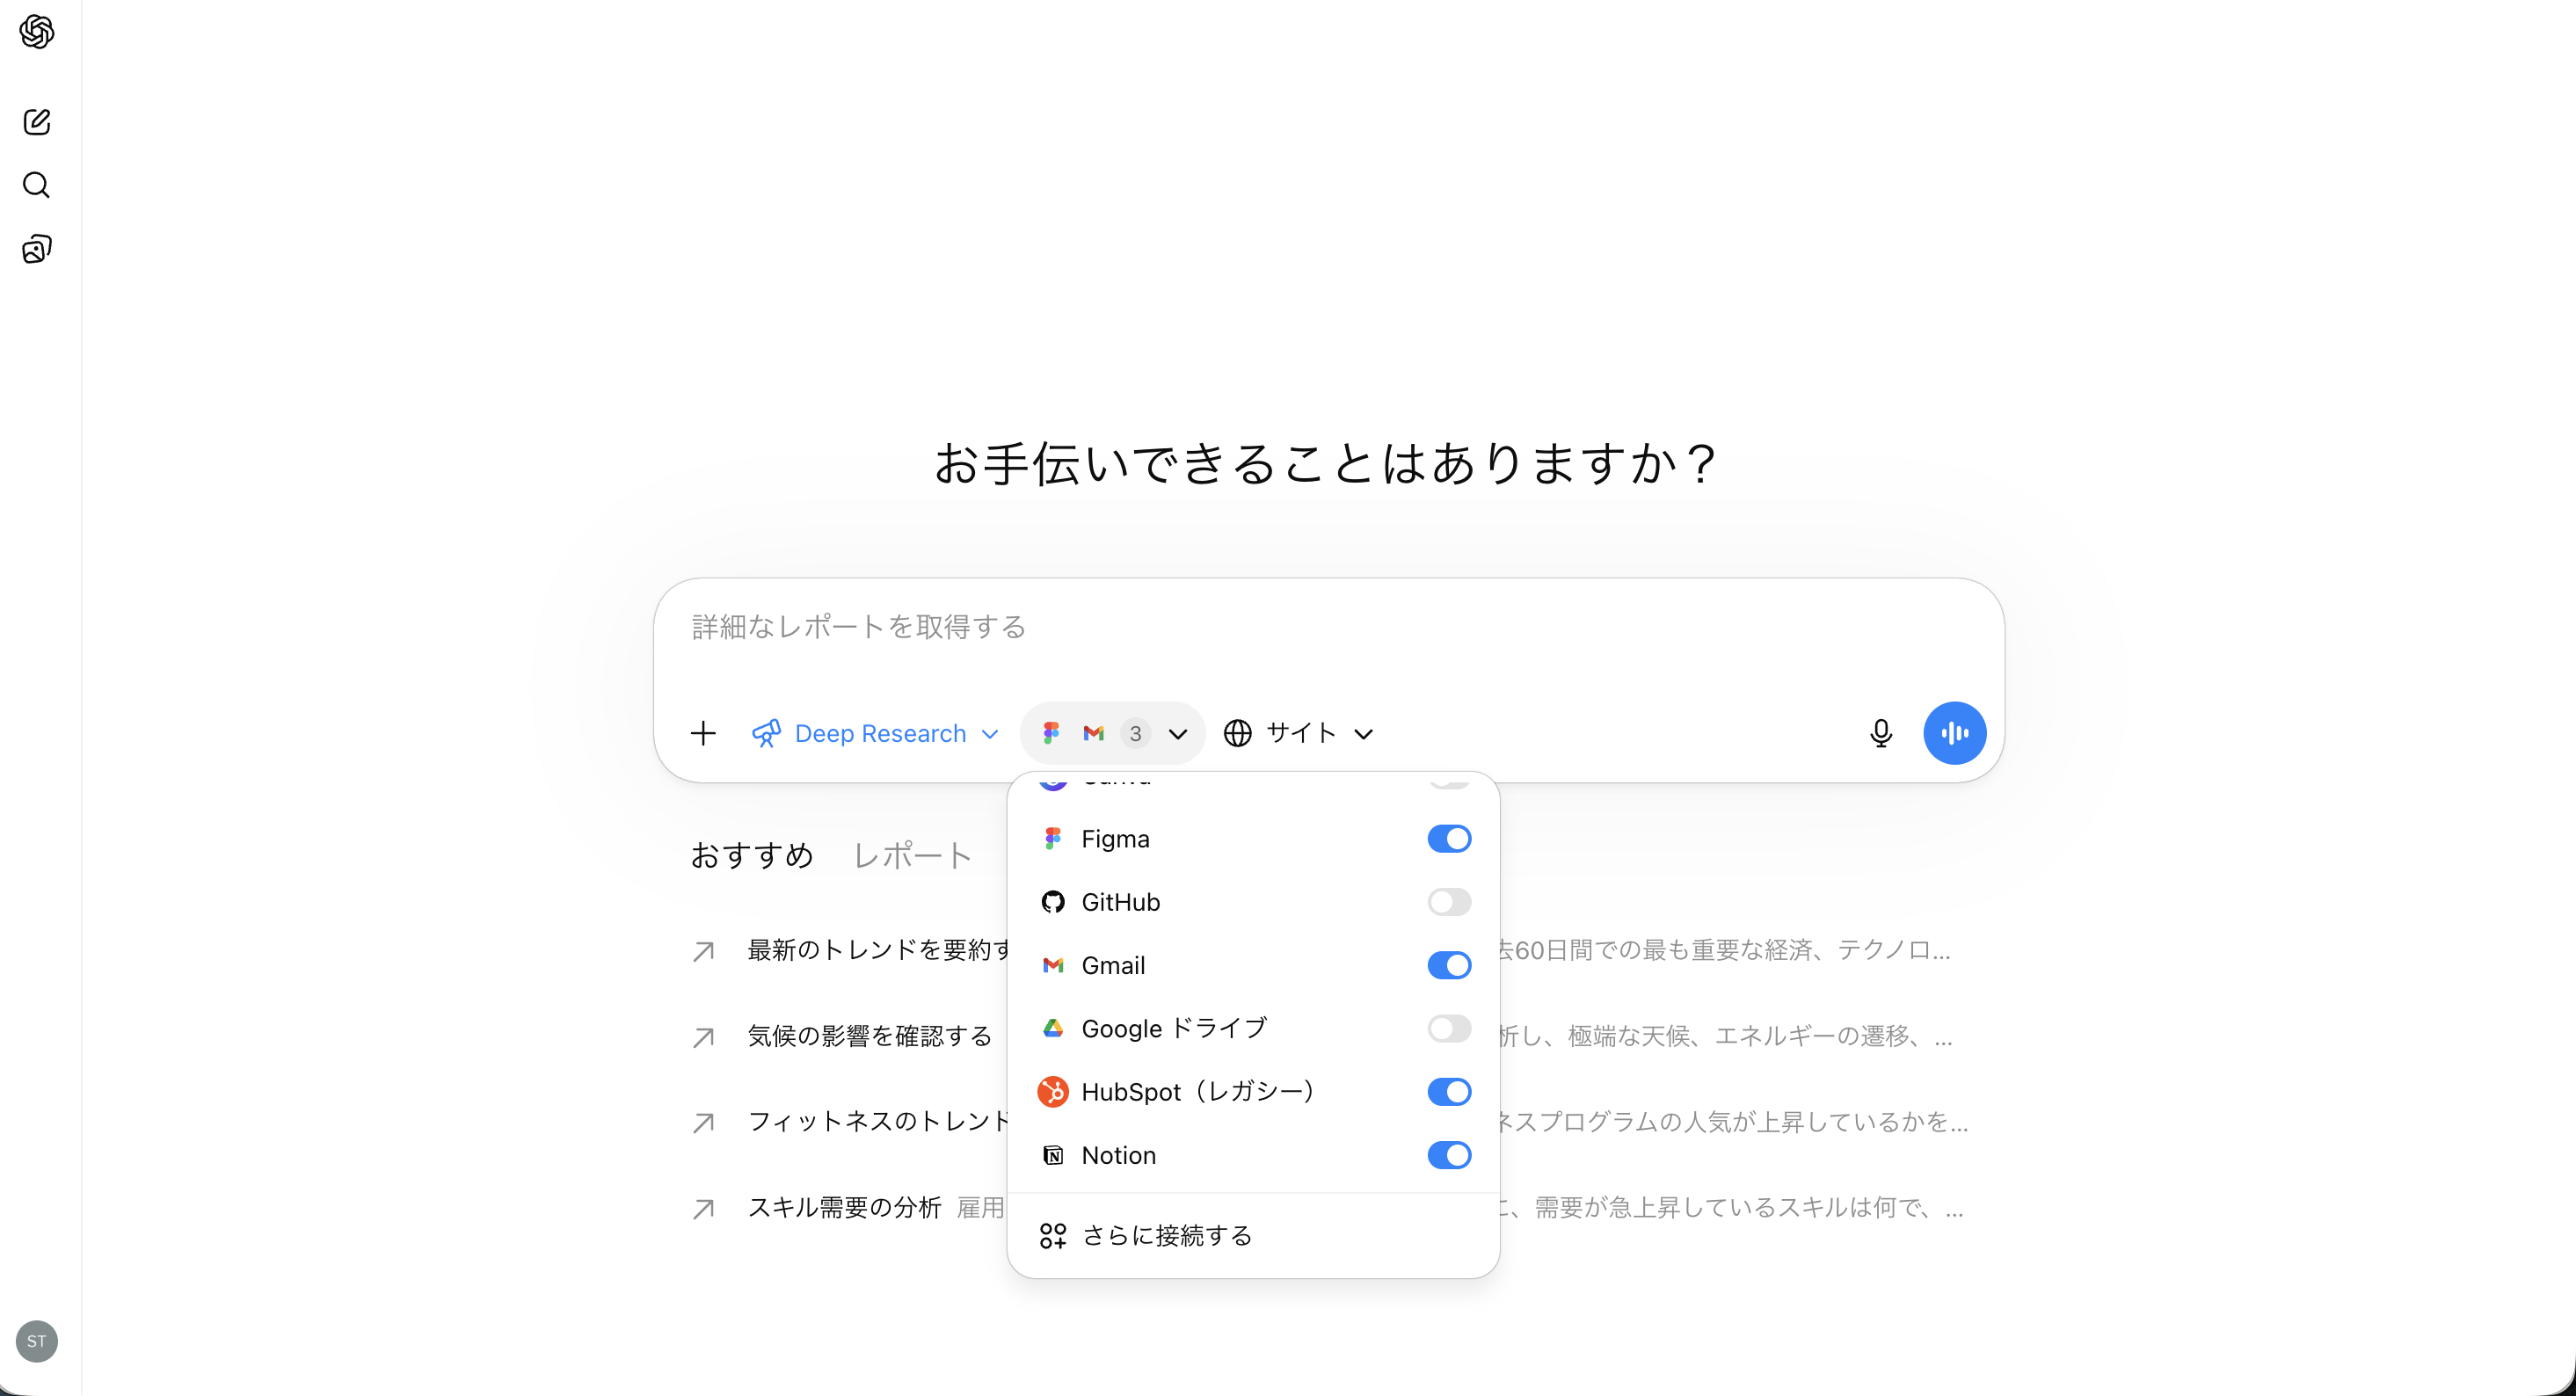
Deep Researchの特徴は、ただ情報を集めるだけではなく、何が重要なのか、どの情報が信頼できるのかを自動で判断する「多段階推論プロセス」にあります。具体的には次のステップで動作します。
| フェーズ | 実行内容 | 実務での効き所 |
|---|---|---|
| 情報収集 | 複数のウェブサイトやPDF、画像などから関連情報を横断的に収集 | 調査範囲の広さを、指示文の具体性でコントロールする |
| 分析と推論 | 集めた情報から必要なデータや論点を抽出し、信頼できるかを判断 | 何を論点とするかを事前に指定すると精度が変わる |
| レポート作成 | 分析結果を出典付きで整理し、読める形のレポートに仕上げる | 出力フォーマットを指定して社内の様式に合わせる |
出典: ChatGPT Deep Research徹底解説 利用回数制限は?
この3フェーズのうち、成果物の質を左右するのは実は最初の指示文です。「〇〇業界について調べて」と投げるのと、「〇〇業界の上位プレイヤーを、提供価値・価格帯・ターゲット企業規模の3軸で比較し、それぞれの出典URLを付けて」と投げるのでは、分析フェーズで抽出される論点が変わります。プロンプト設計は人間側の仕事として残る領域です。
Deep Researchは、Pythonを使ったデータ解析もできるため、単なるテキストのまとめだけでなく、グラフやチャートとして数値データを視覚的に表示することが可能です。例えば、売上の推移や市場シェアの変化など、数字で表すデータも分かりやすくまとめることができ、経営判断やマーケティング戦略の策定に役立ちます。こうしたデータ分析の自動化についてはAIデータ分析ツール比較でも各ツールの特徴を解説しています。
ただし、可視化された図表をそのまま社外資料に載せるのは避けた方がよいと考えています。グラフの元になった数値がどの出典から来たものかを人間が一度確認する手順を挟むだけで、後工程の手戻りが大きく減ります。
出典: ChatGPTが新機能「deep research」をリリース!性能やできることを紹介
Deep Researchはプランによって月間の利用回数上限が異なります。ここで大事なのは料金の比較そのものではなく、社内の誰にどれだけのリサーチ回数を割り当てるかという配分設計です。上限があるからこそ、使う場面を決める必要が出てきます。
2025年時点では、Deep ResearchはChatGPT Proプラン(月額200ドル)のユーザーに加え、Plusプラン(月額20ドル)のユーザーも利用できます。プランによって月間クエリ数の上限が異なり、Proプランは月間100クエリ、Plusプランはより少ない利用制限が設けられています。Team、Enterprise、無料プランへの段階的な展開も進んでいます。
| プラン | 月額 | 月間クエリ数の目安 | 想定する使い方 |
|---|---|---|---|
| Pro | 200ドル | 月間100回 | 調査を主業務に持つ担当者・高頻度のリサーチ |
| Plus | 20ドル | Proより少ない上限 | 部門内で月数回〜のスポット調査 |
| Enterprise | 大企業向け提供 | 拡張機能とカスタマイズ性が提供される | 全社展開・情報管理要件がある組織 |
出典: OpenAI launches new AI tool to facilitate research tasks / ChatGPT 新機能『Deep Research』徹底解説&使用レビュー
この表を読むときの視点は、月額の大小ではなく「1クエリをどの業務に使うか」の設計です。月間100回という枠も、四半期に1回の大型調査に使うのか、週次の競合チェックに割り振るのかで意味合いが変わります。調査が単発のイベントなのか、定例の業務プロセスなのかを先に決めておくと、プランの妥当性を判断しやすくなります。
上限が明確なツールで起きがちなのが、「全員のアカウントを用意したが、結局誰も使い方がわからず残枠だけが積み上がる」という状態です。私たちがCRM導入で一貫してお伝えしているスモールスタートの考え方は、ここでもそのまま当てはまります。
具体的には、まず1〜2名の担当者がPlusプランで着手し、月に数本のテーマで実際にレポートを出してみます。その中で「このテーマは明らかに時間削減になった」というパターンが見つかったら、その用途に限って対象者を広げ、必要になった段階で上位プランへ移ります。この順序にすると、費用の妥当性を自社の実績で説明できるようになります。
正直に書くと、Deep Researchが力を発揮しにくい領域もあります。Web上に情報が存在しない事柄、例えば自社の商談内でしか語られていない顧客の本音や、クローズドな業界慣習は、いくら指示を工夫しても出てきません。また、鮮度が数時間単位で問われる価格情報や在庫情報のような領域も、レポート生成後に前提が変わる可能性があります。
こうした領域は「AIが苦手」というより「そもそも情報源が外部にない」という問題です。この線引きを社内で共有しておくと、使えないケースに時間を投じるムダを防げます。
Deep Researchが特に力を発揮するシーンを整理すると、次の3つの領域に集約されます。いずれも「人が時間をかけて横断的に情報を集めていた作業」が対象になっている点が共通しています。
| 活用シーン | 具体的な用途 | 期待される成果 |
|---|---|---|
| 市場調査・競合分析 | 業界動向・競合他社の戦略把握 | 戦略立案にかかる期間の短縮 |
| 学術・専門リサーチ | 論文・技術資料の横断収集 | 文献調査の工数削減 |
| 購買・意思決定支援 | 製品比較・サービス評価 | 網羅的な情報収集で判断精度を高める |
新しい商品の市場動向や競合他社の動きを知りたいとき、従来は担当者が複数のサイトやレポートをチェックする必要がありました。Deep Researchを使えば、数多くの情報を自動で集め、重要なポイントだけを整理したレポートを得られます。これにより、マーケティング戦略や新規事業の計画をスピーディに進めることが可能です。実際の活用例については、ChatGPTの新機能「Deep Research」で市場調査が劇的効率化!スモールビジネスの競争力を強化をご覧ください。
営業の現場で応用しやすいのは、商談前の企業リサーチです。訪問先企業の事業内容・直近のプレスリリース・想定される課題仮説を事前にまとめておくと、初回商談の質が変わります。この調査結果を個人のメモに留めず、CRMの企業レコードのメモ欄に残す運用にすると、担当者が変わっても引き継げる形になります。
出典: ChatGPTの新機能「Deep Research」で市場調査が劇的効率化!スモールビジネスの競争力を強化
大学や研究機関でも、論文や学術資料を探すのに多大な時間を費やしているケースが少なくありません。Deep Researchは、複数の学術データベースやオンライン論文から効率的に情報を抽出し、出典付きのレポートにまとめるので、研究者は基礎調査の時間を削減できます。
出典: ChatGPT Deep Research徹底解説 利用回数制限は?
個人の生活でも、家電や車の購入、旅行の計画など、複数の情報を一括で整理してくれるため、比較検討の負担が軽減されます。専門知識がなくても、必要な情報がすぐに手に入るのは大きなメリットです。
企業の購買検討でも同じ構図が使えます。SaaSツールの選定時に、候補製品の機能・想定される導入形態・公開されている情報を横断でまとめてもらい、それをもとに社内の評価軸を作ります。この使い方であれば、最終判断は人間が握ったまま、比較表作成の下ごしらえだけをAIに任せられます。
出典: ChatGPTが新機能「Deep Research」をリリース!性能やできることを紹介
SNS上では、以下のような声が寄せられています。
「OpenAI Deep Research、科学研究への応用もすごいです。重要な論点を逃さず、新しいアイデアまで引き出してくれる!」
— 紺野 大地(@_daichikonno)
「Deep Research は従来の検索ツールとは全く違います。情報の集約だけでなく、分析もしてくれるので、仕事の効率が劇的に上がりました。」
— 河津 大誠(@taisei_kawazu)
Deep Researchを業務に入れるとき、最も事故が起きやすいのは「出力をそのまま最終成果物として扱ってしまう」ケースです。ここは機能の性能問題ではなく、運用設計の問題として切り分ける必要があります。
私たちはAI活用のご支援で、「AIに任せる範囲」と「人間が判断する範囲」を表にして関係者と合意する進め方をおすすめしています。Deep Researchの場合、次のような整理になります。
| AIに任せられること | 人間が判断すべきこと |
|---|---|
| Web上の情報を横断的に収集する | 何を調べるか(論点設定) |
| 情報を論点ごとに分類・要約する | 出典の妥当性・情報の鮮度の最終確認 |
| 比較表やグラフの下書きを作る | 社外・経営会議に出す前の事実確認 |
| 複数情報源からの矛盾点を提示する | 自社の戦略としてどう解釈するか |
| 定型フォーマットへの整形 | 数字を根拠に意思決定すること |
この線引きで重要なのは、右側を減らそうとしないことです。右側は「AIが進化すれば消える作業」ではなく、事業の責任が伴う判断そのものです。ここを残す前提で設計すると、AI活用が現場に受け入れられやすくなります。
AIが「幻覚(ハルシネーション)」と呼ばれる誤った情報を出力するリスクは残ります。OpenAIはすべての出力に対して出典を明記し、ユーザーが元情報を確認できる仕組みを取り入れていますが、これを実際に確認するかどうかは運用側に委ねられています。
ここを「気をつけましょう」という注意喚起で済ませると、ほぼ属人化してしまいます。おすすめしたいのは、レポートを社内共有する際の手順に検証ステップを組み込んでしまうことです。例えば、共有フォーマットに「主要な数値の出典URL」「確認者名」「確認日」の欄を設け、埋まっていないものは共有しないというルールにします。人の意識ではなく仕組みで担保する形にすると、新しく入ったメンバーでも同じ品質で回せます。
出典: ChatGPT 新機能『Deep Research』徹底解説&使用レビュー
AIが扱う情報に個人情報や機密情報が含まれないよう、入力してよい情報の範囲を事前に定めておく必要があります。加えて、誤用や不適切な利用を防ぐための利用ガイドラインを定め、利用者への教育を行うことも重要です。特にリサーチ用途では、顧客名や取引条件を含むプロンプトを書いてしまいがちなので、「調査目的では実名を入れない」といった具体的なレベルまで落として共有するのが現実的です。
出典: ChatGPT 新機能『Deep Research』徹底解説&使用レビュー
Deep Researchの導入で最も残念なのは、優れたレポートが生成されたのに、それが個人のチャット履歴やローカルフォルダに埋もれてしまうことです。ここが、単発のツール導入と業務の仕組み化を分ける分岐点になります。
多くの企業で、リサーチ結果は「調査結果_競合分析_最終版.xlsx」のようなファイルとして蓄積されています。この管理方法には構造的な問題があります。ファイル名の付け方が人によって違う、誰がいつ作ったかが辿れない、そして何より「その調査が結局どの商談・どの顧客の話だったのか」が紐づかないことです。
結果として、半年後に同じ企業を調べ直すことになったり、営業が知りたい情報がマーケティング部門のフォルダに眠っていたりします。情報が分散していると、過去のやり取りを一覧で確認できなくなるのが最大の損失です。
スプレッドシート管理が抱える問題は、調査結果の置き場所をCRMに寄せることで構造的に解決できます。HubSpotのようなリレーションデータベース型のCRMでは、コンタクト・会社・取引・チケットが相互に紐づく構造になっています。
| 調査の種類 | 紐づける先 | 得られる効果 |
|---|---|---|
| 商談前の企業リサーチ | 会社レコードのメモ・カスタムプロパティ | 担当者が変わっても背景情報が残る |
| 業界・市場動向の調査 | ナレッジとして社内共有領域に格納 | マーケと営業が同じ前提で話せる |
| 競合比較の調査 | 取引レコードの競合プロパティ | 失注分析時に競合別の傾向が見える |
| 製品・サービス評価 | 社内検討用のレコードやノート | 検討経緯が後から辿れる |
特に効いてくるのが、競合情報と失注分析の組み合わせです。Deep Researchで競合の訴求内容を整理し、それを取引の失注理由プロパティと突き合わせると、「どの競合に、どういう理由で負けているか」が定量的に見えてきます。ここまで来ると、営業が感覚で語っていた競合の強みが、レポートとして経営会議に出せる形になります。失注理由を価格・競合・製品機能・時期・社内決裁といったカテゴリーで分類しておくと、円グラフで可視化して部門間で共有しやすくなります。
Deep Researchは単独の便利機能ではなく、コンタクト獲得から商談、受注、その後の関係構築までの一気通貫フローの中に位置づけると価値が出ます。私たちが整理するなら、次のような配置になります。
この4点のうち、どこから着手するかは企業様によって異なります。インバウンドの問い合わせが多い企業様なら1と2の効果が出やすく、特定業界を攻める企業様なら3と4の方が効きます。最適な形は事業モデルによって変わるので、自社のどのプロセスにボトルネックがあるかを見てから決めると判断がぶれにくいです。
企業が持つ販売データ、顧客フィードバック、在庫情報などの内部データと、インターネット上の市場動向や競合情報を統合することで、リアルタイムな市場分析が可能になります。この際に使われる技術がRAG(Retrieval-Augmented Generation、外部情報を検索して回答生成に使う手法)です。
ただし、ここは段階を踏むべき領域です。自社データの入力ルールが整っていない状態でAIに参照させても、出てくる答えの精度は上がりません。まずはCRM上のデータが最低限の粒度で揃っている状態を作ることが先で、AI連携はその次の段階です。順序を逆にすると、結局「AIの答えが当てにならない」という評価で止まってしまいます。
ツール契約から全社活用までを一気に進めようとすると、多くの場合は途中で止まります。段階を分けて、それぞれで判断材料を作りながら進めるのが現実的です。
最初はPlusプランで1名が着手し、実際に効果が見込めるテーマを1つ選んでレポートを出してみます。このとき比較対象として「同じ調査を人手でやったら何時間かかるか」を事前に見積もっておくと、効果を自社の数字で語れるようになります。この段階で重要なのは、良いプロンプトの型を1つ作ることです。
うまくいったプロンプトを、テンプレートとして社内で共有できる形にします。「業界調査用」「競合1社深掘り用」「商談前企業リサーチ用」のように用途別に整理しておくと、AIに詳しくないメンバーでも一定品質の結果を得られます。
あわせて、出力を格納する先とフォーマットを決めます。前述の検証欄(出典URL・確認者・確認日)を入れた共有フォーマットをこの段階で確定させておくと、後から品質ルールを追加する手間がなくなります。
最後に、リサーチを「思い出したときにやる作業」から「プロセスの一部」に変えます。例えば、取引が特定のステージに進んだら企業リサーチを実施する、四半期ごとに競合動向を更新する、といった形でタイミングを決めてしまう方法です。
| 段階 | 主な作業 | 判断すべきこと |
|---|---|---|
| 第1段階 | 1テーマで試行、工数比較 | 自社業務で本当に効果が出るか |
| 第2段階 | プロンプト・フォーマットの標準化 | 誰でも同じ品質で使えるか |
| 第3段階 | 業務プロセスへの組み込み | どのタイミングで必須化するか |
ただし、3段階すべてを短期間で駆け抜ける必要はありません。第1段階で「思ったほど効果が出ない業務だった」と分かることにも価値があります。全社展開の前に小さく検証できるのが、この進め方の一番のメリットです。
外部情報の調査はDeep Researchのようなツールに任せる一方で、自社のナレッジに基づく回答は社内データを参照するAIに任せる、という役割分担も考えられます。
以下の画面は、当社サイトのプロダクトページに設置した「StartLinkサポートAI」のチャットで、公開ページの情報をもとに製品の機能説明と参照先URLを案内している様子です。
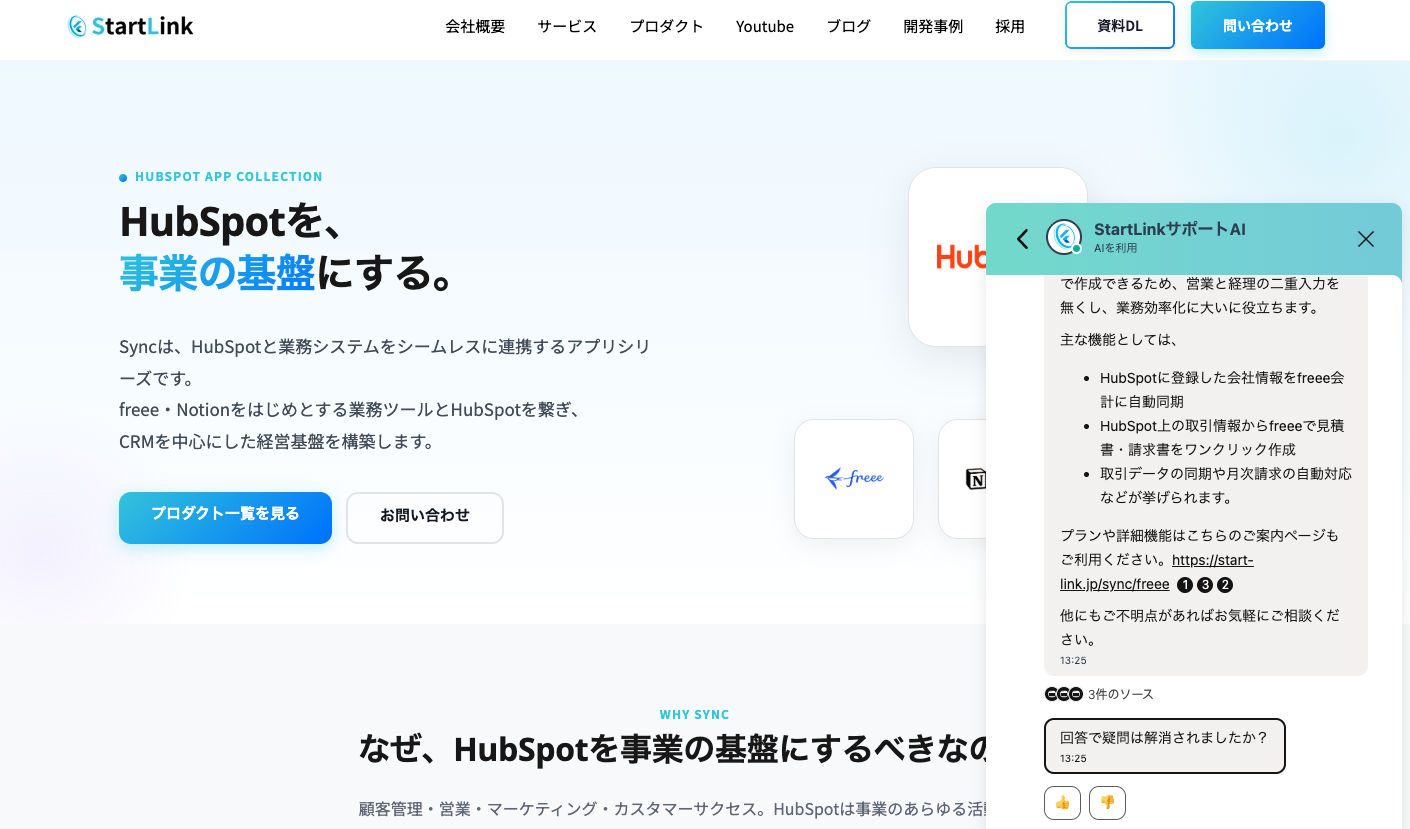
このように、外部リサーチ用のAIと社内ナレッジ参照用のAIを両輪で使い分けると、それぞれの得意領域を活かせます。HubSpotのAI機能であるBreezeについてはHubSpot AI「Breeze」の機能完全ガイドで解説しています。
AI機能は更新が続く領域なので、特定バージョンの性能に運用を依存させない設計が重要になります。ここでは基盤技術の方向性と、変化に耐える運用の作り方を整理します。
Deep Researchは、OpenAIの高度な推論モデル「o3」を基盤として構築されています。o3は、複雑な問題を多段階で考え抜く能力に優れており、Deep Researchが高品質なレポートを生成できる核心技術です。OpenAIは今後も推論モデルの継続的な改善を進めており、さらに複雑な市場分析や製品開発の戦略策定への対応力向上が期待されています。Claude Codeによる経営データの可視化でも、同様のアプローチが活用されています。
出典: OpenAI launches new AI tool to facilitate research tasks
一方で、モデルが進化しても変わらない前提が2つあります。1つは「何を調べるべきかを決めるのは人間」であること。もう1つは「調査結果を意思決定と行動に繋げる仕組みが必要」であることです。この2つに手を打っておけば、どのモデルに乗り換えても運用は続きます。
収集・解析された定量データは、経営陣が市場動向を把握し、迅速かつ的確な意思決定を行うための基盤になります。ここで効いてくるのが、AIが生成するグラフやチャート、ダッシュボードを活用して複雑な情報を直感的に理解できる状態にしておくことです。
ただし、外部調査のレポートだけでダッシュボードは完成しません。自社の商談数・受注率・失注理由といった内部の数字と並べて初めて、「市場はこう動いているが、自社の受注率はこうなっている」という比較ができます。外部情報と内部データを同じ画面で見られる状態を目指すと、リサーチの投資対効果が説明しやすくなります。
全社展開の判断材料として、数値で評価できる指標を最初に決めておくことをおすすめします。例えば、1テーマあたりの調査所要時間、レポートの社内利用回数、そのレポートを根拠に実行した施策の数といった項目です。
「便利だった」という感想ではなく、こうした指標で語れる状態にしておくと、次の投資判断がぶれません。逆に指標が決まっていないまま広げると、コストだけが積み上がって「なんとなく使っている」状態になりがちです。
ChatGPT Deep Researchは、OpenAIが提供するAI駆動の深層調査機能です。o3モデルを活用して、ウェブ上の複数の情報源を自律的に探索・分析し、出典付きの詳細なレポートを自動生成します。従来なら数時間かかっていた市場調査や文献調査を、数分〜30分程度で完了できるのが特徴です。ただし出力の最終確認は人間が行う前提で運用設計することをおすすめします。
2025年時点では、ChatGPT Plusプラン(月額20ドル)以上のユーザーが利用可能です。Proプラン(月額200ドル)では月間100クエリまで利用でき、Plusプランではそれより少ない制限内での利用となります。Team、Enterprise、無料プランへの段階的な展開も進んでいます。まずはPlusプランで1〜2名が試し、効果が確認できてから対象を広げる進め方が現実的です。
出力には出典が明記されるため、元情報を辿って確認できます。ただし確認するかどうかは運用側に委ねられるので、共有フォーマットに「主要な数値の出典URL」「確認者」「確認日」の欄を設け、埋まっていないものは社外に出さないというルールにするのが有効です。個人の注意深さに依存させず、手順として組み込むのがポイントになってきます。
Web上に情報が存在しない領域は不得手です。自社の商談でしか語られない顧客の本音、クローズドな業界慣習、数時間単位で変動する価格・在庫情報などは、指示を工夫しても正確な答えは得られません。これらはAIの性能ではなく情報源の有無の問題なので、社内で線引きを共有しておくとムダな試行を減らせます。
個人のチャット履歴やローカルフォルダに残すと、次に誰も参照できなくなります。商談前の企業リサーチは会社レコード、競合比較は取引レコードのように、CRM上の該当レコードに紐づけて保存するのがおすすめです。コンタクト・会社・取引が相互に紐づくリレーションデータベース型のCRMであれば、過去の調査と実際の商談結果をあわせて振り返れるようになります。
ChatGPT Deep Researchは、ウェブ上の情報収集を自動化し、出典付きのレポートを生成する機能です。ただし、成果を左右するのはツールの性能よりも「どの業務プロセスのどこに置くか」「出力を誰がどう検証するか」「結果をどこに蓄積するか」という設計部分です。
本記事の要点を整理します。
まずは、1つのテーマを選んで1名がPlusプランで試すところから始めてみてください。次の3ステップで進められます。
この3ステップが回り始めたら、対象テーマと利用者を段階的に広げていく形が進めやすいと思います。最適な設計は企業様の事業モデルや組織体制によって異なりますので、自社のどのプロセスにボトルネックがあるかを見極めてから範囲を決めていただければなと思います。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
本記事の執筆にあたって参照した公開情報は次のとおりです。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。
