この記事の結論
ファインチューニングとは、事前学習済みのLLM(大規模言語モデル)に追加データを学習させ、モデルの振る舞いをカスタマイズする手法です。まずプロンプトやRAGで要件を満たせるかを検証し、口調や出力形式の統一が課題として残ったときにファインチューニングを検討すると、必要な作業を見極めやすくなります。
ファインチューニングとは、事前学習済みのLLM(大規模言語モデル)に追加データを学習させ、モデルの振る舞いをカスタマイズする手法です。まずプロンプトやRAGで要件を満たせるかを検証し、口調や出力形式の統一が課題として残ったときにファインチューニングを検討すると、必要な作業を見極めやすくなります。
ファインチューニングとは、事前学習済みのLLM(大規模言語モデル)に追加データを学習させ、モデルの振る舞いをカスタマイズする手法です。まずプロンプトやRAGで要件を満たせるかを検証し、口調や出力形式の統一が課題として残ったときにファインチューニングを検討すると、必要な作業を見極めやすくなります。
「自社のAIチャットボットに、製品マニュアルを参照させたい」「回答の口調を揃えたい」「過去の問い合わせ履歴をAI活用に使いたい」。こうした目的に対して、ファインチューニングとRAGは異なる役割を持ちます。
RAGは外部の情報を回答時に参照する仕組みです。一方、ファインチューニングは学習例を通じてモデルの応答を調整します。導入時には、データの更新頻度、求める応答品質、コストと運用負荷を分けて考えると、手段を選びやすくなります。AIを業務に組み込む際の基本姿勢については「責任あるAI実装ガイド」で解説しています。
本記事では、ファインチューニングの基本概念から、RAGとの使い分け、実装手順、コストの考え方までを整理します。AI活用完全ガイドで、AI活用の全体像も確認できます。
自社のAIにどこまで独自の口調や出力形式を持たせるかを検討するために、次の点を整理しました。
企業様によって最適な形は異なります。自社の目的と、利用できるデータに照らして検討してください。
ファインチューニング(Fine-tuning)とは、事前学習済みの大規模言語モデルに特定のタスク向けのデータを追加学習させ、応答を調整する手法です。どの課題にも適用できるわけではありません。
この節では仕組みと、適用を検討する場面を整理します。検索で社内情報を参照させる方法との違いは「RAG構築の実践ガイド」もあわせてご覧ください。
LLMの学習を理解するうえでは、事前学習と、その後の追加学習を分けて考えます。
たとえば、望ましい回答の口調や出力形式を示す入出力例を用意します。
AIサービスの市場については「AI SaaS市場動向」で解説しています。
ファインチューニングで応答を調整しても、学習後に変わった製品情報を自動で参照できるようにはなりません。更新される事実を回答に使う場合は、参照先の情報を別に管理する必要があります。
ファインチューニングの適用を検討する場面を、次の表に整理します。
| ユースケース | 具体例 | 効果 |
|---|---|---|
| 応答スタイルの統一 | カスタマーサポートBotの口調統一 | ブランドトーンの一貫性が向上 |
| 専門用語の正確な処理 | 医療・法務・金融領域の用語理解 | 専門文書の生成精度が向上 |
| 分類タスクの高精度化 | メール自動振り分け、チケット分類 | 分類精度の向上 |
| 構造化データ生成 | 自社フォーマットでのレポート出力 | 手動修正工数の大幅削減 |
候補となる業務では、まず望ましい出力例を用意できるか確認します。担当者の間で回答方針が揃っていない場合は、学習データを作る前に、その方針を決めておきます。
「最新の製品在庫情報を回答する」「現在の顧客データを参照する」といった、変化する情報が必要な場面では、情報を都度参照する方法を検討します。
問い合わせの一次回答について担当者ごとに方針が異なる場合も、先に回答方針を整理します。判断の分かれ目は次の通りです。
ファインチューニングとRAG(Retrieval-Augmented Generation:検索拡張生成)は、役割を分けて併用することもできます。
この節では、更新頻度、応答品質、コストと運用負荷の順に確認します。
RAG型の仕組みでは、どの情報を参照先にするかを決めます。以下は、Breezeアシスタントの入力ソースを選択する画面です。
次の画像は、Breezeアシスタントの入力ソース選択画面を示します。
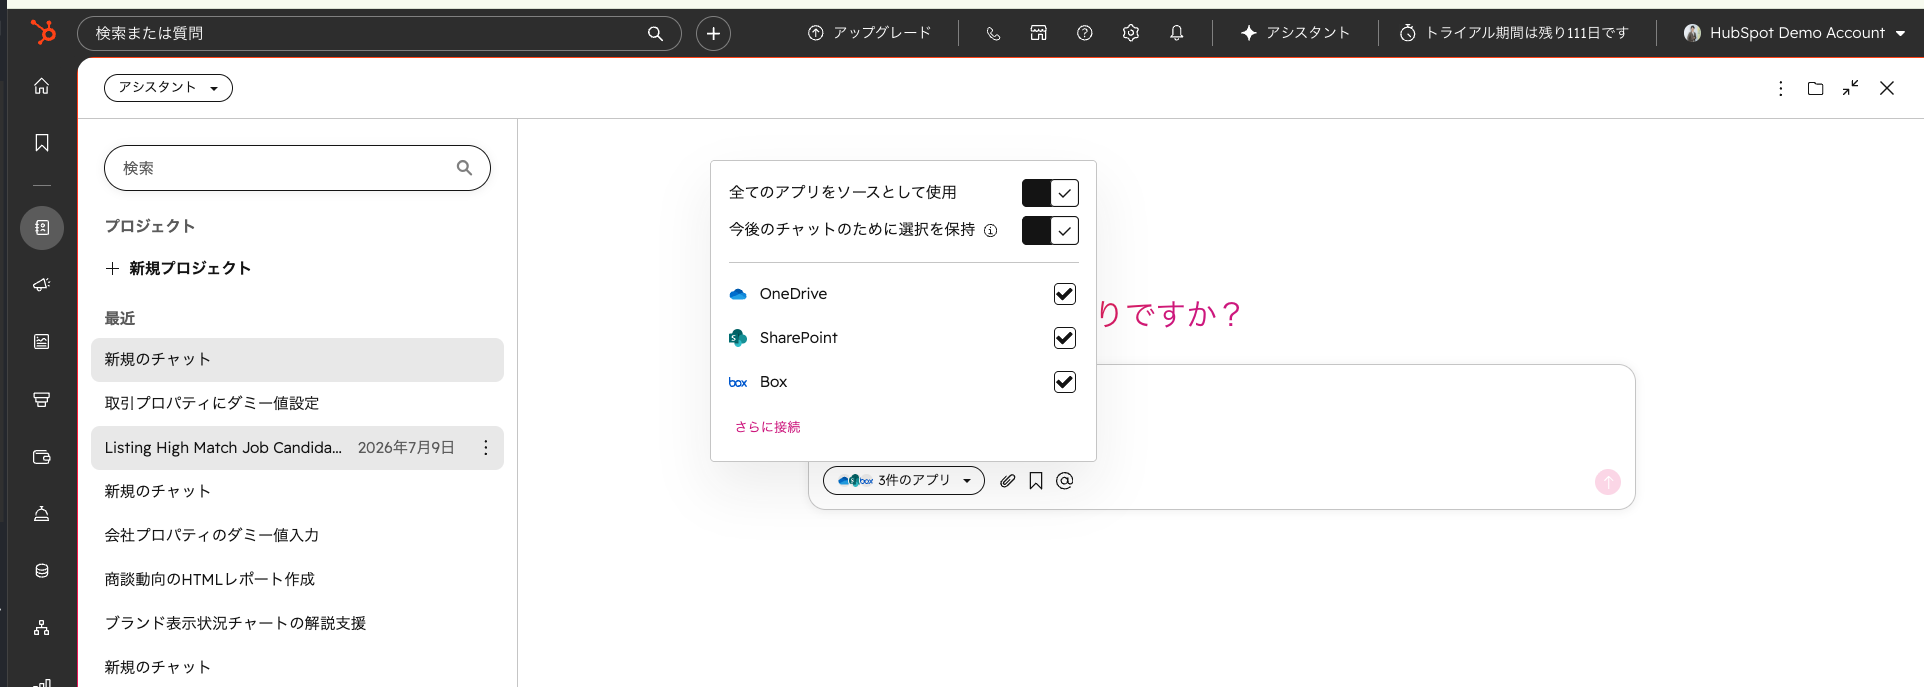
対象となる情報の改定履歴を確認し、更新のたびに学習データとモデルを見直せるかを考えます。回答時に新しい内容が必要なら、更新できる参照先を用意します。
RAGを使っても誤答がなくなるわけではないため、参照結果と出力の評価は必要です。
現在のAI出力で修正した箇所を集め、理由を「事実の誤り」と「言い回し・形式の崩れ」に分けます。
それでも形式が揃わない場合に、ファインチューニングを検討します。
| 比較項目 | ファインチューニング | RAG |
|---|---|---|
| 初期構築コスト | 高(GPU/API学習費) | 中(ベクトルDB構築) |
| 運用コスト | 低(推論のみ) | 中〜高(検索+推論) |
| データ更新の容易さ | 低(再学習が必要) | 高(DB更新のみ) |
| レイテンシ | 低(検索不要) | やや高(検索→生成の2段階) |
| ハルシネーション対策 | 弱い | 強い(ソース提示可能) |
費用や応答時間は、使うモデル、データ量、構成によって変わります。比較表を初期検討に使い、候補を絞った後は同じ入力と評価条件で確認してください。
RAGの具体的な構築方法については「RAG構築の実践ガイド|社内データを活用したAI検索システムの作り方」で詳しく解説しています。
検討時の確認事項を、次の表にまとめます。
| 確認すること | 結果 → 選ぶ方向 | 次に記録・設定すること |
|---|---|---|
| 正解が日々変わる情報を扱うか | 扱う → RAGを土台にする | 参照先の文書と更新担当者を一覧にする |
| 修正理由は事実の誤りか、形式の崩れか | 事実の誤りが中心 → RAGの参照先を整備する | 誤答の元になった文書を特定して直す |
| 同上 | 形式の崩れが中心 → プロンプト改善から試す | 理想の回答例をプロンプトに組み込む |
| プロンプト改善後も形式が揃わないか | 揃わない → ファインチューニングを検討する | 学習データにする入出力ペアの作成計画を立てる |
| 両方の課題が残るか | 残る → 併用する | 口調はファインチューニング、事実はRAGと役割を分けて記録する |
ファインチューニングには、学習データの作成と評価が必要です。次の順に進めます。
次の表は、各段階で確認することをまとめたものです。
| 段階 | やること → 次の段階へ進む条件 | うまくいかないときの戻り先 |
|---|---|---|
| 1. プロンプト設計 | やること:システムプロンプトと回答例(few-shot)で指示する/進む条件:口調や形式はおおむね揃うが、社内情報が足りず誤答が残る | 回答方針の定義づくり |
| 2. RAG | やること:社内文書やCRMのデータを参照させる/進む条件:事実は合うが、長い指示を書いても口調や出力形式が崩れる | 参照先の文書の整備 |
| 3. ファインチューニング | やること:入出力ペアを学習させる/進む条件:同じ評価セットで、前の段階より修正の手間が減る | 学習データの見直し、またはRAGへ |
段階ごとの結果を比べるため、同じ評価セットを使います。入力や採点基準を記録しておくと、変更前後を比較できます。
製品側で口調や応答スタイルを指定できる場合は、その設定で要件を満たせるか確認します。
設定内容を確認します。
次の画像をご覧ください。
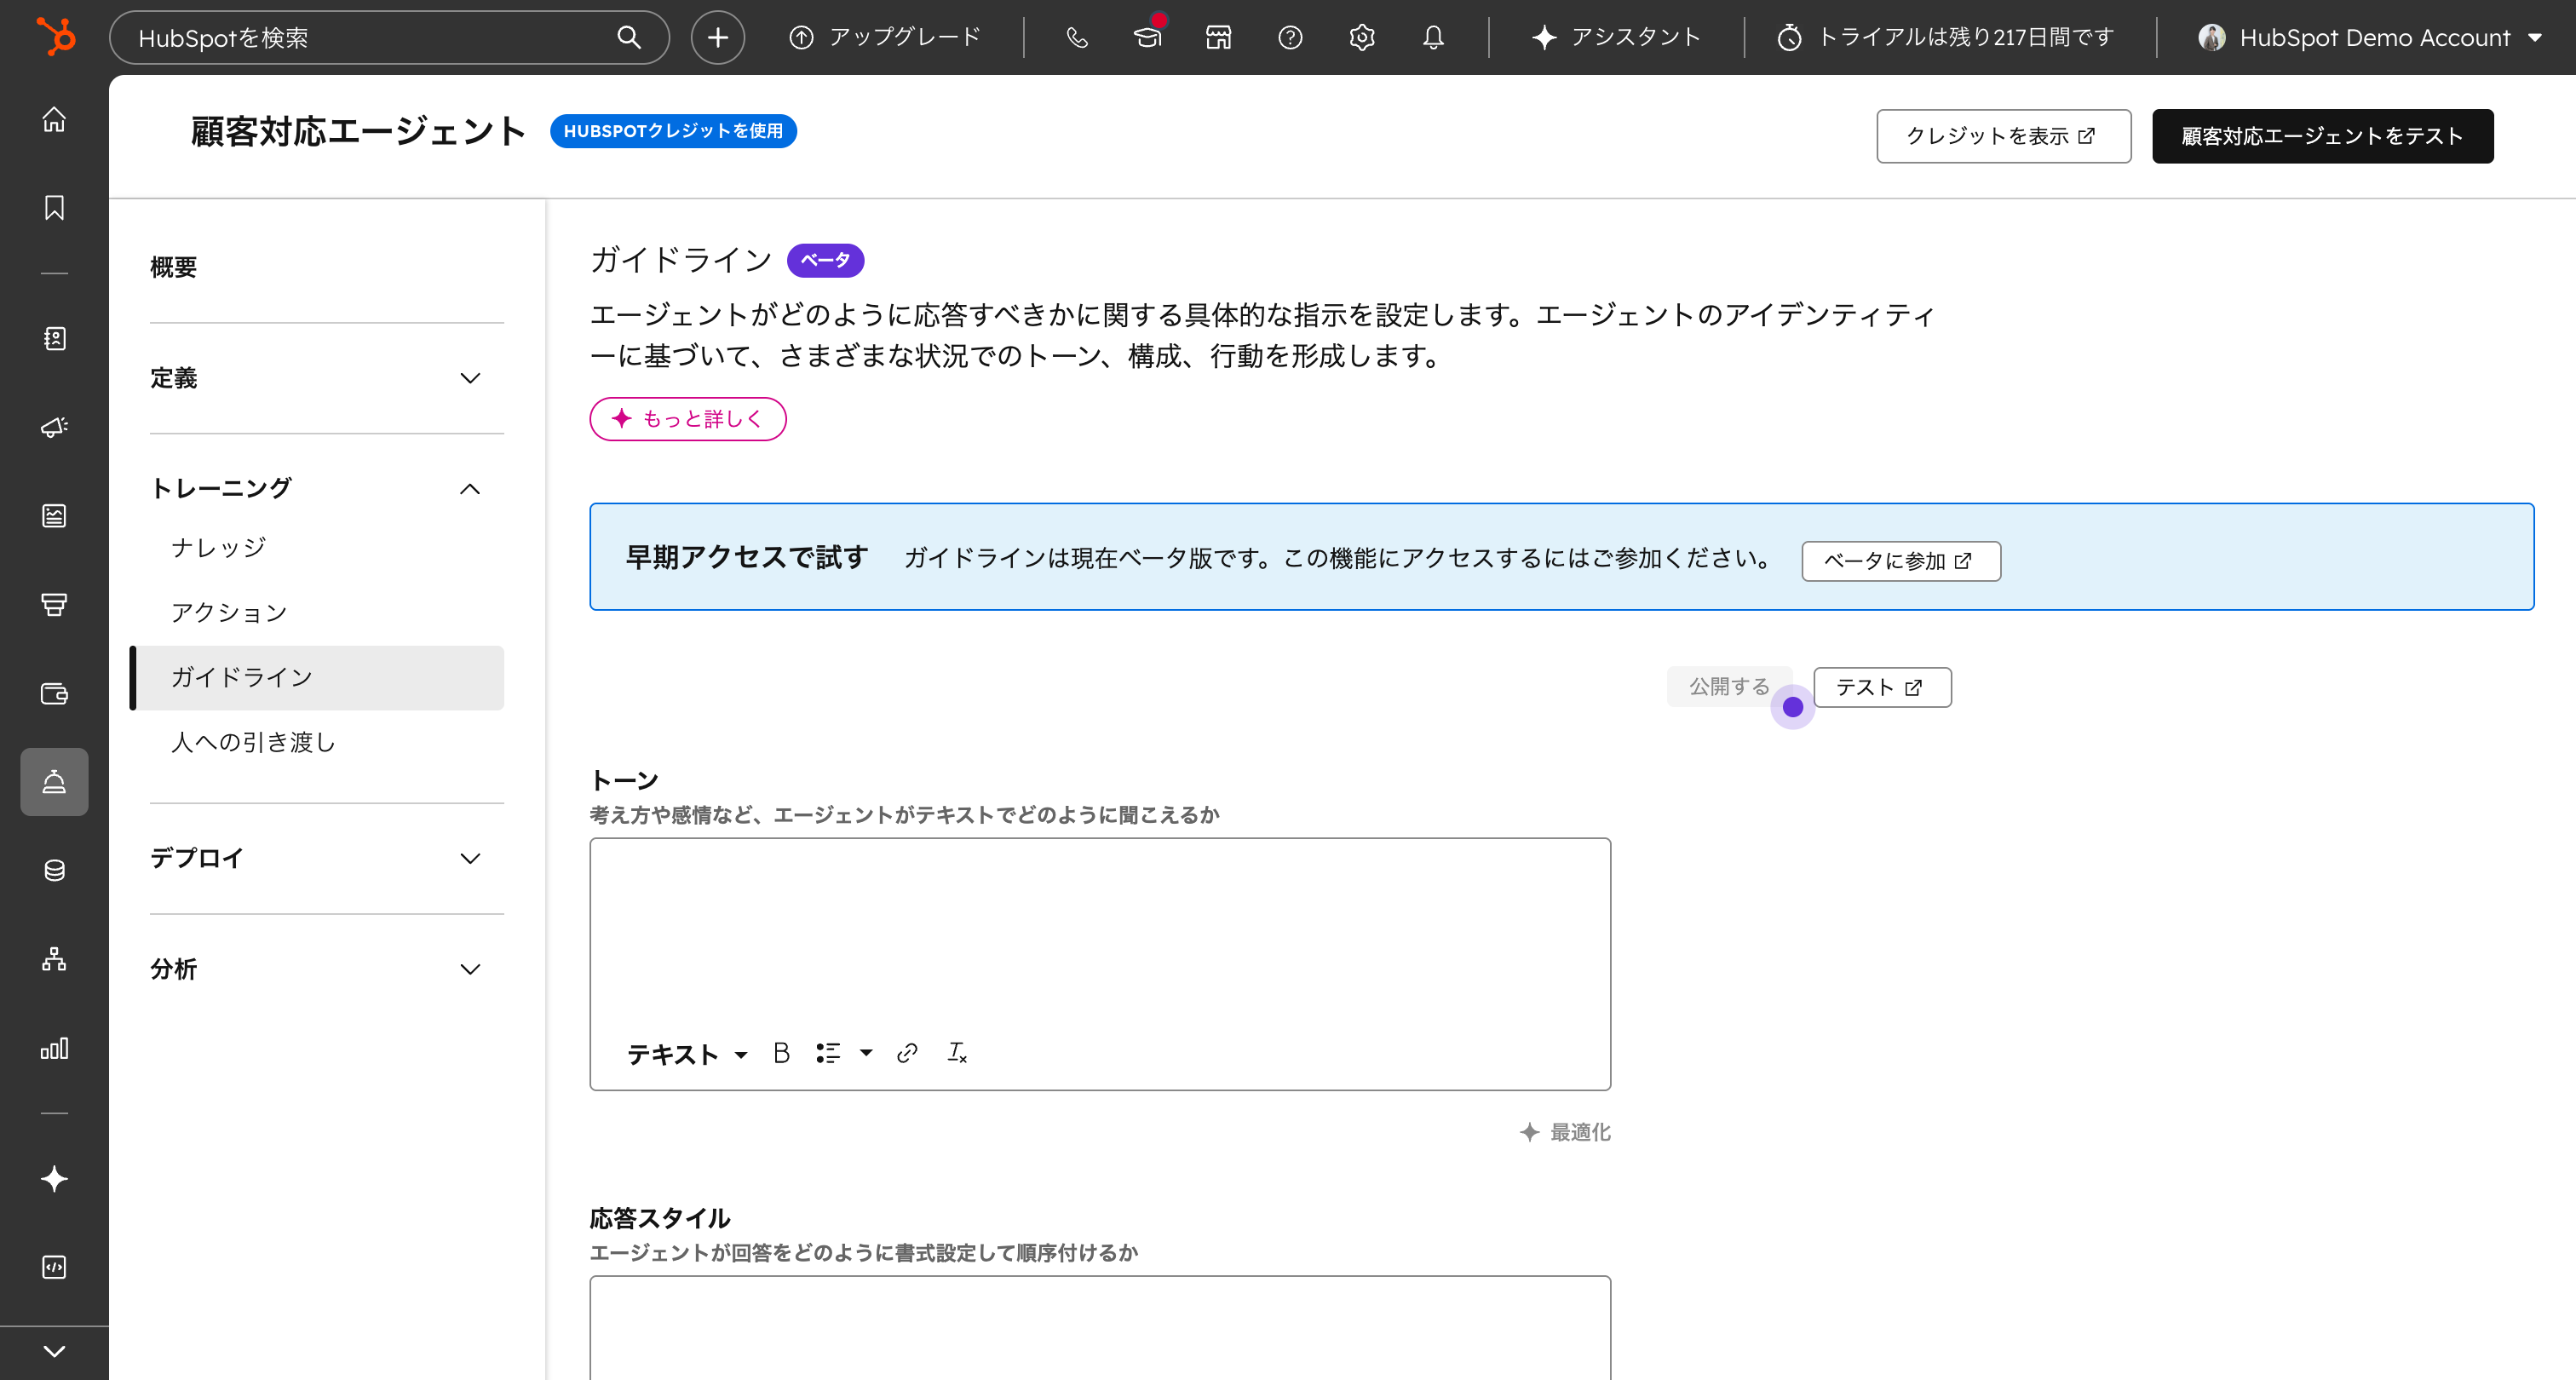
希望する敬語や言い回しをガイドラインに書き、実際の問い合わせに近い入力で出力を確認します。設定とプロンプトを調整しても必要な形式が揃わない場合は、ファインチューニングの検討材料になります。
段階を進めるかどうかは、評価結果を記録して決めます。
この記録は、後でファインチューニングを試す際の比較にも使えます。
ファインチューニングでは、学習に使う入出力例を用意し、その内容を確認する必要があります。応対履歴を使う場合は、記録の場所と、最終的に採用された回答を確かめます。
この節では、履歴を整理する手順と、CRMに記録する際の考え方を紹介します。
問い合わせ一覧、メール、社内チャットなどを学習データの候補にする場合は、それぞれの記録がどの問い合わせに対応するかを確認します。
履歴をそのまま学習に使う前に、回答内容と利用可否を人が確認します。
今後の記録を学習や評価に使うなら、入力する項目と確認手順を決めておきます。
入力項目を決める際は、学習や評価に必要な情報を明確にします。記録の方法に加え、誰が内容を確認するかも決めておきます。
ファインチューニング済みのモデルをどの業務で使うかを決めると、必要な学習例や評価対象を絞れます。
| フローの段階 | 主なHubSpotのデータ → ファインチューニングの使いどころ | 組み合わせる手段 |
|---|---|---|
| コンタクト | フォーム送信、問い合わせ内容 → 問い合わせの分類、一次回答の口調統一 | ワークフローで分類結果をプロパティに記録する |
| 取引 | 取引ステージ、商談メモ → 提案文や議事録要約を自社フォーマットで出力 | 内容は担当者が仕上げる |
| 顧客 | チケット、ナレッジベース → サポート回答の口調と構成の統一 | 最新の手順はRAGで参照する |
| 請求 | 契約・金額に関する情報 → 定型文面の形式を揃える補助に限定 | 金額や条件は元データと人の確認で確定する |
金額や契約条件を含む出力では、参照元のデータと人による確認を使って内容を確定します。
プラットフォームを選ぶ際は、対象モデルの対応状況、料金、データの取り扱い、既存環境との接続方法を確認します。対応状況や料金は変わるため、利用前に各社の公式情報を確認してください。
OpenAIのファインチューニングでは、学習データをJSONL形式で準備します。学習例の要件は、利用するモデルの公式ガイドで確認してください(出典:OpenAI Fine-tuning ガイド)。
Google CloudのVertex AIで利用できるチューニング方法と対象モデルは、公式ドキュメントで確認できます(出典:Vertex AI AIモデルのチューニング)。
Amazon Bedrockを候補にする場合は、利用したいモデルで必要なカスタマイズ方法が提供されているか確認します。
候補を比較するときは、既存環境に加え、対象モデルの対応状況とデータの取り扱いを確認します。
| 自社の状況 | 候補 | 次に決めること |
|---|---|---|
| AWSを主力にしている | Amazon Bedrock | 学習データを置く場所とアクセス権限 |
| Google Cloudを使っている | Google Vertex AI | BigQueryなど既存データとの連携方法 |
| クラウドにこだわりがない | OpenAIのAPI | API利用時のデータの取り扱い方針の社内承認 |
プラットフォームを決める前に、どの出力を改善したいかと、その改善をどう評価するかも決めておきます。
ファインチューニングを試す際の作業を、目的の明確化から運用までの5ステップに分けます。次の表は、各段階で確認する条件をまとめたものです。
| ステップ | 主な作業 | 次へ進む条件 |
|---|---|---|
| 1. 目的の明確化とデータ設計 | 改善対象と評価方法を決める | 改善前の状態を数値で記録できている |
| 2. データの収集と前処理 | 入出力ペアを作り、クレンジングする | 人のレビューを通過したデータがそろっている |
| 3. 学習の実行 | 学習ジョブを作成し、検証データで監視する | 検証データでの損失が悪化していない |
| 4. 評価とテスト | ベースラインと同じ評価セットで比較する | 修正の手間がベースラインより減っている |
| 5. 本番デプロイと継続的改善 | 一部の業務から切り替え、監視する | 監視指標が切り替え前より悪化していない |
最初に、改善したい出力と評価方法を決めます。
次に、候補となるデータを集めて整えます。
レビューで回答方針の不一致が見つかった場合は、学習を進める前に方針を整理します。
データが準備できたら、利用するプラットフォームの手順に沿って学習を実行します。
設定値と学習結果を記録し、次に試す設定との比較に使います。経営データの活用に関心のある方は、Claude Codeを使った経営データの可視化もご覧ください。
学習後は、導入前に決めた基準で出力を確認します。
期待した改善が見られない場合は、失敗した入力と学習例を照らし合わせます。例を追加する場合も、採用前に内容をレビューします。
評価結果を確認したうえで、適用する業務と範囲を決めます。
評価セット、学習時の設定、再学習の判断条件を記録しておくと、変更後の結果を比較できます。
導入費用を見積もる際は、学習費に加えて、データの準備、出力の評価、運用に必要な作業も含めます。
費用と工数を、次の項目に分けて見積もります。
| 費目 | 中身 | 大きくなりやすい条件 |
|---|---|---|
| データ作成 | 模範回答の作成、レビュー、クレンジング | 履歴が複数のツールに散らばっている |
| 学習 | APIやコンピュートリソースの利用料 | 再学習の回数が多い |
| 推論 | 本番での利用料 | 利用件数が多い、出力が長い |
| 評価・運用 | 評価セットの採点、監視、再学習の判断 | 評価の手順が決まっていない |
自社の履歴を学習に使う場合は、必要な記録を集めてレビューする時間も試算に含めます。
推論料金は、利用するモデルやプランの料金表で確認します。見積もりには、参照した単価と日付、想定利用量を記録してください。実際の利用量が変わったときに試算を更新できます。
効果を試算する際は、削減した作業時間と、導入・運用にかかった費用を同じ期間で比較します。
年間の純削減額の計算式:
年間の削減時間 × 人件費単価 − 年間のAI関連費用 = 年間の純削減額
削減時間を測るために、導入前後で同じ業務の対応時間と件数を記録します。記録がない場合は、まず計測方法を決めてから試算します。
ファインチューニング後も、出力の評価と、人による最終判断が必要な業務があります。どの作業にモデルを使い、何を人が確認するかを事前に決めます。
学習データへの適合が進んでも、学習に使っていない入力で同じように応答できるとは限りません。検証用データと業務に近い評価セットを使い、結果を確認します。
評価結果が悪化した場合は、学習設定とデータの両方を確認します。設定を変えた結果と、学習例を見直した結果を分けて記録してください。
学習データの内容に偏りがある場合は、対象としていない質問への出力も確認します。
学習例を製品、問い合わせカテゴリ、顧客の種類など、対象業務に合う区分で整理します。例が不足する区分については、追加するか、その区分をモデルの適用範囲から外すかを決めます。
学習に使う候補データに個人情報や機密情報が含まれる場合は、利用前に取り扱いを確認します。
適用範囲を決める際は、下書きや分類と、最終的な判断を分けます。
| AIに任せること | 人が判断すること |
|---|---|
| 問い合わせの分類 | 分類カテゴリと回答方針の定義 |
| 自社フォーマットでの下書き作成 | 最終的な送信・公開の判断 |
| 定型的な一次回答の口調統一 | 金額・契約条件など事実の確定 |
| 議事録やレコードの要約 | 大型案件への提案内容 |
| 学習データ候補の抽出と整形 | 模範回答として採用するかの判断 |
顧客に直接届く出力は、適用範囲と確認手順を決めてから利用します。AIの基本概念については「AIとは?ビジネス活用の全体像をわかりやすく解説」もあわせてご参照ください。
必要な学習例の条件は、利用するモデルと方法の公式案内で確認してください(出典:OpenAI Fine-tuning ガイド)。件数だけで業務に使えるかは判断できません。用意した例の内容を確認し、別に設けた評価セットで結果を比べます。
はい。応答の口調や形式の調整と、更新される情報の参照を分けて設計できます。併用する場合は、誤答が出たときに学習例と参照先のどちらを確認するか、あらかじめ記録しておきます。
まず評価結果を確認し、どの入力で期待した出力にならなかったかを特定します。学習例の内容、回答方針、評価基準を見直してください。口調や形式が課題であれば、プロンプトの調整でも対応できるか比較します。
自社で学習用のインフラを用意する方法に加え、APIを利用する方法もあります。判断にあたっては、学習例の準備とレビュー、利用料金、運用時の評価に必要な工数を見積もります。まずプロンプトやRAGで要件を試し、残る課題を確認してから検討できます。
まずは対象業務を選び、現在の出力をどのような理由で修正しているか記録してください。
このテーマの全記事はAIテックトレンドガイドでご覧いただけます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。
このテーマと関連する内容を、次の記事でも詳しく解説しています。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。