この記事の結論
AIとは、大量のデータから学習したパターンをもとに、テキスト・画像・コードなどの新しいコンテンツを生成するAI技術です。業務の棚卸しで効果の大きい領域を1つに絞り、CRMに整ったデータを用意してから小さく試すことが、成果につなげやすい進め方です。
AIとは、大量のデータから学習したパターンをもとに、テキスト・画像・コードなどの新しいコンテンツを生成するAI技術です。業務の棚卸しで効果の大きい領域を1つに絞り、CRMに整ったデータを用意してから小さく試すことが、成果につなげやすい進め方です。
AIとは、大量のデータから学習したパターンをもとに、テキスト・画像・コードなどの新しいコンテンツを生成するAI技術です。業務の棚卸しで効果の大きい領域を1つに絞り、CRMに整ったデータを用意してから小さく試すことが、成果につなげやすい進め方です。
「AIを業務に取り入れたいが、何から始めればよいかわからない」「ChatGPTを試している社員はいるが、部署ごとに使い方がばらばらになっている」「顧客情報がExcelや個人のメールに散らばっていて、AIに何を渡せばよいのか決められない」——こうした悩みは、BtoB企業の経営者・部門責任者の方に広く見られます。ChatGPTの急速な普及をきっかけに、AIはビジネスで無視できないテーマになりましたが、技術の進化が速く、全体像を把握しきれないという課題は少なくありません。社内のデータをAIに参照させる仕組みについては、「RAGとは?社内データ活用でAIの精度を高める仕組みと導入方法」もあわせてご覧ください。
本記事では、AIの基本的な仕組みから主要サービスの特徴、企業が取り組む具体的な活用領域までを体系的に整理します。軸になるのは、StartLinkが大切にしている「自社の条件で選び、小さく始めて広げる」という考え方です。AI活用の全体像は「AI活用完全ガイド」でも把握できます。
AIの導入を検討している経営者・部門責任者が、仕組みの理解から最初の一歩の決め方までを一続きで把握できるよう、次の6点を整理しました。まとめの6項目は、この順番に対応しています。
この記事を読み終えるころには、自社が最初に取り組む領域と、小さく試すPoCの進め方が決められます。まずは自社の業務を一覧にするところから始めてください。
AIを業務に活かすには、まず「何ができて、何が苦手な技術なのか」を押さえておくと判断がぶれにくくなります。この章では、AIの定義と従来AIとの違い、そして中核にある技術を順に整理します。最後に、自社の業務のどこに効くかを見極める考え方をまとめます。
AI(Generative AI)とは、大量のデータから学習したパターンをもとに、テキスト・画像・音声・動画などの新しいコンテンツを生成する人工知能の総称です。自律的に作業を進めるAIエージェントとの違いは、「AIエージェントとは?従来AIとの違い・仕組み・企業活用の最前線」で整理しています。
ビジネスの文脈では、「文章を書く」「要約する」「分類する」「下書きを作る」といった、これまで人が時間をかけていた作業を肩代わりできる点が注目されています。一方で、生成される内容は学習したパターンにもとづく「もっともらしい出力」であり、事実関係の正しさまでを保証するものではありません。この性質を理解しておくことが、後で述べる役割分担の出発点になります。
従来のAI(判別型AI)が「この画像は猫か犬か」といった分類タスクに特化していたのに対し、AIは「猫の画像を新たに描く」「営業メールの文面を作成する」といった創造的なアウトプットが可能です。両者の違いを整理すると次のとおりです。
| 比較項目 | 従来AI(判別型) | AI | 判定 |
|---|---|---|---|
| 主な用途 | 分類・予測・異常検知 | テキスト・画像・コード生成 | 正解のある判定ならば判別型、文章などを作りたいならAIを検討する |
| 代表技術 | SVM、ランダムフォレスト | Transformer、拡散モデル | 技術名は理解の補助として押さえ、選定は用途で決める |
| 入出力 | データ→ラベル・数値 | プロンプト→コンテンツ | 出力がラベルや数値なら判別型、文章や画像ならAIが向く |
| 学習データ量 | 用途ごとに用意した比較的限られたデータ | 非常に大規模なデータ | 学習の規模は提供元側の性質の違いであり、自社が用意する量とは別に考える |
| ビジネスインパクト | 特定業務の効率化に向く | 文書を扱う幅広い業務に応用しやすい | 課題が特定業務に限られるか、業務をまたぐかで選ぶ |
この表は、どちらが優れているかを決めるためではなく、使い分けを考えるために読むのがおすすめです。例えば次のように分けられます。
自社の業務を「判定したいのか、作りたいのか」で分けると、どちらの技術を検討すべきかが見えてきます。
AIの中核技術は、Googleの研究者が発表したTransformerアーキテクチャです。このモデルが「注意機構(Attention)」によって文中の単語同士の関係を捉え、文脈を理解しやすくなったことが、大規模言語モデル(LLM:大量の文章で学習し、自然な文章を生成・理解するモデル)の急速な発展につながりました。
ChatGPTやClaude、Geminiといった対話型サービスは、いずれもこのLLMを土台にしています。業務で使う側としては、技術の細部よりも「一度に読ませられる情報の量」「指示の出し方で出力が変わる」という2点を押さえておくと実務に役立ちます。
前者はモデルごとに仕様として公開されており、例えばAnthropicは、Claudeの各モデルのコンテキストウィンドウ(一度に扱える入力の長さ)や出力できる長さの上限などの仕様を公式ドキュメントで公開しています(出典:Models overview)。
企業によって適した活用方法は異なりますが、まず自社の業務プロセスのどこにAIが効くかを見極めることが出発点になります。本記事では、次の3つの問いで候補業務をふるいにかける方法をおすすめします。
3つすべてに当てはまる業務が、最初のPoC(小規模な試験導入)の候補になります。流行のサービスや話題の機能からではなく、自社の業務の条件から選び、小さく試すための入り口がこの3つの問いです。
AIサービスは多数ありますが、選定のポイントは「自社の業務環境との統合性」です。性能の比較だけで選ぶと、社員が日常的に使うツールから切り離されて使われなくなることがあります。この章では主要サービスの特徴と、IT基盤から候補を絞る考え方を整理します。
ビジネスで利用される主要なAIは以下のとおりです。なお、下表は本記事の執筆時点の整理であり、モデル名や法人プランの名称は改定されることがあります。
導入を決める前に、各社の公式ページで次の点を確認してください。
確認した結果、自社の利用人数と用途に対してプランの条件が合わない場合は、その候補を外して次の候補を比較します。
| サービス | 提供元 | 強み | 法人プラン |
|---|---|---|---|
| ChatGPT | OpenAI | 汎用性・プラグイン連携 | ChatGPT Enterprise |
| Claude | Anthropic | 長文理解・安全性・コード生成 | 法人向けプランあり(現行の名称と条件は公式ページで確認) |
| Gemini | マルチモーダル・Google Workspace統合 | 法人向けプランあり(現行の名称と条件は公式ページで確認) | |
| Copilot | Microsoft | Microsoft 365連携 | Copilot for Microsoft 365 |
| Amazon Q | AWS | AWSサービス統合・セキュリティ | Amazon Q Business |
Microsoft 365中心の企業であればCopilot、Google Workspace主体ならGemini、高度なコード生成やドキュメント分析が必要ならClaudeと、既存のIT基盤に合わせた選択が重要です。社員が毎日開いているメール・文書・表計算の画面の中でAIを呼び出せるかどうかが、定着を左右するポイントになってきます。
候補を絞る際は、次の順で判断するのがおすすめです。
| 確認すること | 結果 | 次の判断 |
|---|---|---|
| 社内の文書・メールの基盤はどこか | Microsoft 365中心 | Copilotを第一候補にする |
| 同上 | Google Workspace中心 | Geminiを第一候補にする |
| 長い資料の読み込みやコード生成が主目的か | はい | Claudeを比較対象に加える |
| AWS上に業務システムがあるか | はい | Amazon Qを比較対象に加える |
| 顧客データをAIに渡す予定があるか | はい | 法人プランのデータの扱いを比較表の列に加える |
AIの進化は速く、短い周期で各社の優位性は変動します。特定のサービスに依存しすぎず、複数サービスを並行評価する体制を整えておくのが現実的です。
具体的には、PoCの段階で同じ業務・同じ入力データを2つのサービスに渡し、出力の修正にかかった手間を記録して比べる方法をおすすめします。比べる観点を次の3つに固定しておくと、担当者の好みではなく記録にもとづいて選べます。
選ばなかったサービスも評価の記録を残しておけば、次にモデルが更新されたときに同じ手順で比べ直せます。
サービスは自社のIT基盤と確認体制に合わせて選び、最初は小さな範囲で比べてから広げていくのが、無理のない進め方です。
企業におけるAI活用は、大きく4つの領域に分類できます。重要なのは、いきなり全社展開を目指すのではなく、効果を見込みやすい1領域からスモールスタートで始めることです。この章では各領域の活用例と、どこから始めるかの判断材料を整理します。
自社の条件に合う最初の1領域を選べるよう、本記事では4つの領域を「データの準備のしやすさ」と「出力を確認する人の置きやすさ」で比べます。
| 領域 | 主な入力 | 出力を確認する人 | 始めやすいケース |
|---|---|---|---|
| コンテンツ制作 | 既存資料・過去の記事 | マーケティング・営業担当 | 下書きを書く人と確認する人が分かれている |
| データ分析・意思決定支援 | CRMの商談・顧客データ | 営業マネージャー・経営層 | 顧客データが一か所にまとまっている |
| カスタマーサポート | FAQ・ナレッジ記事 | サポート担当 | 回答の元になるナレッジが整理済み |
| ソフトウェア開発 | 既存のコード・仕様 | エンジニア | コードレビューの手順がすでにある |
「主な入力」がすでに整っている領域を最初に選ぶと、データ整備に時間を取られずに効果を測れます。どの領域も入力が整っていない場合は、AIの検討と並行して、データの置き場所を一か所にまとめる作業から始めることをおすすめします。
マーケティングコンテンツ、営業資料、社内ドキュメントの作成をAIが支援します。ゼロから書く時間を減らし、人は構成の判断や事実確認、自社らしい表現への調整に時間を使えるようになります。
具体的な活用例:
これらのうち、元になる資料が社内にすでにそろっているものを1つ選び、確認する担当者を決めて小さく始めると、効果を測りやすくなります。
ただし、生成された文章は製品名・数値・事例を誤って書くことがあります。社外に出す文章は、固有名詞と数値を元資料と突き合わせる担当者を決めてから運用を始めてください。
例えば週1回配信するメルマガの下書きであれば、公開前に担当者が製品名・価格・日付・事例の社名を元資料と1件ずつ照合し、1つでも一致しなかった場合は配信を止めて修正する、という運用が考えられます。
社内に蓄積されたデータをAIで分析し、経営判断の材料を抽出します。CRMに蓄積された商談データや顧客行動データをAIに渡すことで、Excelの手作業では得られなかった洞察を引き出しやすくなります。
これらは、入力データがCRMなどにまとまっているものから試します。入力が散らばっている場合は、先にデータの置き場所を決めてから始めます。
この領域の成果は、渡すデータの質で大きく変わります。スプレッドシートが部署ごとに分かれ、同じ顧客の情報が複数のファイルで食い違っている状態では、AIはその食い違いをそのまま要約してしまいます。分析を始める前に「どのデータを正とするか」を決めておくことが重要なポイントです。
AIチャットボットや自動応答システムにより、問い合わせ対応を効率化します。AIに任せきりにするのではなく、エスカレーション(人の担当者への引き継ぎ)のルールを明確に設計することが重要です。
AIチャットボットの回答品質は、参照させるナレッジの品質に左右されます。ナレッジ記事が古いまま、あるいは担当者の頭の中にしかない状態では、AIは正しく答えにくくなります。次の画面は、HubSpotのBreezeカスタマーエージェントでガイドライン(トーンや応答スタイル)を設定する画面です。
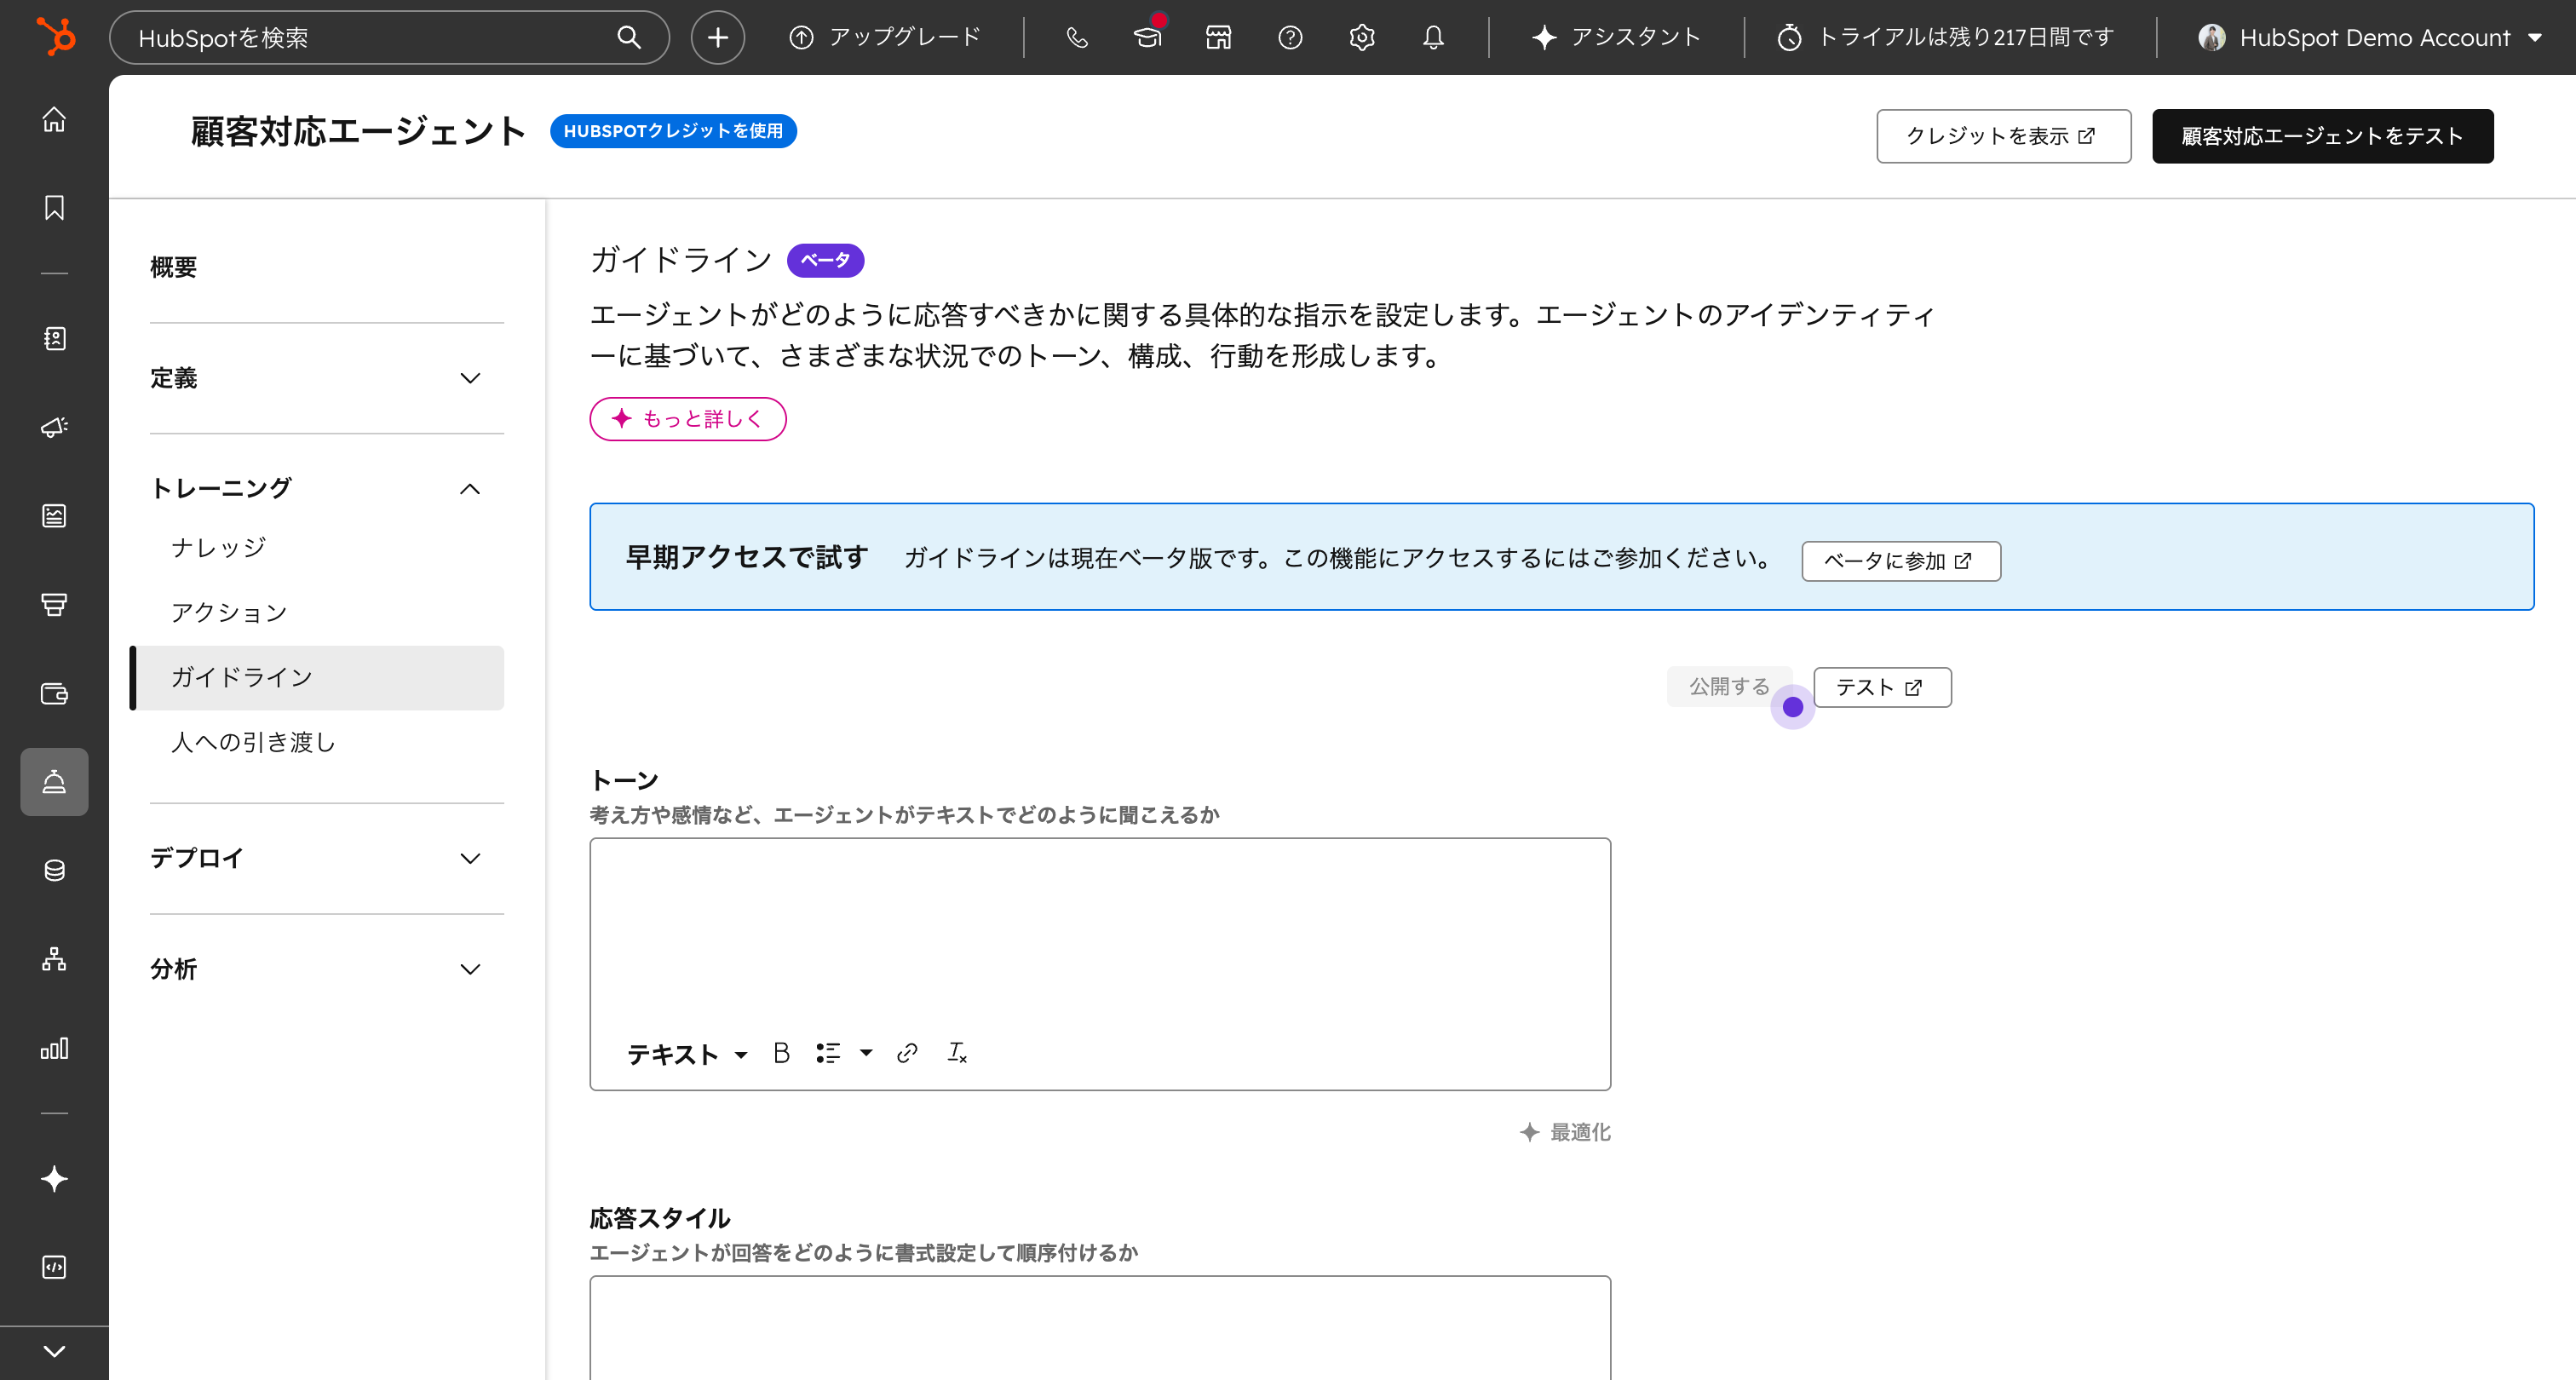
このように、回答のトーンや応答スタイルは設定として定めておけます。日本語のビジネス文書としての丁寧さや言い回しのルールは、ここで明示しておくと出力が安定しやすくなります。エスカレーションの条件は「返金・契約変更・クレームなど判断を伴う問い合わせは人へ引き継ぐ」のように、内容の種類で決めるのがおすすめです。
GitHub Copilotに代表されるAIコーディング支援ツールは、コードの補完やテストコードの下書き、既存コードの説明などを通じて開発作業を支援します。
この領域では、すでにあるコードレビューの手順にAIの出力を乗せられるかが判断の分かれ目です。レビューの仕組みがあるチームでは、AIが書いたコードも同じ手順で確認できるため導入しやすくなります。レビューの手順がまだ無いチームは、先にレビューのルールを決めてからAI支援ツールを広げる順番をおすすめします。
4領域のどれから始めるかは、流行ではなく、自社の入力データと確認体制の整い方で決めます。1領域で手応えを得てから、同じ手順で次の領域へ広げていきます。
AIの活用で成果が分かれるのは、ツールの性能よりも「どこまでをAIに任せ、どこからを人が判断するか」の線引きです。線引きが曖昧なまま使い始めると、AIの出力がそのまま社外に出てしまったり、逆に誰も使わなくなったりします。この章では役割分担の考え方と、それを個人の注意力ではなく仕組みで回す方法を整理します。
本記事では、AIと人の役割を次のように整理します。AIは「材料を集めて下書きを作る」作業を、人は「ビジネスを理解したうえで決める」作業を担うという分け方です。
| AIが得意 | 人間が判断 |
|---|---|
| 問い合わせの分類(営業/通常) | パイプラインの設計(ビジネス理解が必要) |
| レコードの要約 | ライフサイクルステージの定義 |
| 企業情報のウェブリサーチ | 最終的なメール送信判断 |
| パーソナライズメールの下書き | 営業戦略の意思決定 |
| データクレンジング/分類 | 大型案件のアプローチ |
| 議事録の自動生成 | プロンプトの設計・チューニング |
| 案件評価のA/B/Cランク付け | ビジネスルールの定義 |
左列の作業は、出力が多少ずれても人が確認して直せば済む作業です。右列の作業は、判断を誤ると売上や顧客との関係に直接影響する作業です。新しい業務にAIを使うか迷ったときは、「間違えたときに人が気づいて直せるか」を基準に、どちらの列に入るかを考えるのがおすすめです。
AIの出力は、営業アシスタントがリサーチをして方向性をまとめ、提案段階で持ってきてくれる資料に近いものと考えています。そのまま使える完成品ではなく、人が手を入れる前提の叩き台です。
特に、受注見込みが大きい案件や重要な取引先へのアプローチは、AIの下書きに頼りきらず、リサーチ結果は参考にしつつ文面は担当者が自分で書くことをおすすめします。一方、初めてワークフローやメール文面を作る場面では、AIに初期版を作らせてから手で改善すると取っ掛かりがつかみやすくなります。
「AIの出力は確認してから使ってね」と口頭で伝えるだけでは、忙しい時期に確認が抜けます。確認を個人の注意力に頼らず、業務の流れに組み込むことをおすすめします。
例えば、AIが作ったメールの下書きは自動送信にせず、担当者へのタスクとして割り当て、確認して送信する流れをワークフローで組んでおく方法があります。新規リード向けのフォローメールであれば、次のような運用が考えられます。
こうしておけば、担当者が入れ替わっても、新しく入った社員でも同じ手順で回せます。自律的にメールを送信する設定は、送信内容の誤りがそのまま顧客に届くため、現時点では使わない運用をおすすめします。
役割分担は一度に完成させず、確認の手順が回ることを見ながら、AIに任せる範囲を少しずつ広げていきます。
AIの効果は、AIに渡すデータが整っているかどうかで大きく変わります。顧客情報や商談の状況がスプレッドシートやチャットに分散している状態では、AIに何を渡せばよいかを決めるところで止まってしまいます。この章では、データ基盤とAI活用の関係を整理します。
スプレッドシートで顧客や商談を管理していると、更新は手作業になり、同じ顧客の情報がファイルごとに食い違うことが起こりがちです。営業はスプレッドシートを更新してチャットで報告し、マーケティングは別のリストを持ち、サポートはまた別の表で問い合わせを管理する、といった状態です。
この状態でAIに「この顧客の状況を要約して」と頼んでも、AIが参照できるのは渡されたファイルの範囲だけです。どのファイルが最新かを人が判断して集める作業が毎回発生し、AIで浮いた時間がデータ集めに消えてしまいます。
CRMは単なる顧客リストの置き場ではなく、営業プロセスの標準化と経営判断の基盤になる仕組みと考えています。その価値は、次の3つに整理できます。
| 柱 | 内容 | AIとの関係 |
|---|---|---|
| 一元管理 | コンタクト・会社・取引・チケットが関連付けられて1か所にまとまる | AIに渡すデータの範囲が明確になる |
| 自動化 | ワークフローでステージ変更や通知の漏れを防ぐ | AIの処理を業務の流れの中に組み込める |
| 可視化 | ダッシュボード・レポートで指標をリアルタイムに把握する | AIが更新した結果を集計に反映できる |
すべての情報がCRMに入っていれば、過去のやり取りを一覧で確認でき、AIにも同じ情報を参照させられます。
AIを個別の便利ツールとして使うのではなく、「コンタクト獲得→取引→顧客化→請求」という一連の流れのどこに置くかを決めると、効果を測りやすくなります。例えば、フォームからの問い合わせをAIで「営業目的」と「通常の問い合わせ」に分類してライフサイクルステージを更新する、商談の議事録をAIで要約して取引に記録する、といった置き方があります。
HubSpotでは、AI機能のBreezeを使ってCRMのレコードを会話形式で更新できます。次の画面は、Breezeが関連する取引4件を一括で「お見送り」に更新した結果の例です。
画面の表示や操作名は製品の更新で変わることがあるため、実際に使う際は公式ドキュメントで現行の画面と操作手順を確認し、自社の環境で同じ更新ができるかを小さな件数で試してから広げてください。
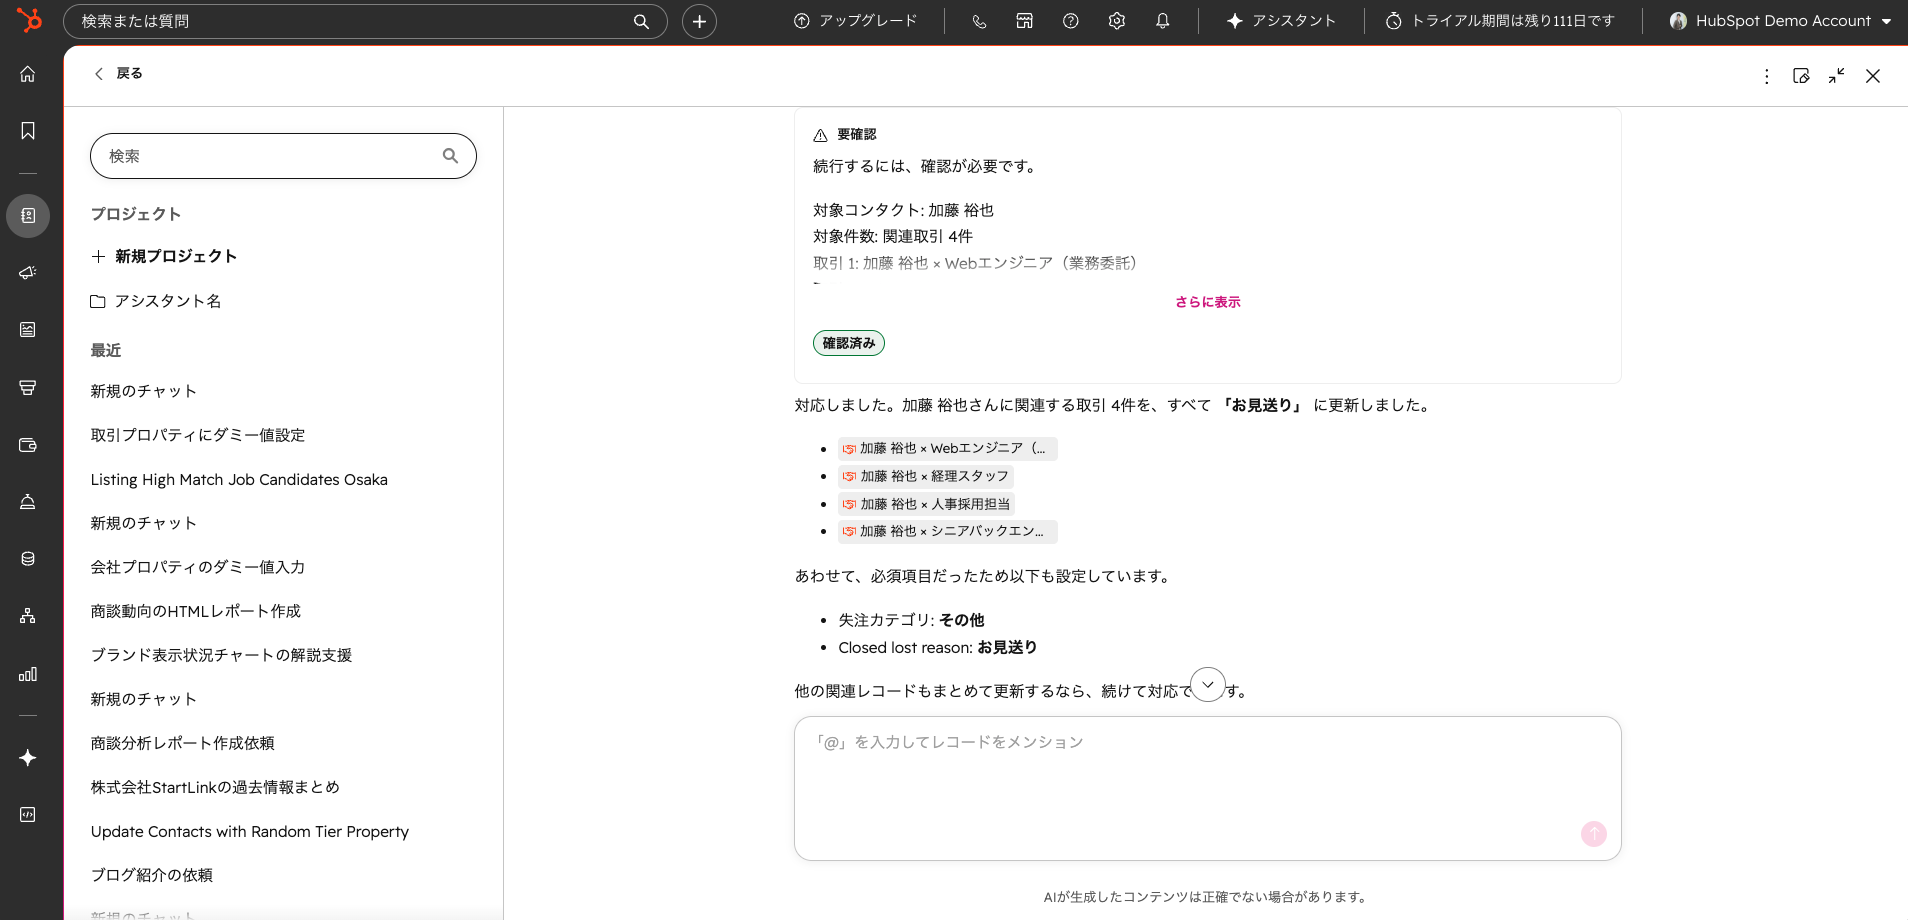
更新結果はCRMのデータとしてそのまま集計・レポートに反映されます。AIの処理結果がスプレッドシートに書き出されて終わるのではなく、レポートまでつながることが、一気通貫で設計する意味です。なお、関連付けを持つデータベース型のCRMであれば、HubSpot以外でも同様の考え方で設計できます。
AIに読ませるデータは、多ければよいわけではありません。使われていない項目が大量にあり、実際に入力されているのは一部だけ、という状態のCRMでは、AIも空欄や古い値に引っ張られます。
本記事では、AI活用を見据えたデータ設計として次の手順をおすすめします。
項目が少ないほうが入力する側も集中でき、AIに渡すデータの品質も保ちやすくなります。
データ基盤は完璧に整えてから始める必要はありません。最初に使う業務に必要な項目だけを整え、AIの活用範囲に合わせて少しずつ広げていきます。
AIを組織に導入する際は、一足飛びに全社展開を目指すのではなく、小さく始めて成果を確認しながら拡大する「スモールスタート」の姿勢が、導入を成功させやすくします。この章では5つのステップと、各段階で次に進むための条件を整理します。あわせて、情報の取り扱いルールの考え方にも触れます。
AIの導入は、以下のステップで進めることをおすすめします。
| ステップ | 内容 | 期間目安 |
|---|---|---|
| 1. ユースケース特定 | 業務棚卸し → AI化の効果が大きい領域を選定 | 2〜4週間 |
| 2. PoC実施 | 小規模チームで試験運用 → 効果測定 | 4〜8週間 |
| 3. ガイドライン策定 | セキュリティポリシー・利用規則の整備 | 2〜4週間 |
| 4. 全社展開 | トレーニング実施 → 段階的にスケール | 3〜6ヶ月 |
| 5. 効果測定・改善 | KPI設定 → 定期的な振り返りと最適化 | 継続 |
期間はあくまで目安で、対象業務の範囲や社内の体制によって前後します。重要なのは期間を守ることよりも、各ステップの終わりに「次へ進んでよい状態か」を判断することです。例えばPoCの期間が過ぎても、事前に決めたKPIで導入前との比較ができていない場合は、全社展開には進まず、対象業務の範囲を絞って再測定します。
本記事では、各ステップの終わりに次の状態ができているかを判断材料にすることをおすすめします。
| ステップ | 次へ進む条件 | 条件を満たさないときの戻り先 |
|---|---|---|
| ユースケース特定 | 対象業務・担当者・入力データの置き場所が1つずつ決まっている | 業務の棚卸しをやり直す |
| PoC実施 | 事前に決めたKPIで、導入前との比較ができている | KPIの定義を見直して再測定する |
| ガイドライン策定 | 入力してよい情報・いけない情報が一覧になっている | PoCで出た疑問点を洗い出す |
| 全社展開 | 部署ごとの利用状況を把握できている | 利用が少ない部署の業務に合わせて使い方を再設計する |
| 効果測定・改善 | 振り返りの頻度と担当者が決まっている | 担当者を決めて測定項目を絞る |
PoCの段階で「何をもって成功とするか」のKPIを事前に定義しておかないと、「やってみたけど効果がよくわからない」という結果に陥りがちです。例えば「提案書の初稿作成にかかる時間」「問い合わせの一次回答までの時間」のように、導入前にも測れる指標を選んでおくと比較できます。
導入時は、機密情報の入力制限、生成コンテンツのファクトチェック体制、著作権への配慮といったリスク管理の仕組みを、利用開始と並行して整えておくことが重要です。ルールが無いまま利用が広がると、後から制限をかけたときに現場の反発を招きます。
サービスごとのデータの扱いは、提供元の公開情報で比較できます。例えばOpenAIは、ChatGPT Enterpriseなどのビジネス向けプランやAPIで扱うビジネスデータを、既定ではモデルの学習に使わないと公表しています(出典:Enterprise privacy at OpenAI)。
個人向けの無料プランと法人プランではデータの扱いが異なる場合があるため、社員が個人アカウントで業務データを入力していないかを最初に把握し、業務利用は法人プランに寄せる方針を決めておくことをおすすめします。
比較の際は、次の点を見て、自社の基準を満たさないサービスは業務データを入力する対象から外します。
PoCで効果が見えたら、いきなり全部署に広げるのではなく、同じ種類の業務を持つ部署から順に広げるのがおすすめです。例えば営業部門の提案書作成で効果が出たなら、次は同じく文書作成の多いマーケティング部門、その次はサポート部門、というように、PoCで作った手順やプロンプトを再利用できる範囲から広げます。
広げる際は、PoCで使ったプロンプトや確認手順を社内の共有場所にまとめておくと、新しく参加する部署が同じ手順で始められます。担当者個人のノウハウに留めず、引き継げる形にしておくことがポイントになってきます。自社の条件で最初の一歩を選び、確認しながら少しずつ広げることが、定着につながる進め方です。
AIの次の注目領域として、AIエージェントが挙げられます。対話型のAIが「人の指示に対して回答を返す」ものだったのに対し、エージェントは目標に向けて複数の作業を自分で進めます。この章では、エージェントの特徴と連携の規格、そして現時点での限界を整理します。
従来のAIが「人間の指示に対して1回限りの回答を返す」のに対し、AIエージェントは目標を与えると自律的に計画を立て、ツールを操作し、複数ステップのタスクを遂行します。例えば「この企業の情報を調べ、過去の商談記録と照らして、次の提案の方向性をまとめる」といった一連の作業を、エージェントは段階に分けて進められます。
| 比較項目 | AI(対話型) | AIエージェント |
|---|---|---|
| 動き方 | 指示ごとに1回回答する | 目標に向けて計画を立て、複数ステップを進める |
| 外部ツール | 基本的に使わない | ツールやデータソースを操作する |
| 人の関与 | 毎回の指示 | 目標設定と、重要な判断点での確認 |
Anthropicが提唱するMCP(Model Context Protocol)やGoogleのA2A(Agent-to-Agent)プロトコルなど、AIエージェントが外部ツールや他のエージェントと連携するための標準規格も整備されつつあります。MCPは、AIアプリケーションを外部のデータソースやツールにつなぐためのオープンなプロトコルとして公開されています(出典:Model Context Protocol)。
CRMやマーケティングオートメーションとAIエージェントを組み合わせることで、リードナーチャリングの自動化、商談データの自動分析、顧客対応の自律化といった業務自動化を検討できる段階に入りつつあります。ただし、どこまで自動化するかは自社の確認体制に合わせて決める必要があります。経営データの可視化やコンテンツマーケティングを含め、Claude Codeの業務活用に関心のある方はぜひ参考にしてください。
ただし、AIエージェントにも万能ではない領域があります。重大な意思決定を伴う業務や、例外処理が多発する業務では、人間の判断を挟む「Human-in-the-Loop」設計が重要です。
エージェントを試す業務を選ぶ際は、「途中の判断を人が確認できる地点があるか」を基準にするのがおすすめです。確認地点を置ける業務から試し、置けない業務は対話型のAIで下書きを作る使い方に留めます。技術の進化に期待しすぎず、現時点で成果を測れる領域から小さく着手し、確認地点を置きながら範囲を広げていくのがおすすめです。
AIは「導入すること」が目的ではなく、「事業課題を解決すること」が目的です。ここまで見てきた仕組み・サービス・活用領域・導入手順は、自社の業務に当てはめてはじめて意味を持ちます。この章では、設計の起点となる2つの作業を整理します。
まず自社の業務プロセスを棚卸しし、AIで効果を見込みやすい領域を特定することから始めましょう。棚卸しでは、業務ごとに次の項目を一覧にします。
一覧ができたら、頻度が高く、所要時間が長く、確認する人が決まっている業務を上から順に候補にします。この時点で候補が多すぎる場合は、データがすでに一か所にまとまっている業務を優先します。データ整備から始める必要がある業務は、AI導入と切り離して整備計画を立てます。
CRMデータとAIを掛け合わせることで、顧客理解の深化、営業プロセスの最適化、マーケティングのパーソナライズ強化といった、データドリブンなAI活用が実現しやすくなります。AIの導入を検討している企業は、まずCRM基盤の整備から着手することをおすすめします。
顧客・商談・問い合わせの情報がCRMにまとまっていれば、AIに渡すデータの範囲を迷わずに決められ、AIの処理結果をレポートにまでつなげられます。詳しくは「AIとCRMの連携活用ガイド」で、CRM×AIの具体的な設計パターンを解説しています。
費用はサービスとプラン、利用人数によって変わります。各社の公式ページで、1人あたりの月額、最低契約人数、入力データの学習への利用有無、管理者向けの機能の4点を同じ表に並べ、PoCで想定する利用人数で総額を試算して比較してください。自社専用のRAG(社内データを検索して回答に反映する仕組み)を構築する場合は、データベースやインフラの費用が追加で発生します。まずはSaaS型のAIを小規模なチームで使って効果を検証し、効果が確認できてから利用範囲と投資を広げる進め方をおすすめします。
AIのハルシネーション(事実と異なる回答の生成)は、RAGの導入と、人間によるファクトチェック体制の整備で抑制しやすくなりますが、完全になくすことはできません。「AIの出力は下書き、最終判断は人間」というルールを組織に浸透させることが重要です。確認の手順をワークフローのタスクとして組み込んでおくと、担当者が替わっても確認が抜けにくくなります。
CRMに蓄積された顧客データ・商談データ・サポートデータをAIの入力情報として活用することで、パーソナライズされた営業メールの下書き作成、商談準備の効率化、問い合わせ対応の支援がしやすくなります。データの一元管理が進んでいる企業ほど、AI活用の効果は高まりやすくなります。詳しくは「HubSpotのAI活用を総まとめ」をご覧ください。
入力となるデータがすでに整っていて、出力を確認する担当者が決まっている部署から始めるのがおすすめです。例えば、過去の提案書が共有フォルダにまとまっている営業部門や、ナレッジ記事が整理されているサポート部門は始めやすい候補です。どの部署もデータが分散している場合は、AI導入と並行してCRMへのデータ集約から進めます。
どの項目にも共通するのは、流行ではなく自社の条件で選び、小さく始めて確認しながら広げるという順番です。
まずは自社の業務プロセスを棚卸しし、「定型的で高頻度、かつ人手で時間がかかっている業務」を1つ特定するところから始めてください。次の3ステップで進めると、最初のPoCまでの道筋が見えてきます。
このテーマの全記事はAI実務活用ガイドでご覧いただけます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。