この記事の結論
AIに自分の成果物を確かめさせても、同じ見落としが残りやすい。作る役と確かめる役を別のモデルに分ける理由と、検証を意味のあるものにする設計をまとめました。
AIに自分の成果物を確かめさせても、同じ見落としが残りやすい。作る役と確かめる役を別のモデルに分ける理由と、検証を意味のあるものにする設計をまとめました。
AIが作った成果物を確かめるときは、作ったAIとは別のモデルに検証させると、同じ見落としが残りにくくなります。 StartLinkでは、作る役をClaude Code、確かめる役を別のAIであるCodexに分けています。本記事では、この役割分担をなぜ取るのか、検証を形だけにしないために何を設計するのかを整理します。
本記事は2026年10月時点の情報です。
「AIが書いたものは、AIに見直させれば十分だろう」と考える方は多いのではないでしょうか。AIにコードや資料を書かせると、作業の速さは大きく変わります。一方で、出来上がったものを確かめる工程は速くなりません。人がすべてを読むのは負担が大きく、そこで「AIに自分の成果物を見直させる」方法がよく取られます。ところが、この自己レビューは思ったほど効きません。作ったときと同じ前提、同じ解釈、同じ見落としのまま読み直すからです。研究でも、外部からのフィードバックが無い状態でモデルが自分の回答を直そうとしても、推論の精度は上がらず、むしろ下がる場合があると報告されています(Huang et al., 2023, “Large Language Models Cannot Self-Correct Reasoning Yet”)。ただしこれは推論課題での結果であり、コードや資料の検証にそのまま当てはまるとは限りません。
ここで扱うのは特定の製品の使い方ではなく、検証の設計です。製品の導入手順はCodex Plugin×Claude Codeの記事にまとめています。
AIを開発や業務に組み込み、その成果物の品質に責任を持つ立場の方に向けて書いています。最後まで読むと、自社の成果物にどこから別モデルの検証を組み込むかを判断できます。
自己レビューが効きにくい理由は、AIが怠けるからではありません。作る工程と確かめる工程が、同じ前提を共有してしまうことにあります。
AIは作業の途中で、「この要件はこういう意味だろう」「この関数はこう使われるはずだ」という解釈を積み上げます。同じ会話の中で見直しを頼むと、その解釈を正しいものとして読み直します。要件の読み違いや、存在しない前提の上に組んだ処理は、この読み直しでは浮かびません。前提そのものを疑う視点が無いからです。
確かめる観点を、作った側が決めているという問題もあります。「何を確認すれば十分か」を作った本人が考えると、気にしていた点は丁寧に確認される一方、そもそも思い至らなかった点は観点に入りません。観点の外側にある欠陥は、どれだけ丁寧に確認しても見つかりません。これは人のレビューでも知られている性質で、AIでも同じことが起きます。
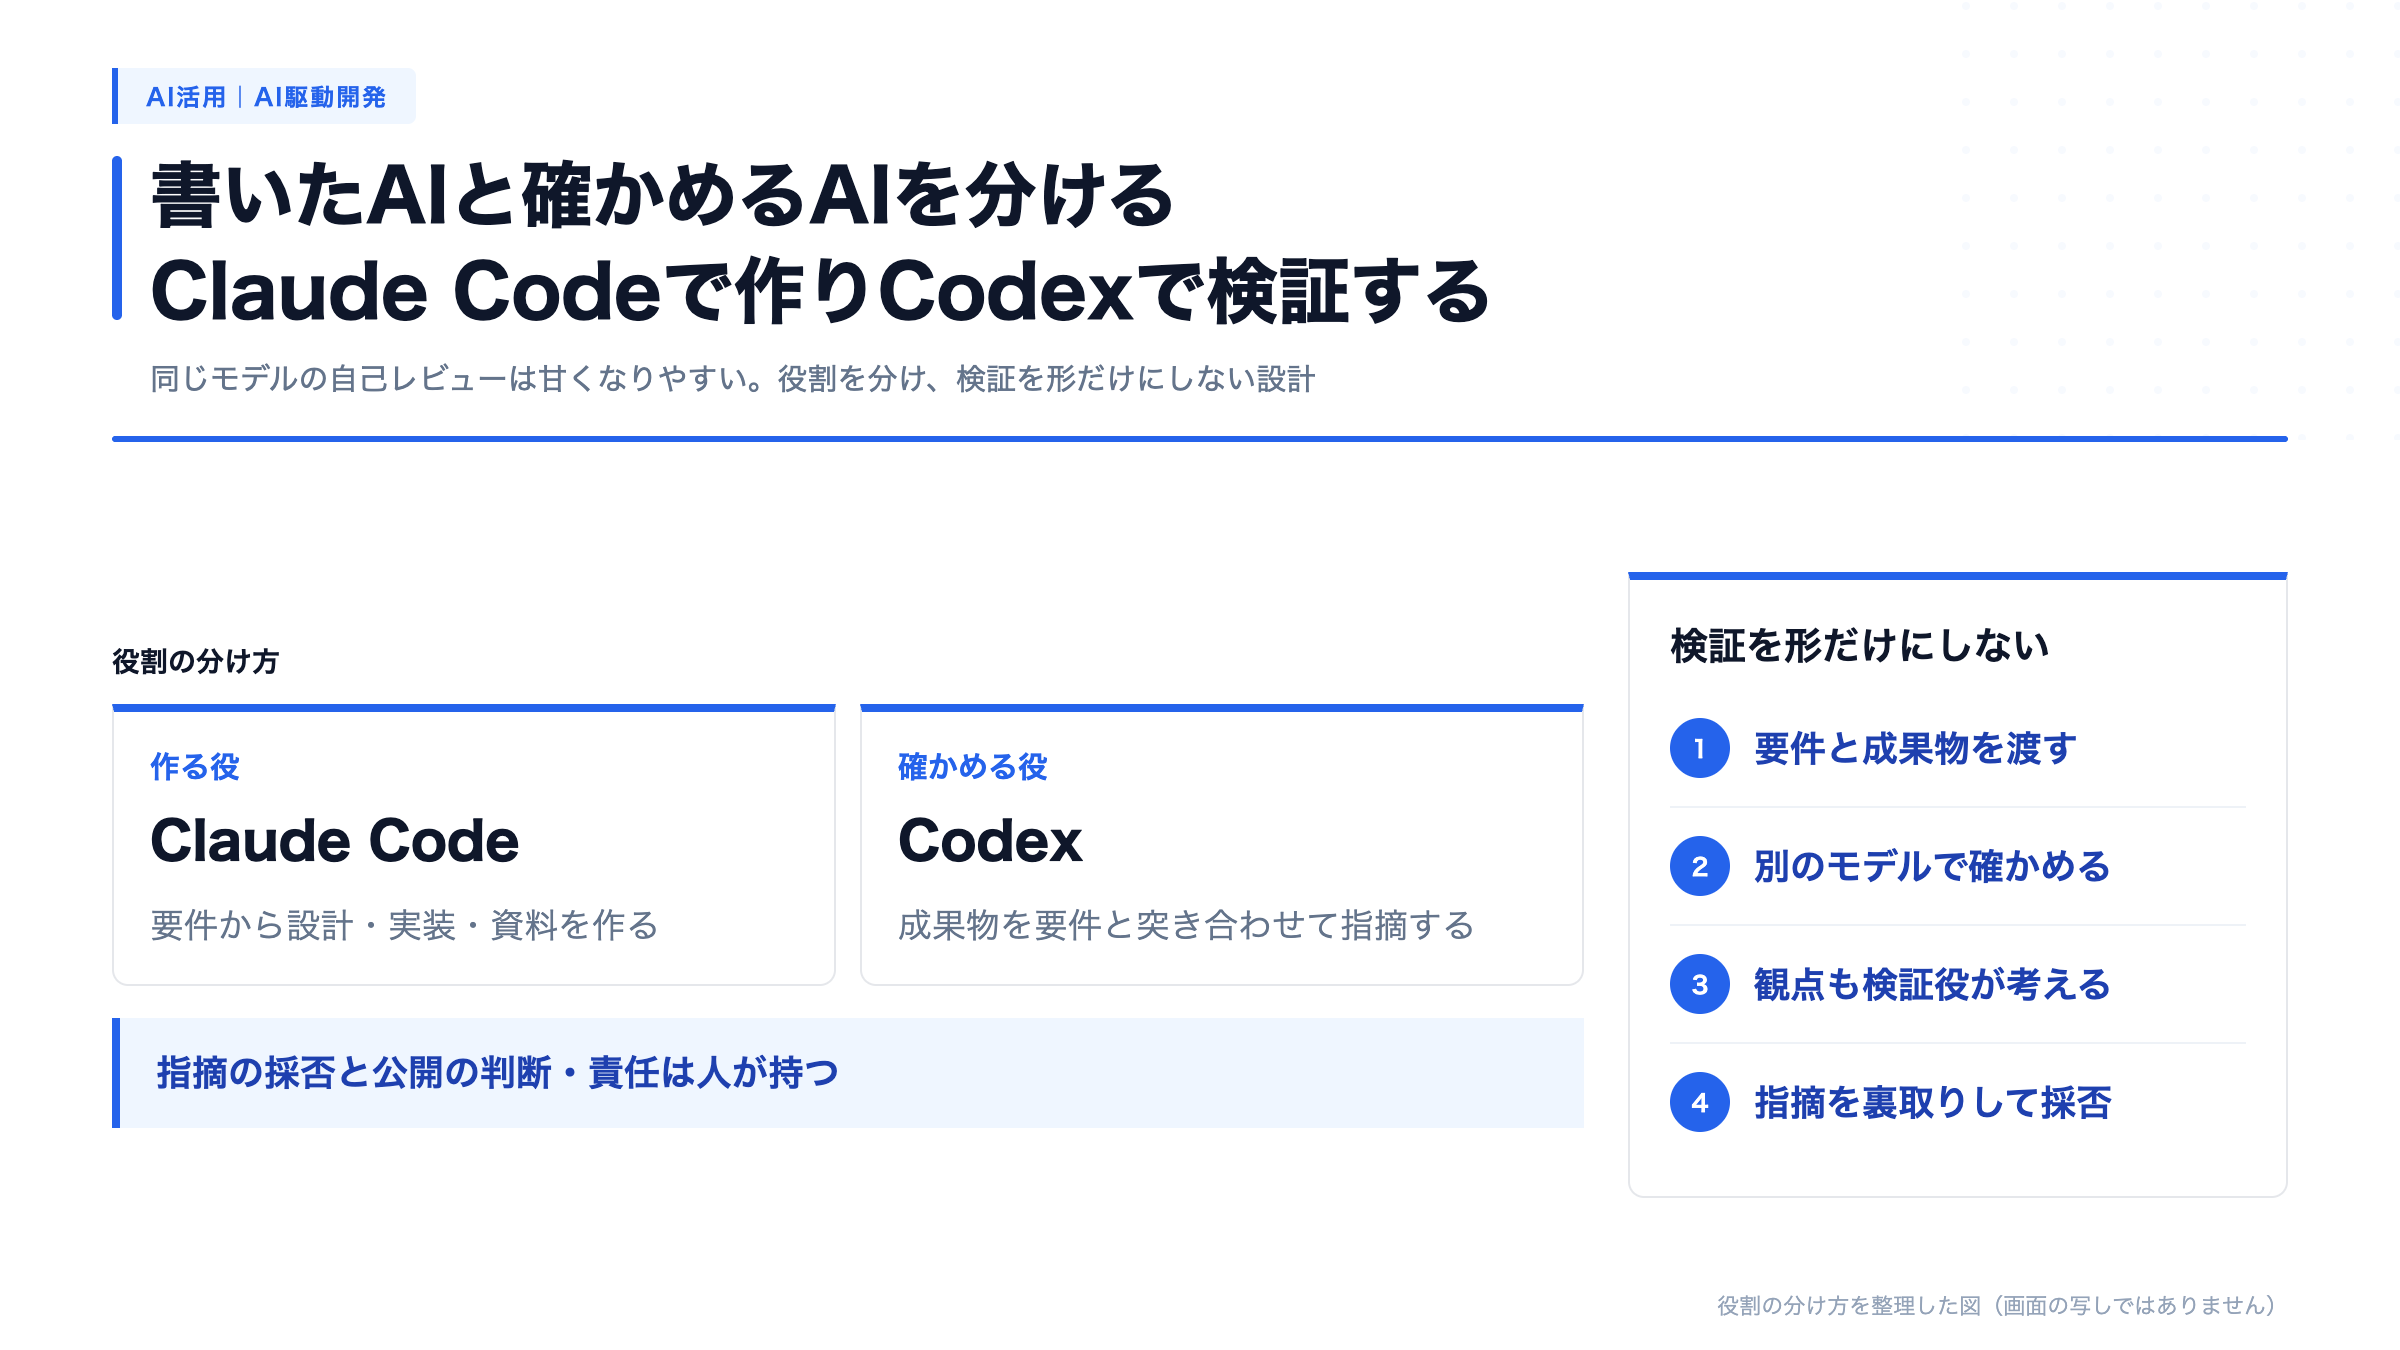
同じモデルは、学習のされ方が同じなので、苦手な領域も似ています。ある書き方の落とし穴に気づかないモデルは、作るときも確かめるときも気づかない可能性が高くなります。会話を新しくしても、モデルが同じなら傾向は残ります。次の図は、こうした問題を避けるために作る役と確かめる役を分けた役割分担を整理したもので、作る役が成果物を作り、確かめる役が指摘し、判断と責任は人が持つ流れになっています。
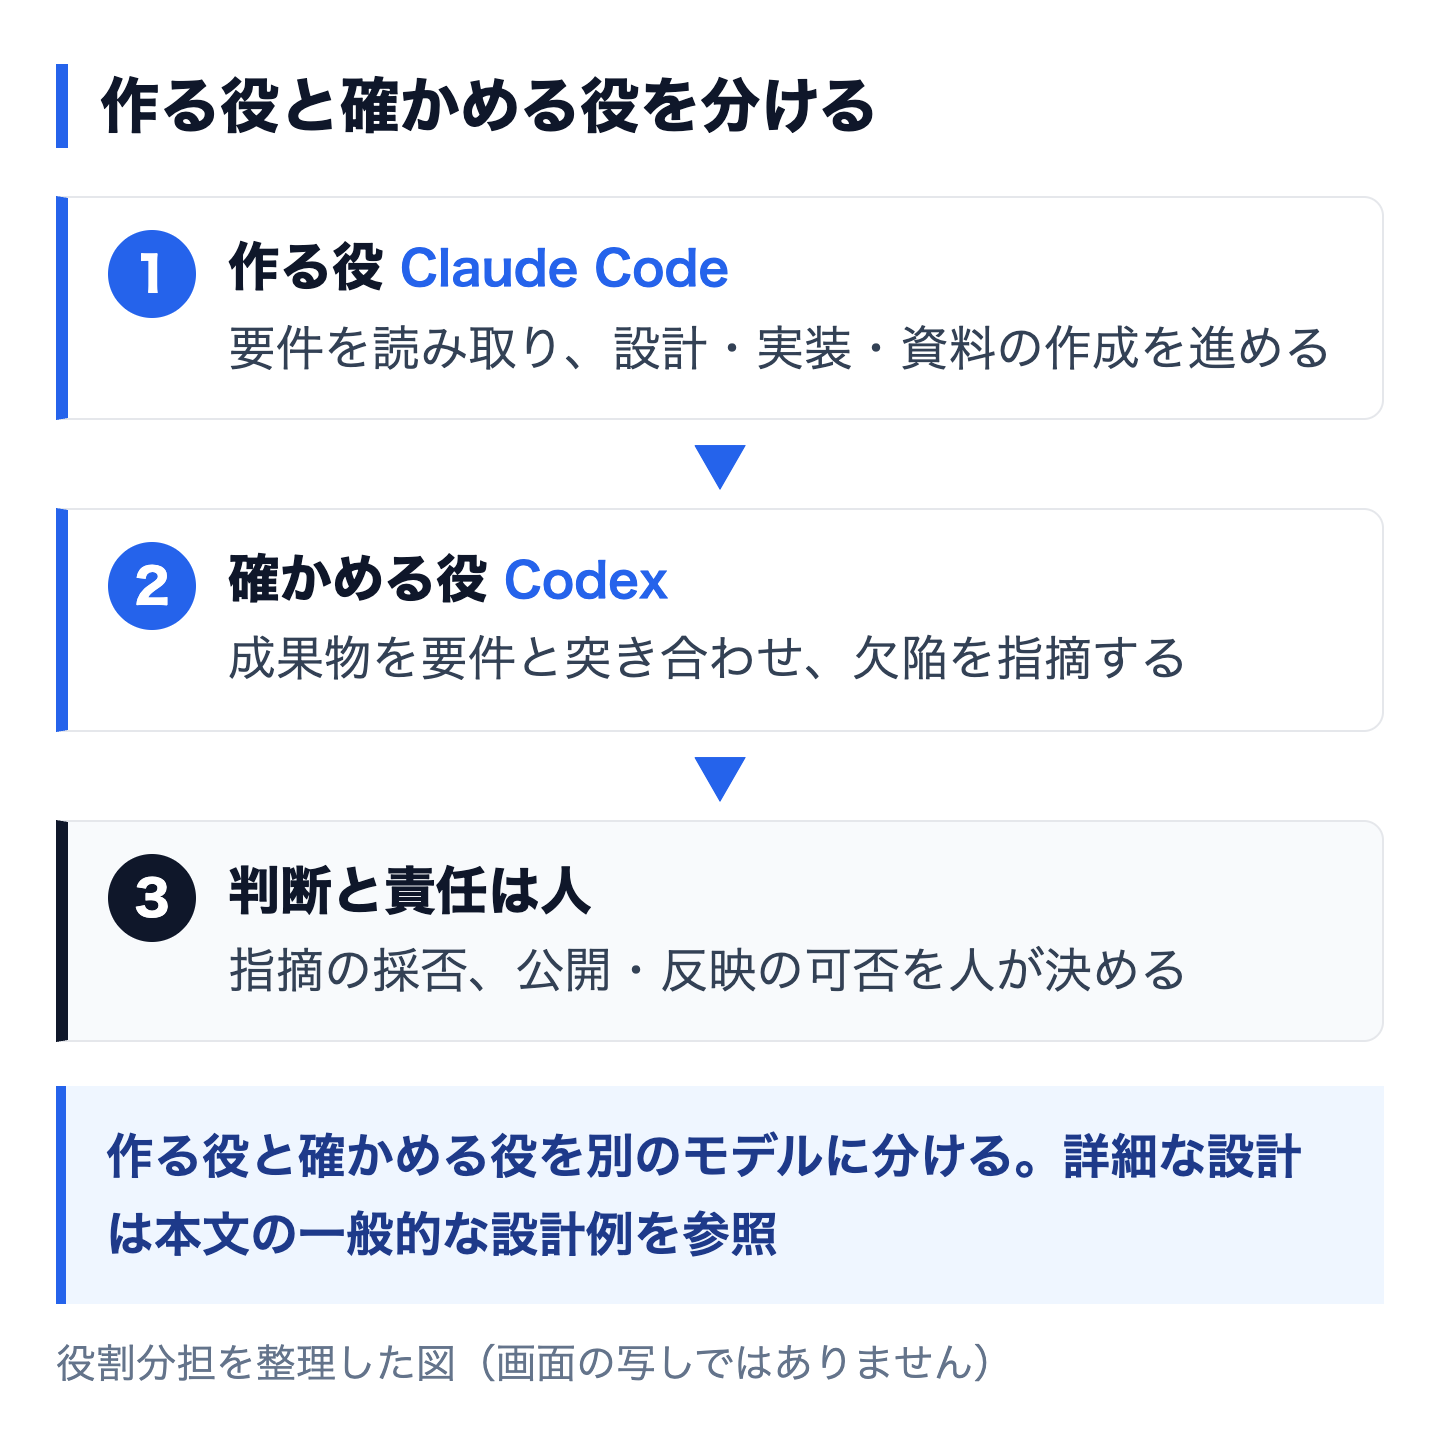
この問題への対処は単純で、確かめる役を別のモデルに渡すことです。本記事では、これを「作る・確かめる・決める」の3役に分けて考えます。前提を共有せず、苦手な領域も違うモデルに読ませると、作る側の観点の外側に光が当たります。
StartLinkでは、社内で最も使っていて作業の流れ全体を任せやすいため、開発や資料作成の中心にClaude Codeを置き、作業の統括を任せています。成果物の採否や公開の判断、その責任は人が持ちます。
当社では、Claudeとは別のモデルに確かめさせることで自己レビューの甘さを補えるため、間違えると影響の大きい成果物は、別のAIであるCodexに検証させる役割分担を取っています。
| 役 | 担うもの | 使っているもの |
|---|---|---|
| 作る役 | 要件の読み取り、設計、実装、資料の作成 | Claude Code |
| 確かめる役 | 成果物と要件の突き合わせ、欠陥の指摘 | Codex |
| 判断する役 | 指摘の採否、公開・反映の可否と責任 | 人 |
Codexは実装もできるモデルですが、ここでは検証役として置いています。作る道具を2つ並べて比べるのではなく、作る道具と確かめる道具を分ける、という位置づけです。
すべての成果物に別モデルの検証をかける必要はありません。時間も費用もかかるからです。検証役を置く場面は、間違えたときの影響で決めます。
反対に、手元で試すだけの小さな変更や、すぐに作り直せる下書きは、作る役の中で完結させて構いません。
別のモデルに渡しただけでは、検証は意味を持ちません。何を渡し、何をさせないかで、指摘の質が決まります。以降は、検証役を置くときの一般的な設計例です。
| 渡すもの | 渡さないもの |
|---|---|
| 要件(何が成立したら完了か) | 作る役が途中で考えたこと・言い訳 |
| 成果物そのもの(差分・ファイル) | 「問題ないはず」という作る役の結論 |
| 突き合わせる一次情報の場所(仕様、元データ) | 作る役が選んだ確認の観点だけ |
大事なのは、作る役の解釈を渡さないことです。「この部分はこういう意図で書いた」と添えると、検証役もその意図の上で読みます。前提を共有しないという利点が消えてしまいます。渡すのは要件と成果物と一次情報で、両者を突き合わせる作業は検証役に任せます。
検証役には、成果物を直す権限を与えません。直せる状態にすると、指摘の代わりに修正が返ってきて、何が問題だったのかが見えにくくなります。作る役と確かめる役の境目もあいまいになります。
Codexの場合、スクリプトから呼び出す codex exec は、既定で読み取り専用のサンドボックスで動きます。対話で使う場合も、起動時に読み取り専用を指定できます。
# 既定は読み取り専用。最終的な回答だけを標準出力に返す
codex exec "このブランチの差分を、REQUIREMENTS.md の要件と突き合わせて欠陥を挙げて"

# 対話で使うときも読み取り専用で起動できる
codex --sandbox read-only
Codexの対話画面には、作業ツリーの変更をレビューさせる /review も用意されています。なお、Claude Codeにも /review がありますが、これは現行の公式ドキュメントでは /code-review の別名で、Claude Code自身が差分をレビューするコマンドです。Codexの /review とは別のものです(Claude Code側の仕様は公式のコマンド一覧で確認できます)。どの方法でも、検証役は「読んで指摘する」に留めます。仕様はCodexの公式ドキュメントで確認できます。
「この3点を確認して」と観点を指定すると、検証役はその3点を確認して終わります。観点を作った側の盲点が、そのまま検証にも引き継がれます。指定するなら「最低限この点は見る」とし、それ以外に気づいたことも挙げるよう求めます。要件と成果物の食い違いを、検証役自身の観点で探させるのが狙いです。
別のモデルの指摘にも誤りはあります。存在しない問題を指摘したり、要件を取り違えたりすることがあります。検証役の指摘を無条件に採用すると、今度は検証役の見落としが成果物に入ります。
指摘を受けたら、その指摘が正しいかを、コード・仕様・元データといった一次情報で確かめます。「このファイルのこの行で、こういう入力のときにこう壊れる」と再現できれば採用し、再現できなければ保留にします。指摘の数ではなく、裏取りできた指摘の数が検証の成果です。
たとえば、データ移行のスクリプトに対して「空の項目があると途中で止まる」という指摘が返ってきたとします。この場合は、空の項目を含む少量のサンプルデータで実際に流し、止まるかどうかを確かめます。止まれば採用して作る役に戻し、止まらなければ保留にして、指摘の根拠を検証役に尋ねます。
検証役に渡しても、成果物の責任は作る側と判断する人に残ります。「別のAIが確認したから大丈夫」は、作る役の自己レビューと同じ種類の思い込みです。検証は判断の材料を増やす工程であって、判断を代わりにしてくれる工程ではありません。
作る役と検証役の見解が分かれ、一次情報でも決着がつかないことがあります。その場合は、どちらかのAIに決めさせず、人が判断します。仕様の解釈が割れているなら、仕様を決めた人に確かめるのが近道です。
役割を分けても、すべての欠陥が見つかるわけではありません。導入前に知っておきたい限界を挙げます。
検証役は、要件と成果物を突き合わせます。要件そのものが間違っていれば、要件どおりに作られた成果物を「問題なし」と判断します。何を作るべきかの判断は、人が担う部分として残ります。
読むだけの検証では、実行して初めて分かる問題(外部サービスとの結合、環境の違い、データ量による遅さ)は拾えません。テストを走らせる、実際の画面で確かめるといった実測の工程と組み合わせる必要があります。
検証を挟めば、その分だけ時間と利用料がかかります。すべてに適用すると、作業の速さというAIの利点を削ります。前の節のとおり、間違えたときの影響で対象を絞るのが現実的です。
別のモデルでも、広く知られた誤りや古い情報は共有していることがあります。最新の仕様や料金のように変わりやすい事実は、どちらのモデルの答えでもなく、公式の情報源で確かめます。
会話を分ければ、作業の途中の解釈は引き継がれません。その意味で一定の効果はあります。ただし、モデルが同じなら苦手な領域や間違えやすい書き方も同じです。影響の大きい成果物では、別のモデルに確かめさせるほうが観点の外側を拾いやすくなります。
速さだけを見ればそうです。ただ、検証役が直すと、何が問題で、なぜその直し方なのかが作る側に残りにくくなります。作る役と確かめる役の境目を保つために、検証役は指摘に留め、直すのは作る役に戻すのが基本です。
元に戻しにくい変更、他の人が使う成果物、確信が持てないとき、の3つが目安です。手元で試すだけの変更まで検証をかけると、時間と費用に見合いません。
要らなくはなりません。要件が正しいか、指摘を採用するか、公開してよいかは人が判断します。別モデルの検証は、人が読む量を減らし、判断の材料をそろえるための工程です。
AIに自分の成果物を確かめさせると、作ったときと同じ前提と同じ観点で読み直すため、見落としが残りやすくなります。StartLinkが取っている形は、作る役をClaude Code、確かめる役を別のモデルであるCodexに分けるという役割分担です。一般的な設計としては、検証役に要件と成果物と一次情報を渡し、読み取り専用で指摘させる形が基本になります。
この設計で大事なのは、検証役の指摘も一次情報で裏取りすること、そして検証に渡しても責任は移らないことです。要件の誤りや、動かして初めて分かる問題は、別のモデルの検証でも見つかりません。人の判断と実測の工程は残ります。
コマンドのオプションや画面上のコマンド名は更新で変わることがあります。本記事の記述は冒頭に記した時点で公式ドキュメントを確認した内容ですので、実際に使う前にもう一度、公式の最新の記載を確かめてください。
最初の一歩は、スモールスタートで始めることです。まず、自分たちの成果物のうち、元に戻しにくいものを1種類だけ選びます。その成果物について、要件を一文で書き出し、作ったAIとは別のモデルに、読み取り専用の権限で要件との食い違いを挙げさせます。出てきた指摘を一次情報で裏取りし、採否を人が決めるところまでを1回通すと、自社に合う検証の粒度が見えてきます。最適な形は企業ごとに異なるため、最初から全社の標準にせず、1種類で試してから対象を広げていくのが現実的です。属人的な確認に頼らず、要件の書き方と検証の依頼文を決まった型にしておけば、担当が変わっても同じ水準で回せる仕組みになります。
AIを業務に組み込むとき、作る速さに目が行きがちですが、成果を左右するのは確かめる工程の設計です。HubSpotのワークフローやデータ移行、外部システムとの連携開発のように、元に戻しにくい変更を扱う場面では特に、検証の設計が手戻りや事故を減らします。これは導入の初期に決めておくほど効果が出る投資です。StartLinkでは、AIの成果物をどう確かめるかを含めた導入の設計から支援しています。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。