この記事の結論
ナレッジグラフとGraphRAGを理解すれば、AIに社内情報を聞いたときの回答精度を底上げできます。情報の「点」ではなく「関係性」でAIに答えさせる、その仕組みを解説します。
ナレッジグラフとGraphRAGを理解すれば、AIに社内情報を聞いたときの回答精度を底上げできます。情報の「点」ではなく「関係性」でAIに答えさせる、その仕組みを解説します。
ナレッジグラフとGraphRAGを理解すれば、AIに社内情報を聞いたときの回答精度を底上げできます。情報の「点」ではなく「関係性」でAIに答えさせる、その仕組みを解説します。
「ChatGPTに社内資料を読み込ませても、聞きたいこととズレた答えが返ってくる」「複数の資料にまたがる質問をすると、AIが一部の情報しか拾ってくれない」「Notionや社内Wiki、CRM、チャットに情報が散らばっていて、どこに何があるか担当者しか把握していない」——AIの社内活用を進める中で、こうした声を耳にする機会が増えています。
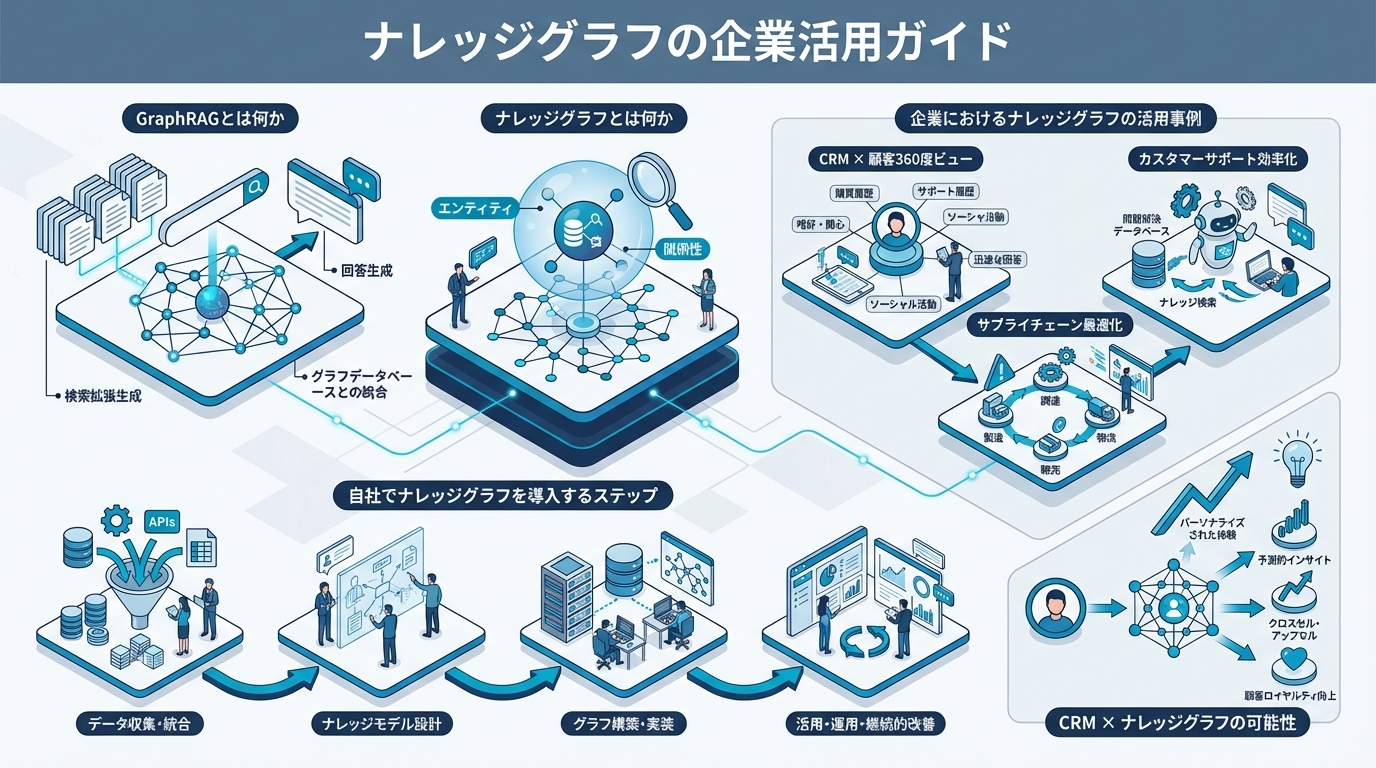
ナレッジグラフとは、知識を「エンティティ(実体)」と「リレーション(関係)」のネットワークとして表現するデータ構造です。この構造をAIの検索拡張生成(RAG)と組み合わせたものがGraphRAGで、Microsoftが公開したことで企業のAI活用における選択肢として注目されるようになりました。
AIを社内情報の検索に活用したいものの、どこから手を付ければよいかわからないという情報システム部門・経営企画部門の方に向けて、基本概念から導入の進め方までを整理しました。
情報システム部門・経営企画部門の方に向けて書いています。最後まで読むと、自社に合ったスコープでナレッジグラフを検討し、最初の一歩を踏み出せるようになります。
AIに社内情報を聞いても的外れな回答が返ってくる背景には、情報が「点」としてバラバラに保存されているという構造的な問題があります。
ナレッジグラフは、この点と点を「関係性」でつなぎ、AIが文脈を踏まえて回答できるようにするためのデータ構造です。まず基本概念を押さえた上で、企業が注目する理由と、日々の情報管理との関係を整理します。
ナレッジグラフを構成する要素は、大きく3つに整理できます。
| 要素 | 説明 | 例 |
|---|---|---|
| エンティティ(ノード) | 知識の対象となるモノ・概念 | 「HubSpot」「CRM」「営業部門」 |
| リレーション(エッジ) | エンティティ間の関係性 | 「HubSpotはCRMの一種である」「営業部門がHubSpotを利用する」 |
| プロパティ | エンティティの属性情報 | 「HubSpotの導入時期」 |
例えば、「営業部門がHubSpotを利用しており、HubSpotはCRMの一種であり、CRMは顧客管理に使われる」という知識は、エンティティ同士を矢印でつないだグラフとして表現できます。
この構造により、「営業部門が顧客管理に使っているツールは何か?」という間接的な質問にも、グラフをたどることで回答できるようになります。
従来のテーブル形式のデータベースでは、行と列の中にこうした関係性を表現しにくいため、この違いがナレッジグラフの大きな特徴です。
身近な例として、Googleは検索エンジンのコアにナレッジグラフを導入しており、質問に対して検索結果のリンク一覧ではなく、直接的な回答を返せるようになりました。同じ原理を企業内に適用すると、社内情報の検索体験も同様に変わっていきます。
企業内の情報は、ドキュメント・データベース・チャット・メールなど複数のシステムに分散しているのが実情です。
次のような情報を一気に把握しようとしても、システムをまたいで探し回る必要があり、単純なキーワード検索では追いきれません。
ナレッジグラフでこれらの情報に関係性を持たせて統合すれば、こうした横断的な問いにも答えられる環境に近づけていけます。
ナレッジグラフの話に入る前に、前提として押さえておきたいのが日々の情報管理の状態です。例えば、次のような管理が挙げられます。
こうした管理では、手動での更新が増えてファイル間で差分が起きやすく、どれが最新の正しい情報なのか担当者しか把握していない状態になりがちです。
このようにデータの分散と差分が残ったままAI検索やナレッジグラフを載せても、回答の根拠となるデータ自体がバラバラなため、期待した精度が出にくくなります。
まず「どのデータを正とするか」を社内で決めることが、グラフ化に取り組む前の土台になると考えています。
社内文書をベクトル検索で参照する従来のRAGは、単発の事実確認には強い一方で、複数の文書にまたがる質問や全体像を尋ねる質問には弱いという課題を抱えています。
GraphRAGは、この弱点をナレッジグラフの力で補う技術です。ここでは従来のRAGの限界と、GraphRAGがどのようにそれを解決するのかを整理します。
RAG(Retrieval-Augmented Generation)は、AIが回答を生成する際に外部データを検索して参照する技術です。社内ドキュメントをベクトルデータベースに格納し、質問に関連する文書チャンクを検索してAIに渡すのが一般的な実装ですが、以下の限界があります。
Microsoftが公開したGraphRAGは、この限界を突破するためにナレッジグラフを活用します。処理の流れは以下のとおりです。
従来のRAGが「質問に似た文書の断片を拾う」のに対し、GraphRAGは「関係性の地図をたどって答えを組み立てる」と捉えると、違いがイメージしやすくなります。
| 評価軸 | 従来のRAG | GraphRAG |
|---|---|---|
| 個別事実の検索 | 高精度 | 高精度 |
| 関係性を含む質問 | 低〜中精度 | 高精度 |
| 要約・全体像の質問 | 低精度 | 高精度 |
| 構築コスト | 低い | 中〜高い |
| 更新の容易さ | 容易 | 中程度 |
Microsoftの評価実験では、GraphRAGは特に「要約型の質問」と「複数文書にまたがる質問」において、従来のRAGよりも回答の網羅性が大きく向上したと報告されています。
ただし構築コストは従来のRAGより高くなる傾向があるため、どの範囲にGraphRAGを適用するかは事前に見極めておく必要があります。
すべてをGraphRAGに置き換えるのではなく、従来のRAGで足りる領域と使い分ける発想が現実的です。
ナレッジグラフは理論だけの技術ではなく、大手企業がすでに事業の中核で活用しています。検索エンジンから商品推薦、社内ナレッジの統合、製造現場の暗黙知の構造化まで、活用の幅は業種を問わず広がっています。
ここでは実名で公開されている取り組みを紹介します。
| 企業 | 活用の領域 | ポイント |
|---|---|---|
| 検索エンジンの知識基盤 | 「検索してリンクをたどる」体験から「聞けば直接答えが返ってくる」体験へ | |
| Amazon | 商品推薦グラフ | 商品間の関係性をあらかじめ定義し、文脈を理解した推薦へ |
| NTTデータ | 社内ナレッジグラフの構築 | プロジェクト管理情報と技術ドキュメントを統合 |
| パナソニック コネクト | 製造ナレッジの構造化 | 故障原因・対処法・設備間の依存関係をグラフで可視化 |
Googleは検索エンジンのコアにナレッジグラフを据えており、膨大な数のエンティティとリレーションを管理しています。このナレッジグラフをもとに、検索結果の右側に表示されるナレッジパネルやGoogle Assistantの回答が生成されています。
「検索してリンクをたどる」体験から「聞けば直接答えが返ってくる」体験への転換を、ナレッジグラフが支えている代表的な例です。
Amazonは商品カタログをナレッジグラフで管理し、商品間の関係性(「一緒に買われやすい」「代替品」「上位互換」等)をグラフ構造で表現しています。これにより、単なる購買履歴ベースではない、文脈を理解した商品推薦を実現しています。
商品という「点」同士の関係性をあらかじめ定義することで推薦の質を上げている点は、企業内の情報整理にも応用できる考え方です。
NTTデータは、プロジェクト管理情報と技術ドキュメントをナレッジグラフで統合する取り組みを進めています。次のような、複数のデータソースにまたがる問い合わせに対して、グラフをたどって網羅的に回答できる仕組みを構築しています。
冒頭で挙げた「複数の資料にまたがる質問にAIが答えられない」という課題への、企業規模での回答例と言えます。
パナソニック コネクトは、製造現場のベテラン技術者が持つ暗黙知を構造化するためにナレッジグラフを活用しています。故障原因・対処法・設備間の依存関係をグラフで可視化し、AIによる故障診断の精度向上に役立てています。
個人の頭の中にあった知識を「関係性」として形式化するという点で、ナレッジグラフが属人化の解消にもつながることを示しています。
HubSpotのようなCRMには、コンタクト・会社・取引・チケットといった情報がリレーションデータベースとして紐づいて蓄積されています。この構造自体が、実はナレッジグラフの考え方と親和性の高いものです。
ここでは、CRMのデータをナレッジグラフに接続する発想と、その際に意識しておきたい設計の考え方を整理します。
HubSpotでは、コンタクト・会社・取引・チケットが1つのデータベースの中でリレーションとして結びついています。
この一気通貫で管理されたデータに、社内Wikiやチャット履歴のナレッジをグラフとして接続すれば、「この顧客との全ての接点と、関連する社内ナレッジ」を横断的に把握できる環境に近づけていけます。
コンタクトから取引、請求までを1つのデータベースでつなぐという発想は、ナレッジグラフがエンティティ同士をリレーションでつなぐ発想と根本的に同じものだと考えています。
また、HubSpotが提供するAI機能群のBreezeは、こうしたCRM上のデータの要約や参照を担う方向で提供されており、CRMとAIの接続は今後さらに身近になっていくと考えています。
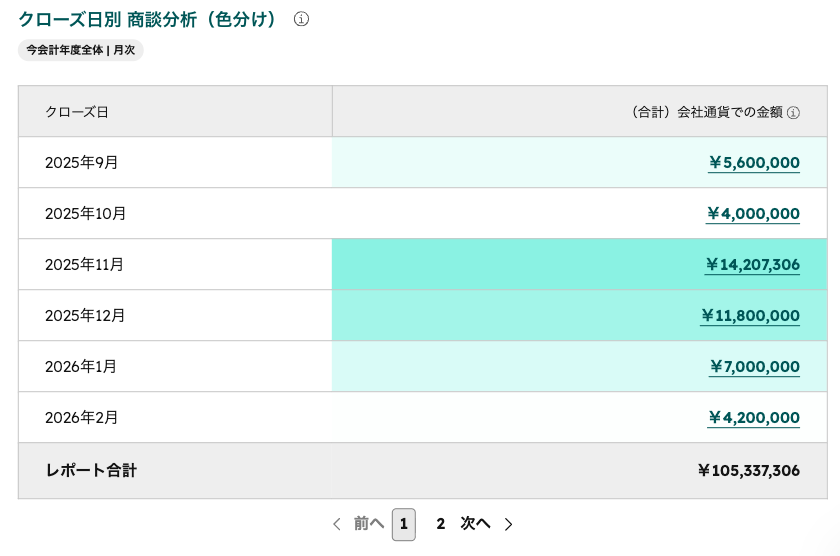
以下の画面は、HubSpotのレポートで蓄積した取引データをテーブル形式に可視化した例です。CRMの中でどのようにデータが紐づき、可視化されているかのイメージとして参考にしてください。
CRMのデータだけでナレッジグラフを完結させる必要はありません。社内Wikiの手順書やチャットのやり取りをあわせて接続することで、営業とサポート、開発など部門をまたいだ情報の分断を防ぎやすくなります。
例えば次のような問いに、CRMの顧客情報と社内ナレッジをまたいで答えられる形が理想です。
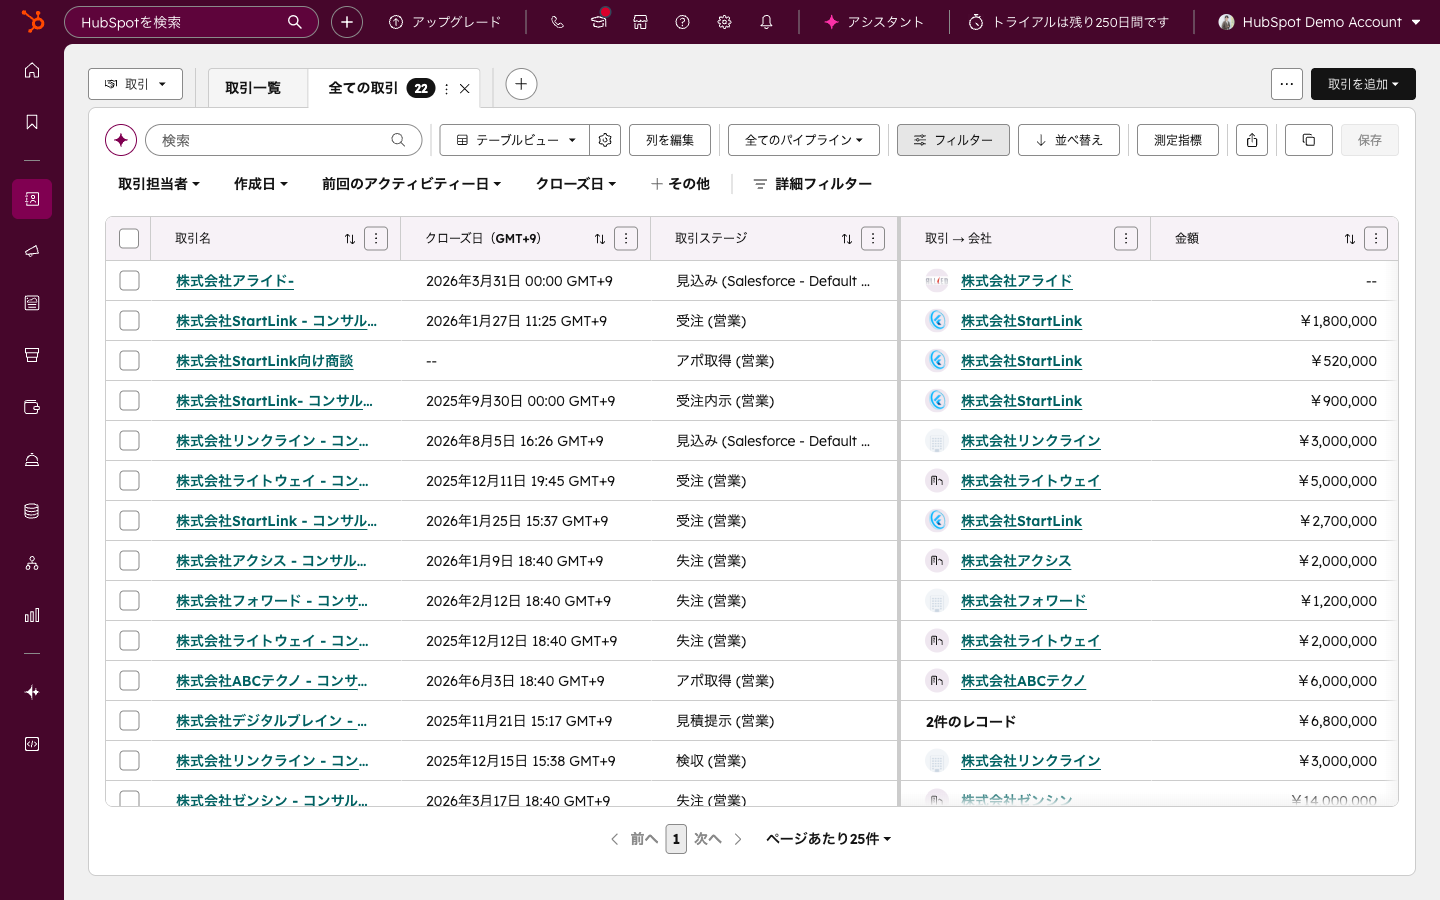
以下の画面は、HubSpotで案件(取引)をテーブルで一覧確認している例です。CRMに蓄積されたデータが、参照・集計しやすい形で整理されている様子がわかります。
ただし、どこまでのデータソースを統合するかは、企業様によって最適な形は異なります。取り扱う情報の機密性や運用体制を踏まえて、統合範囲を検討することが大切です。
ここまでHubSpotを例に説明してきましたが、この親和性はHubSpotに限った話ではありません。コンタクト・会社・取引がリレーションとして紐づく構造を持つCRMであれば、同様の考え方でナレッジグラフへの接続を検討できるケースがあります。
私たちはHubSpotを中心にご支援していますが、大切なのはツールの名前ではなく、顧客・商談・活動履歴が「関係性」として整理されているかどうかだと考えています。
別のCRMをお使いの企業でも、自社のデータ構造の棚卸しから同じように始められます。
CRMデータを活用したナレッジグラフの設計やGraphRAGの企業導入については、HubSpotゴールドパートナーのStartLinkがCRM×AI活用の知見をもとにした設計をご提案しています。
ナレッジグラフは一度に全社展開しようとすると、データ整備や品質管理の負荷が大きくなりがちです。
すべてを一気に進めるのは難しいため、自社で活用できそうな領域・効果が出そうな領域を見極めて優先順位をつけ、段階的に広げていくアプローチが現実的です。ここでは5つのステップに分けて進め方を整理します。
ナレッジグラフの構築はコストがかかるため、最初から全社展開するのではなく、特定のユースケースに絞って始めます。効果が出やすいユースケースとしては、以下が挙げられます。
スコープが決まったら、ナレッジグラフに統合するデータソースを特定します。次のような既存のデータソースを洗い出すところから始めます。
ここでスプレッドシートで個別に管理していた顧客リストや案件一覧をそのまま持ち込むと差分が生じやすいため、どのデータを正とするかを事前に決めておくことをおすすめします。
データソースの棚卸しができたら、用途に合わせて技術スタックを選びます。代表的な選択肢は以下のとおりです。
| 技術 | ツール例 | 用途 |
|---|---|---|
| グラフデータベース | Neo4j、Amazon Neptune、Azure Cosmos DB | ナレッジグラフの格納 |
| エンティティ抽出 | spaCy、OpenAI GPT-4、Google Cloud NLP | テキストからのエンティティ自動抽出 |
| GraphRAGフレームワーク | Microsoft GraphRAG、LangChain + Neo4j | グラフベースの検索拡張生成 |
| 可視化 | Neo4j Bloom、Gephi | グラフ構造の可視化・探索 |
技術を選定したら、小規模なドキュメント群でプロトタイプを構築し、従来の検索と比較して回答精度がどの程度向上するかを検証します。
Microsoftが公開しているGraphRAGのオープンソース実装を活用すれば、概念実証(PoC)レベルであれば比較的短期間で構築できる場合があります。
この段階では、大きな投資判断の前にまず小さく試すことがポイントになってきます。
PoCで効果が確認できたら、データソースを段階的に拡張していきます。
誰が対応しても一定の品質を保てるよう、更新ルールやレビュー体制をあらかじめ仕組みとして定めておくことをおすすめします。
担当者が交代したり新人が加わったりしても運用が回る状態を作ることが、長く使い続けるための条件です。
人に依存するのではなく仕組みで担保するという考え方は、CRMのプロパティ運用やワークフロー設計にも通じるものだと考えています。
HubSpotゴールドパートナーが開発・提供 — 新しい連携ツールは、まず小さく試してから判断したいものです。StartLinkが提供するSync for Notionは無料プランから利用でき、HubSpotのCRM画面からNotionページ・データベースを操作する基本機能を試した上で、必要に応じてアップグレードを検討できます。HubSpotマーケットプレイスからインストールできます。
ナレッジグラフとGraphRAGは強力な技術ですが、導入すれば何でも解決するわけではありません。
どこまでをAIに任せ、どこからを人が判断するのか、また自社の状況としてどこまで向いているのかを、導入前に率直に見極めておくことが大切です。
| AIが得意な作業 | 人が判断すべきこと |
|---|---|
| エンティティ・関係性の自動抽出 | どのデータソースを統合対象にするか |
| コミュニティ検出・階層的要約の生成 | 重複エンティティの統合基準の設定 |
| 質問に応じたグラフ検索と回答生成 | 誤ったリレーションの最終判断・修正 |
AIはエンティティの抽出や要約の生成を高速にこなせますが、どのデータを信頼できる情報源として扱うか、誤って抽出された関係性をどう修正するかは、最終的に人が判断する領域です。
AIに任せきりにせず、抽出結果を人がレビューする工程を組み込んでおくことをおすすめします。生成物を公開・活用する前に人が確認する運用は、社内からの信頼を得る上でも重要な工程です。
GraphRAGのような高度な仕組みを導入しても、インプットするナレッジ自体が古い・間違っている・バラバラでは、回答の精度は上がりません。
AIの回答品質は、突き詰めるとインプットするナレッジの品質で決まると考えています。
ナレッジが整っていればAIの回答精度も上がりやすいため、情報を正しく入力しつつ、AIに理解しやすい形でインプットしてあげることがポイントになってきます。
具体的には、次のような地味な運用設計が、実際の回答精度を左右します。
ただし、次のようなケースもあります。
まずは特定のユースケースで小さく検証し、効果を確認してから広げていくのが現実的です。
ナレッジグラフは知識をエンティティとリレーションのネットワークとして表現するデータ構造そのものを指します。GraphRAGは、そのナレッジグラフをAIの検索拡張生成(RAG)と組み合わせた技術で、関係性をたどりながら回答を生成する仕組みです。両者は対立する概念ではなく、GraphRAGはナレッジグラフを活用する具体的な方法の1つと捉えると理解しやすくなります。
単発の事実確認が中心であれば従来のRAGで十分なケースが多く、構築コストも抑えられます。複数の文書にまたがる質問や「全体像を教えてほしい」といった要約型の質問に答えたい場合は、GraphRAGが向いています。どちらか一方に置き換えるのではなく、用途に応じて使い分ける発想が現実的です。
最初から全社展開を目指すのではなく、カスタマーサポートのFAQ回答や技術ドキュメントの横断検索など、効果を確認しやすい特定のユースケースに絞って始めることをおすすめします。小規模なデータセットでプロトタイプを検証し、従来の検索と比較して回答精度がどの程度向上するかを確認した上で、段階的にデータソースを広げていくのが現実的な進め方です。
HubSpotのようなCRMはコンタクト・会社・取引・チケットがリレーションとして紐づいており、ナレッジグラフとの親和性が高いデータ構造を持っています。他のCRMでも、顧客・商談・活動履歴が関係性として整理されていれば同様の考え方が使えます。ただし統合範囲は企業様によって最適な形が異なるため、機密性や運用体制を踏まえて検討することが大切です。
特定の担当者だけがエンティティの定義やリレーションの修正基準を把握している状態は、属人化のリスクにつながります。更新ルールやレビュー体制をあらかじめ仕組みとして定めておき、担当者が変わっても一定の品質を保てるようにしておくことをおすすめします。
ナレッジグラフは、企業内に散在する情報を「関係性」で結びつけ、AIの回答精度を高める技術です。従来のRAGでは対応が難しかった要約型の質問や複数文書にまたがる質問にも、GraphRAGを組み合わせることで対応しやすくなります。
まずは、社内に散らばっている情報のうち「AIにうまく答えてほしいのに答えられていない」場面を1つ具体的に挙げてみることから始めてみてください。その上で、次の3ステップで進めると、無理なく着手できます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
経営管理の理解をさらに深めるために、ヘルプデスクのナレッジ活用ガイドもあわせてご覧ください。また、Notionで社内Wikiを構築する方法も関連するテーマを扱っています。
本記事は社内Wiki・ナレッジベースカテゴリに属しています。経営管理全体を体系的に学びたい方は経営管理完全ガイドをご覧ください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。