この記事の結論
RAG(検索拡張生成)は、AIが回答を作る際に社内の規程・提案書・商談記録などを検索して参照する仕組みです。回答を業務に使えるか判断するには、参照された文書が質問に合い、適用すべき版であり、利用者に閲覧権限があるかを確かめる必要があります。
RAG(検索拡張生成)は、AIが回答を作る際に社内の規程・提案書・商談記録などを検索して参照する仕組みです。回答を業務に使えるか判断するには、参照された文書が質問に合い、適用すべき版であり、利用者に閲覧権限があるかを確かめる必要があります。
RAG(検索拡張生成)は、AIが回答を作る際に社内の規程・提案書・商談記録などを検索して参照する仕組みです。回答を業務に使えるか判断するには、参照された文書が質問に合い、適用すべき版であり、利用者に閲覧権限があるかを確かめる必要があります。
「自社の規程について質問しても一般論しか返ってこない」「資料が複数の場所にあり、どれが最新版かわからない」「担当者に聞かなければ経緯がわからない」。こうした課題があるとき、RAGは検討対象になります。ただし、検索対象の情報が整理されていなければ、回答だけを見て正しさを判断することはできません。
RAG(Retrieval-Augmented Generation:検索拡張生成)は、質問に関連する情報を検索し、その情報をAIへの入力に加えて回答を作る方法です。最初に決めたいのは製品ではなく、「誰の、どの質問に、どの文書を根拠として答えるか」です。
StartLinkは、RAGの導入を「他社の構成をなぞること」ではなく、「自社の条件で選び、小さく始めて広げること」と捉えています。本記事では、対象の選び方、データ整備、試行から運用までを、次へ進む条件とともに整理します。AI時代のナレッジマネジメントの全体像については「AI時代のナレッジマネジメント」で詳しく解説しています。
本記事は暗黙知の形式知化カテゴリに属しています。経営管理全体を体系的に学びたい方は経営管理完全ガイドをご覧ください。
社内文書をAIで活用したい経営層・DX推進担当者に向けて、RAGの対象を選ぶところから、回答を確認しながら利用範囲を広げるところまでを解説します。
読み進める際は、自社で繰り返し寄せられる質問を思い浮かべてください。その答えがどの文書にあり、誰が更新しているかを特定できれば、最初に試す業務テーマを選びやすくなります。
RAGは、質問に答えるための情報を検索し、AIに渡す方法です。検索結果と回答を分けて確認すると、文書の整備、検索方法、回答の作り方のどこを見直すべきか判断できます。
RAGの処理は、検索・拡張・生成の順に捉えられます。
検索には、質問や文書をベクトルに変換して意味の近さを比べる方法があります。文書の探し方は構成によって異なるため、自社の想定質問を使い、必要な文書と箇所が検索結果に現れるかを確かめてください。
回答がずれている場合は、生成された文章だけでなく、検索された文書を先に見ます。旧版が返ってきたなら文書の管理と更新を、関係のない箇所が返ってきたなら分割方法や検索条件を見直します。正しい箇所が返っているのに回答がずれる場合は、質問の条件が回答へ反映されているかを確認します。
社内情報の活用を考える際は、変えたいものを先に決めます。参照する知識を文書の更新に合わせて扱いたいのか、回答の文体や形式を調整したいのかで、検討する方法が変わります。
| 比較項目 | RAG | ファインチューニング |
|---|---|---|
| データ更新 | 文書の更新を反映しやすい | 再学習が必要 |
| コスト | 追加学習が不要で、費用を抑えやすい | 学習の費用がかかりやすい |
| 回答の根拠 | 参照元文書を提示できる | 根拠を示しにくい |
| ハルシネーション制御 | 参照情報で制限しやすい | 制御しにくい |
規程や提案内容など、参照する知識を文書の更新に合わせて変えたい場合は、RAGから検討します。回答の文体や形式を揃えたい場合は、まず指示文で目的を満たせるかを確かめ、それでも足りない点を特定して別の方法を検討します。
表のコスト欄は選定結果を保証するものではありません。RAGでも文書の整備、検索基盤の運用、評価、権限管理が必要です。比較するときは、対象の質問で回答を確かめるとともに、文書が更新された後の作業と担当者まで並べて確認します。
社内文書を渡していないAIは、自社の規程の最新版や、個別の商談経緯を参照できません。利用者が毎回資料を探して入力する方法では、渡す文書の選択や権限の確認も利用者に委ねられます。
RAGを検討する分かれ目は、同じ情報を複数の人が繰り返し探しているかどうかです。該当するなら、質問、回答に使う文書、利用者を対応づけて試行します。答えが文書になっていないなら、検索の仕組みを作る前に記録を整えます。
RAGに取り込む前に、文書の正本、更新担当、公開範囲を確かめます。この確認ができない情報は、検索結果に出す条件も決められません。
社内ナレッジが、部門ごとのスプレッドシート、ファイルサーバー、チャットのスレッドに分かれている場合があります。置き場所が複数でも、正本と更新手順が決まっていれば管理できます。問題になるのは、旧版と新版の区別や、どちらを業務判断に使うかが曖昧な状態です。
対象の質問を選んだら、回答に使う文書がどこにあり、同じ内容の別版がないかを確認します。旧版を保存する必要がある場合も、通常の回答には使わないという扱いを決めてから取り込みます。
StartLinkは、情報の種類ごとに正となる置き場所を決めることをおすすめしています。規程やマニュアルは管理する文書を、顧客や商談の情報は記録するCRMを特定し、更新時に検索対象へどう反映するかを決めます。
ここでいう一元管理は、あらゆる情報を一つの製品へ移すことではありません。質問に対してどの記録を正として参照するかを明確にすることです。CRMでは、会社・取引・チケットなどの関連づけも確認します。関連づけが不足している場合は、検索範囲を広げる前に、必要な文脈を追える状態にします。
最初に扱う情報について、次の項目を確かめます。
| 確かめる項目 | 状態 | 次に取る行動 |
|---|---|---|
| 正となる置き場所が決まっているか | 決まっている | その置き場所をRAGのデータソース候補にする |
| 正となる置き場所が決まっているか | 複数に分かれている | 先に置き場所を1つに統合し、旧データの扱いを決める |
| 更新の担当者が決まっているか | 決まっていない | 文書ごとに更新担当を決め、メタデータに記録する |
| 機密区分が分かれているか | 混在している | 公開範囲ごとに文書を分けてから取り込む |
複数の場所にある情報は、まず回答の根拠に使う正本を決めます。旧データの扱い、更新担当、公開範囲まで説明できれば、その情報を棚卸しの対象にできます。説明できない項目が残る場合は、検索対象へ加える前に管理担当と決めてください。
データ整備は、質問から対象を選び、文書を整え、検索しやすい単位に分け、更新を反映する順に進めます。各段階で想定質問を使い、次へ進む前に参照する文書とその状態を確認します。
| フェーズ | 主な作業 | 次へ進む目安 |
|---|---|---|
| 1. 棚卸し | 取り込む文書の選定と優先順位付け | 最初に扱う業務テーマと対象文書の一覧ができている |
| 2. クレンジング | 古い情報の削除、重複統合、表記ゆれの統一 | 対象文書がすべて最新版で、版の重複がない |
| 3. チャンキングとメタデータ付与 | 文書の分割と属性情報の付与 | 想定質問で検索したとき、回答に必要な文脈がまとまって返ってくる |
| 4. ベクトル化とインデックス構築 | Embeddingモデルとベクトルデータベースの選定・格納 | 文書の更新がインデックスに反映される手順が決まっている |
文書一覧を広く作る前に、社内で繰り返し寄せられる質問を集めます。問い合わせを受ける部門に、質問と、その回答を確認するときに使う文書を挙げてもらいます。質問を記録する際は、誰が尋ねるか、回答にどの条件が必要かも残します。
次に、各文書の正本、更新担当、公開範囲を確認します。質問に答える文書を挙げられないテーマは、取り込みからいったん外し、文書化の担当を決めます。文書を挙げられるテーマは、その質問を後の検索評価にも使います。
対象文書を読み、検索結果に出してよい状態へ整えます。
古い文書を業務上の記録として残す場合は、通常の検索対象から除外する条件を決めます。削除するか、履歴として保存するかは文書の管理担当と確認してください。文書管理の命名や配置を整理する際は「文書管理ルールの策定方法」も参照できます。
この段階を終える条件は、想定質問ごとに、回答へ使う文書の版を特定できることです。判断できない文書があれば、分割や取り込みを進める前に正本を確定します。
文書を検索に使う単位へ分けます。区切り方は一律の文字数で決めず、見出しや手順のまとまりに沿って試します。
棚卸しで集めた質問を検索し、返った断片を読みます。回答の条件と結論が別々に切れているなら、まとめる単位を見直します。質問と無関係な内容が多く含まれるなら、区切る位置を見直します。調整後に同じ質問で検索し、必要な文脈が一緒に返るかを確認します。
各断片には、検索と管理に必要な文書種別、更新状態、公開範囲などのメタデータを付けます。項目を増やす前に、検索の絞り込み、旧版の除外、権限管理のどれに使うかを決めてください。用途が定まった項目から付け、想定質問の検索結果がどう変わるかを確かめます。
分割した文書を検索できるように格納します。Embeddingモデルを比較する場合は、提供元の仕様を確認したうえで、自社の日本語文書と想定質問を使って検索結果を比べます。モデル名や設定だけで判断せず、必要な文書が返るかを確認します。仕様を調べる際の参照先には、Vector embeddings - OpenAI APIがあります。
ベクトルデータベースにはPinecone、Qdrant、pgvector、Azure AI Searchなどの選択肢があります。既存の運用体制、権限管理の方法、文書更新時の作業を同じ項目で並べて比較してください。pgvectorの機能を確認する際は、提供元のpgvector(GitHub)を参照できます。
格納できたら、文書を更新して再取り込みし、検索結果が新版へ切り替わるかを確かめます。旧版が残る場合は、その文書を使った回答の利用を広げず、更新と除外の手順を直します。更新担当と確認方法が決まって初めて、試行で使う準備が整います。
最初から全社の文書を対象にすると、回答がずれたときに原因を追いにくくなります。業務テーマを絞り、質問と参照文書を対応づけてから、利用者と対象を広げます。
最初の対象には、繰り返し質問され、答えが文書にあり、その更新担当が決まっている業務テーマを選びます。社内規程や情報システムのFAQを検討する場合も、名称だけで決めず、実際の質問と回答箇所を対応づけてください。
答えが担当者の経験の中にしかないテーマでは、先にヒアリングと記録が必要です。判断の分かれ目は、想定質問ごとに根拠となる文書を示せるかどうかです。示せるなら試行へ進み、示せないなら文書化を進めます。
試行、部門展開、全社展開では、確認する対象が変わります。
| 段階 | 対象 | 次の段階へ進む条件 |
|---|---|---|
| 試行 | 1つの業務テーマと一部の利用者 | 想定質問に対して、参照元文書つきの回答が返ってくる |
| 部門展開 | 対象テーマを使う部門全体 | 利用者のフィードバックを集め、回答できなかった質問の原因を文書側で直す流れが回っている |
| 全社展開 | 複数テーマ・複数部門 | 文書の更新がインデックスに反映される手順と、権限ごとの検索範囲が決まっている |
試行では、棚卸しで集めた質問に対し、参照元が質問に合うか、適用すべき版か、利用者に閲覧権限があるかを担当者が確認します。回答できなかった質問は、文書が存在しないのか、検索で見つからないのか、検索された後の回答がずれたのかに分けます。
必要な文書がない場合は作成を依頼します。旧版が返る場合は更新手順へ戻ります。適切な文書が返るようになり、問題が起きたときの修正担当も決まったら、対象部門への展開を検討します。利用者を広げる際は、新たな利用者の権限でも同じ確認を行います。
試行したテーマで更新と確認の流れが回るようになったら、関連する質問へ対象を広げます。新しいテーマを加えるたびに、正本、更新担当、公開範囲を確認し、想定質問で検索結果を評価します。
文書が存在しないテーマに行き当たったら、RAGへ取り込む範囲を広げる前に、業務の経緯や判断基準を記録します。暗黙知を文書にする進め方は「暗黙知を形式知に変換する方法」で解説しています。
公開されている取り組みを参考にするときは、まず次の4点を同じ項目で整理します。
自社で答えられない項目が見つかれば、製品構成を比べる前に、その運用を決める材料になります。
パナソニック コネクトの「ConnectAI」、ベネッセの社内ナレッジ活用、デロイト トーマツのナレッジマネジメントを調べる場合も、各社について公開資料で確認できる対象と、資料からは判断できない運用を分けて記録します。確認できない文書の種類や導入効果を、自社の計画の前提には置かないでください。
自社に置き換える際は、繰り返し参照される情報、その利用者と公開範囲、更新担当と回答の確認方法の順に決めます。これらが揃えば、試行する質問と文書を定められます。揃わない場合は、不明な項目の担当者を特定するところへ戻ります。
営業やカスタマーサクセスでRAGを検討する場合、CRMにある商談記録や対応履歴も検索対象になり得ます。ただし、顧客情報には公開範囲があり、記録の欠落や関連づけの不足も起こり得ます。先に答えたい質問を決め、その回答に必要な記録が揃っているかを確認します。
過去の提案や商談の経緯を探したい場合は、最初に「似た案件」をどう判断するかを決めます。業種、課題、提案内容など、比較に使う項目が記録されているかを確認し、見つかった案件の記録を担当者が読んで、参考にできる範囲を判断します。
HubSpotのCRMデータを使う場合も、会社・取引・活動の関連づけと、参照できる利用者の範囲を確認します。関連づけが曖昧なまま横断検索すると、別の案件の経緯を同じ顧客のものとして読み取るおそれがあります。まずは担当者が根拠を追える記録に対象を絞ります。
失注の記録を活用する場合は、理由のカテゴリと経緯の記述を分けて確認します。カテゴリで傾向を見ても、個別案件の判断には当時の条件が必要です。再提案を検討するときは、AIに過去の経緯を探させた後、担当者が記録と現在の状況を照らし合わせます。
失注理由をカテゴリ別に確認する際は、下のドーナツチャートで内訳を見てください。図の分類と、個別の取引に残る記録を照合すると、どの理由について経緯を詳しく確認すべきかを決められます。
次の画像をご覧ください。
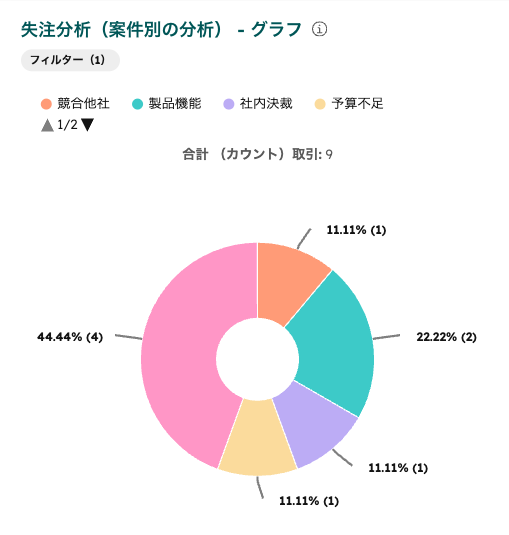
集計は質問を絞るための手がかりです。RAGの回答を判断に使う際は、集計だけでなく参照された取引記録も確認します。
顧客対応では、過去の問い合わせと対応記録から、類似する事例を探す使い方を検討できます。回答の下書きが返ったら、契約内容や現在の状況に合うかを担当者が確認し、顧客へ伝える内容を決めます。ヘルプデスクでの記録の整え方は「ヘルプデスクのナレッジ活用ガイド」も参照してください。
取り込み前には、チケットが適切な会社や取引と関連づいているかを確かめます。記録が別の場所にある場合は、どの情報を正として参照するかを決めます。契約や顧客対応に関する記録は閲覧範囲も確認し、権限を定められないものは試行対象から外します。
RAGで使いたい情報がCRMに残っていなければ、検索では補えません。まず、想定質問への回答に必要な項目を挙げ、どの業務の場面で誰が入力するかを決めます。
例えば、失注理由を使うなら、取引のステージを変える際に理由を記録する運用を検討します。提案の経緯を使うなら、提案内容の要約を残す場面を決めます。入力項目を増やす前に、その項目がレポートや想定質問で実際に使われるかを確かめてください。
試行では、記録が空欄の案件や、カテゴリだけでは経緯を判断できない案件を確認します。必要な情報が残る入力方法へ直してから、検索対象を広げます。
RAGの回答をどこまで利用するかは、業務ごとに決めます。参照箇所を探すことと、顧客や社内に対して判断を示すことでは、必要な確認が異なります。
業務を分ける際は、回答が誤っていた場合の影響と、意思決定を伴うかを確認します。
| AIに任せやすい業務 | 人間が判断すべき業務 |
|---|---|
| 社内規程・手順の該当箇所の検索と要約 | 規程の解釈が分かれるケースの最終判断 |
| 過去の類似案件・類似対応の抽出 | 大型案件や重要顧客へのアプローチ方針 |
| 商談記録や対応履歴の要約 | 顧客に送る文面の最終確認と送信 |
| 失注理由の傾向の整理 | 失注傾向を踏まえた戦略・製品方針の決定 |
| 回答の下書き作成 | RAGに取り込む文書の選定と公開範囲の決定 |
試行では、検索や下書きの作成を任せ、担当者が参照元を読んで仕上げる運用から始めます。確認中に起きた問題を質問と参照元にひもづけて記録すれば、文書、検索、回答のどこを直すか判断できます。
まず、参照元が示されているかを確認します。示されていなければ、根拠を確認できるまで業務判断に使いません。次に、文書の版、適用範囲、閲覧権限を見ます。参照元が適切でも、回答が質問の条件を取り違えていないかを読みます。
顧客へ伝える内容や規程の解釈は、担当者が原文と現在の条件を確認して決めます。この順序を利用ガイドに記載し、判断に迷う場合の確認先も決めておきます。
記録されていない判断の経緯は、RAGで検索できません。また、文書が見つかっても、個別の顧客にその内容を適用してよいかは別の判断です。
想定質問の答えが文書にない場合は、担当者へ確認します。同じ質問が繰り返されるなら、その確認結果を文書化できるかを検討します。文書化する際は、適用される条件と更新担当も一緒に記録してから検索対象へ加えます。
試行後も、文書の公開範囲、回答のずれ、文書更新への対応を続ける必要があります。それぞれに担当と確認の手順を設けます。
取り込み前に、文書の公開範囲と個人情報の扱いを決めます。全社、部門、役職などの区分を設ける場合は、文書と分割後の各断片に同じ公開範囲が適用されるか確認します。
次に、権限の異なる利用者で同じ質問を試し、閲覧できない文書が検索結果や回答に含まれないかを確認します。区分を決められない文書は、担当者が判断するまで対象から外します。運用開始後も権限の変更時に検索範囲を見直せるよう、変更担当を決めておきます。
利用者から役に立たなかった質問を集めたら、まず参照元を確認します。
修正後は、問題が起きた質問を再度使い、参照元と回答を確認します。同じ種類の問題が続く場合は、そのテーマの対象拡大を止め、原因となる段階へ戻ります。
正本を更新しても、検索結果が旧版のままなら回答に使えません。文書が改定されたときに、誰が再取り込みを行い、誰が結果を確かめるかを決めます。
確認には、改定した箇所について質問し、新版が参照され、旧版が通常の結果に出ないことを確かめる方法があります。自動で更新する場合も、この確認は必要です。更新が反映されていなければ、その文書を使う回答を業務に適用せず、取り込みの手順を見直します。
再取り込みのタイミングは、古い内容が使われた場合の影響を基準に決めます。影響の大きい規程や顧客対応の手順から優先し、更新から確認までの流れが回ることを確かめてから対象を広げます。
質問に関連する社内文書を検索し、その内容を参照してAIが回答を作ることです。業務で使う前には、参照元の版、質問への適合、利用者の閲覧権限を確認します。答えが文書にない場合は、担当者への確認や文書化が必要です。
繰り返し寄せられる質問から業務テーマを選び、回答に使う文書を棚卸しします。正本と公開範囲を決めて文書を整え、分割とメタデータ付与、検索できる状態への格納を進めます。試行では参照元と回答を確認し、文書更新時にも結果を直せる状態になってから利用範囲を広げます。
回答とともに、参照された文書を見てください。正しい文書が返っているなら回答の作り方を、返っていないなら検索対象や分割方法を確認します。答えの文書がないなら作成を担当部門に依頼します。旧版や重複した文書が返る場合は、正本と取り込み状態を直してから同じ質問で再確認します。
商談や顧客対応の記録を、似た案件を探す手がかりにできます。利用するには、記録が適切な会社や取引に関連づき、比較に必要な項目と経緯が残っていることが前提です。検索結果を提案や対応へ使う際は、担当者が元の記録と現在の顧客の条件を確認します。
RAGの最初の対象は、繰り返し質問され、答えとなる文書があり、更新担当と公開範囲を決められるテーマから選びます。検索結果に参照元を示せるだけでなく、その文書が質問に合い、業務で使う版かを確認できる状態を目指してください。
押さえておきたいポイントは以下のとおりです。
企業様によって最適な形は異なります。まずは次の順で、自社の最初の対象を決めてください。
CRMを活用した業務効率化やAIとの連携については、StartLinkにご相談ください。CRMの記録をどの質問に使いたいか、現在の入力や権限の状態、文書更新の担当を整理するところから検討できます。CRMデータの整備からAI活用基盤までを検討する際は、Sync AI-OSも選択肢の一つとしてご確認ください。
RAGの対象文書を整える方法や、記録されていない知識を文書にする方法をさらに確認したい方は、次の記事もご覧ください。
経営管理の理解をさらに深めるために、属人化を解消する具体的な方法もあわせてご覧ください。また、営業ナレッジの共有方法では、商談の経緯をチームで参照できるようにする考え方を確認できます。
関連する製品情報として、Sync for NotionとHubSpotマーケットプレイスからインストールの案内も参照できます。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。