この記事の結論
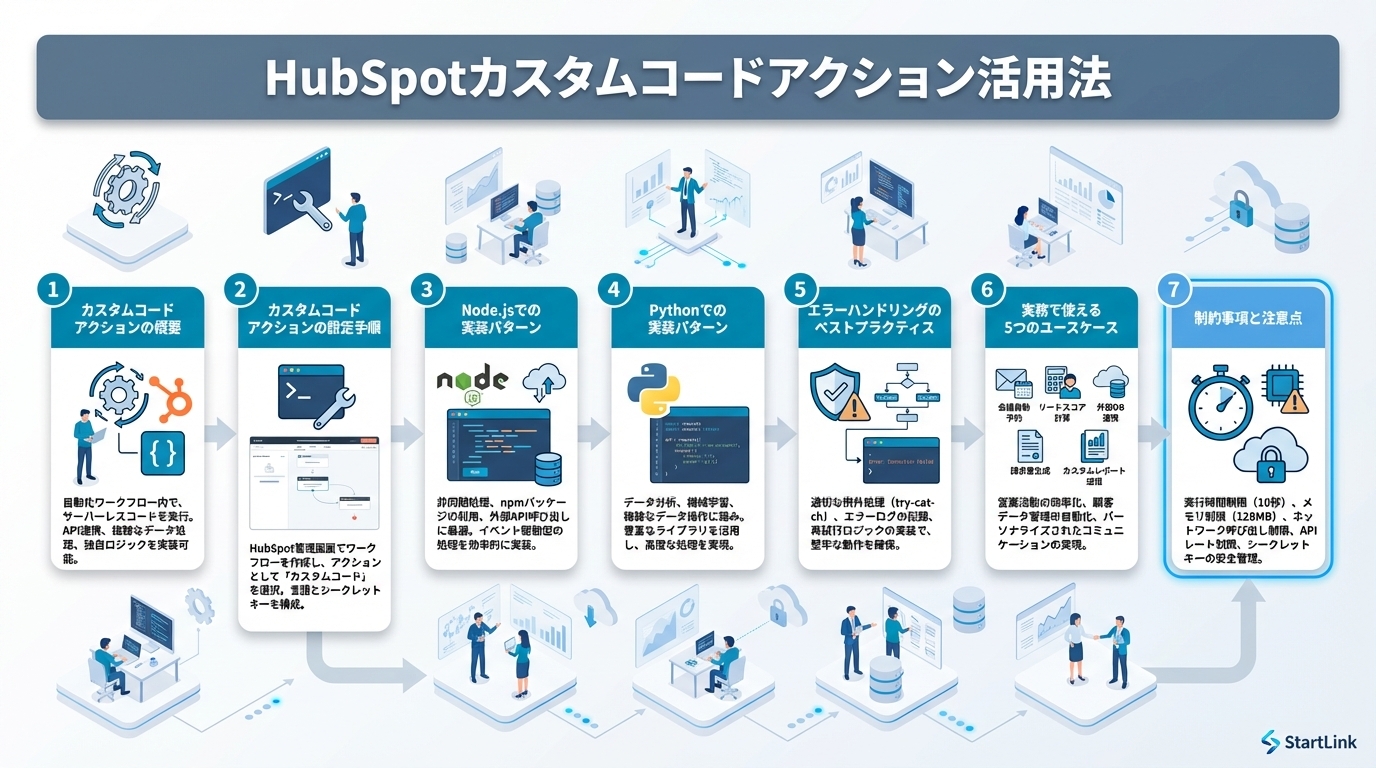
HubSpotのカスタムコードアクションは、標準ワークフローでは表しにくい処理をNode.jsまたはPythonで実行する機能です。外部サービスから得た情報や計算結果を、後続の業務判断に渡せます。利用にはData HubのProfessionalまたはEnterpriseが必要で、1回の実行は20秒以内・メモリ128 MB以内に収めます。
HubSpotのカスタムコードアクションは、標準ワークフローでは表しにくい処理をNode.jsまたはPythonで実行する機能です。外部サービスから得た情報や計算結果を、後続の業務判断に渡せます。利用にはData HubのProfessionalまたはEnterpriseが必要で、1回の実行は20秒以内・メモリ128 MB以内に収めます。
HubSpotのカスタムコードアクションは、標準ワークフローでは表しにくい処理をNode.jsまたはPythonで実行する機能です。外部サービスから得た情報や計算結果を、後続の業務判断に渡せます。利用にはData HubのProfessionalまたはEnterpriseが必要で、1回の実行は20秒以内・メモリ128 MB以内に収めます。
表計算シートとHubSpotを別々に更新して情報に差が生じたり、外部サービスへの転記を手作業で続けたりする場合があります。標準アクションでは必要な判定を表現しにくい場合もあります。こうした課題があるときは、コードを書く前に、どの処理が不足しているかを切り分けます。
この記事では、カスタムコードを使う判断から、入力・出力の設計、テスト、失敗時の運用までを業務の流れに沿って説明します。処理を選ぶ場面では、標準アクションで対応できる範囲、コードに渡す値、結果を受け取る担当者の順に確認してください。
カスタムコードを採用する前に確認する条件と、採用後に担当者が処理を追える形で運用する手順がわかります。外部情報を取得してCRMへ反映する場合を例に、どこまでをコードで処理し、どこからを後続のアクションに任せるかも判断できます。
最初に、実現したい処理を「取得する情報」「行う判断」「更新する先」に分けます。プロパティ更新や通知などを標準アクションで設定できるなら、その部分はワークフロー上に残します。外部データの取得や独自の計算など、標準アクションで表せない部分が明確になったら、カスタムコードを検討します。
判断に迷う場合は、現在の手作業を具体的に書き出します。担当者がどの値を見て、何と比較し、どのレコードを更新しているかを追うと、コードが担う処理と、人が確認すべき判断を分けやすくなります。
次の表を入口に、実際のアカウントで使えるアクションと処理要件を照合します。「カスタムコードが適している」という行でも、入力元、出力先、保守担当を決められない場合は実装を始めず、業務ルールを整理します。
| 処理内容 | 標準アクション | カスタムコード |
|---|---|---|
| プロパティ値の更新 | 適しています | 標準で不足するときに検討します |
| メール送信 | 適しています | 原則として不要です |
| 単純な条件分岐 | 適しています | 条件が複雑な場合に検討します |
| 外部API呼び出し | 対応できない場合があります | 適しています |
| 複雑なデータ変換・計算 | 対応できない場合があります | 適しています |
| 独自の入力検証 | 限定的です | 適しています |
| 複数レコードの一括処理 | 不可 | 必須 |
例えば外部サービスから会社情報を取得するなら、コードの役割は取得と必要な値の整形までに絞れます。その値をCRMへ反映する処理は後続の標準アクションに置くと、担当者が更新条件をワークフロー上で確認できます。
この構成を選ぶ前に、取得した会社名が既存の会社名と異なる場合を考えます。外部情報を優先すると決めていないなら、コードは差異を示す状態を返し、更新は担当者の確認後に進めます。更新の判断まで決まって初めて、後続アクションの条件を設定できます。
コンタクト情報の取得、取引の管理、顧客対応、請求に向けた情報の引き渡しは、それぞれ判断する担当者と必要な項目が異なります。コードの出力を次の処理につなぐ前に、「誰が値を使うか」「その値で何を決めるか」「値が得られなかったら誰が確認するか」を定めます。
フォーム入力を分類して担当者に通知する場合と、取引情報を後続の請求処理に渡す場合では、誤った値の影響も異なります。後者では、連携先に渡す項目だけでなく、HubSpotと連携先のどちらで値を確定するかも先に決めます。確定元が決まらなければ自動更新へ進まず、値の管理者と確認手順を定めます。
企業様によって最適な形は異なります。同じ外部API連携でも、入力に使える項目、確認する担当者、更新するタイミングは業務によって変わります。
まず対象の処理を一つ選び、入力がそろう条件、成功と判断する条件、失敗時の確認先を記します。その条件をテストで確認できた場合に、対象レコードやワークフローを広げます。入力項目を増やす必要が出たら、既存のプロパティで表せるか、誰がその値を管理するかを改めて確認します。
広げる前には、試験で使ったレコードと次に対象とするレコードの違いも確認します。関連会社が複数ある、必須値が空欄になるなど、前提が変わる場合は、その状態の処理方法を決めてから適用範囲を増やします。
コードを書く前に、対象アカウントでカスタムコードを選択できるか、使いたい言語を選べるか、処理が実行条件に収まるかを確認します。どれかが合わなければ、処理を小さく分けるか、標準アクションを含めて構成を見直します。
対象アカウントのプランとアクション画面を確認し、利用できる言語、必要なライブラリ、シークレットと出力項目の設定方法を照合します。HubSpotの公式資料では、カスタムコードアクションは20秒以内に実行を終え、使用メモリを128 MB以内に収める必要があると示されています。これらは設計時の上限として扱い、実際の処理時間とメモリ使用量をテスト結果で確認してください(出典:Use custom code actions in workflows)。
公式ドキュメントに記載された主な条件は、次のとおりです。契約前や設計前に、自社のアカウントと照らし合わせます(出典:Use custom code actions in workflows)。
| 項目 | 公式ドキュメントの記載 | 設計への影響 |
|---|---|---|
| 必要なプラン | Data HubのProfessionalまたはEnterprise(Pythonはベータと記載) | Pythonを本番で使う場合は、提供状況を公式で再確認する |
| 実行時間・メモリ | 20秒以内・128 MBまで。超えるとエラー | 外部APIを何度も呼ぶ構成は分割する |
| 入力プロパティ | 1アクションにつき最大50個 | 必要な入力に絞る |
| シークレット | 複数使う場合は値の合計が1,000文字以内。コードから環境変数として参照 | トークンを増やしすぎない |
| 出力 | 型を選んで登録。文字列は65,000文字まで。日付・日時への更新はUNIXミリ秒 | 長文の応答をそのまま返さない |
以下の画面は、HubSpotワークフロー(カスタムコードアクション)の一覧画面です。対象のワークフローを開いた後、アクションの設定画面で利用できる項目を確認します。
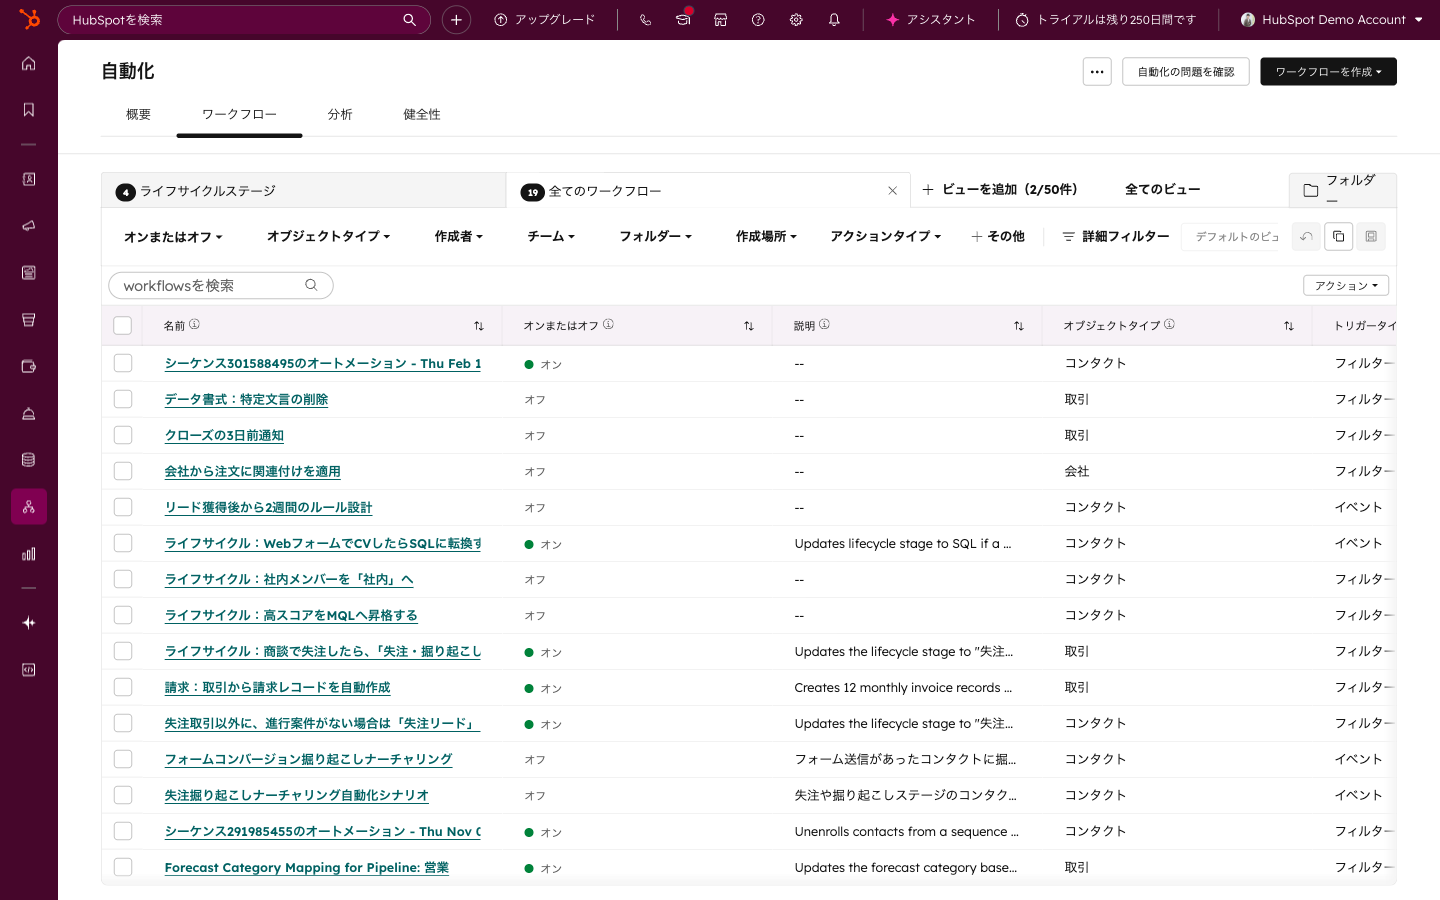
表の各項目を確認し、合わない行があれば実装方法を決め直します。特に外部サービスの応答を待つ処理は、通常時だけでなく応答がない場合も含めてテストします。
| 確認項目 | 要件に合う場合 | 合わない場合 |
|---|---|---|
| 利用プラン | 対象のプラン条件を満たす | 標準アクションや別の連携方法を検討します |
| 実行時間 | 1回の実行内で処理できる | 処理を分割するか、非同期の方式を検討します |
| 外部サービスの応答 | 制限時間内に結果を返せる | 呼び出し回数や対象データを見直します |
| 出力項目 | 後続処理に必要な値を渡せる | 項目を絞るか、別のデータ保存先を検討します |
照合は「想定する処理を列挙する」「試験用レコードで実行する」「結果と実行ログを見て構成を決める」の順に行います。外部サービスへの呼び出しが続く構成なら、必要な情報だけを取得した場合と、取得対象を広げた場合を比べます。後者で実行条件に近づくなら、取得項目を絞るか、処理を分けてから再度試します。
出力項目については、コードが返せるかだけで判断しません。後続アクションがその値を受け取り、意図した型のプロパティへ渡せることまで確認します。値を返せても更新先が決まっていない場合は、出力を増やす前に利用目的を整理します。
単純な更新や分岐をコードへ移すと、担当者が処理の意図をワークフロー画面だけで追いにくくなります。標準アクションで表せる更新条件は設定として残し、コードは必要な値を返す役割に絞ります。
カスタムコードを採用する条件は、標準アクションでは不足する処理が具体的に説明でき、入出力を定義でき、テストと変更を担当する人を決められることです。いずれかが曖昧なら、実装より先に業務上の判断を整理します。例えば「優先度を計算したい」という要望だけでは、比較に使う値と優先度を変える条件が未確定です。営業担当者が実際に使う判断基準を確認してから、コードに渡す入力を決めます。
設定画面を開く前に、対象レコードから後続アクションまでの流れを書き出します。入力元と出力先が決まると、コードに渡す項目を選びやすくなります。あわせて、成功、入力不足、外部サービスの失敗それぞれで、後続アクションを進めるか止めるかを決めます。
ワークフローエディタで対象の処理位置にアクションを追加し、カスタムコードを選択します。Node.jsとPythonのうち、対象アカウントで利用でき、チームがテストと修正を引き継げる言語を選びます。
外部APIを呼ぶ処理でも、数値を計算する処理でも、言語だけで採用を決めません。次の点を確認し、試験用のレコードで入出力を検証できる状態に進めます。
どちらの言語でも、担当者が失敗時の状態と後続の分岐を確認できることを採用条件にします。設定の流れは、公式ドキュメントでは次のとおりです。
コードが参照するプロパティを選び、コード内で使う名前を対応付けます。例えば情報補完なら検索に使う値、優先度判定なら判定の根拠となる値が必要です。
入力ごとに、次を決めます。
空欄でも処理を続ける設計なら既定値の意味を説明できるようにし、説明できない場合は確認用のステータスを返します。
同じ名前の値でも、対象レコードや更新時点が違えば意味が変わります。取引金額を使うなら、どの取引を対象とし、いつの値で判定するかを確認します。値の管理元が曖昧なままコードに渡すと、計算が成功しても業務上の判断には使えません。
外部APIの認証情報はコードに直接書かず、アクションで利用するシークレットとして登録します。ログ、出力変数、通知文にも認証情報を含めません。
出力は「処理で得た値」と「処理の状態」を分けます。例えば会社名を取得する処理では、会社名と成功・入力不足・取得失敗の状態を返します。
後続アクションは状態を先に確認し、成功した場合だけプロパティを更新します。
出力名と型を決めたら、コードで返す値と設定画面に登録した出力が一致するか照合します。成功時の値が空欄でも更新を進めてよいのか、既存値を残すのかも決めてください。ここが未決定なら、成功という状態だけを根拠に更新する構成には進めません。
試験用のレコードで、次の場合を確かめます。
テスト画面で値が返っただけでは完了とせず、定義した出力項目と型が一致し、後続の分岐が意図どおり動くかを確認します。
カスタムコードアクションのテストでは入力と出力を確認し、後続アクションの分岐や更新結果は試験用レコードの実行履歴で別途確かめます。コード内で外部サービスの呼び出しやCRM更新を行う場合は、テストでもコードが実行されるため、試験用レコードを選び、送信先と更新内容を確認してから実行します(出典:Use custom code actions in workflows)。
テスト結果は、入力、出力、状態、後続で期待する動きを並べて確認します。期待と違う場合は、次の順に調べると、修正する場所を絞れます。
次のコードは入出力と失敗時の分岐を示す例です。プロパティ名、外部APIの認証方法、応答形式は利用する環境に合わせて確認し、設定画面の出力項目にも同じ名前と型を登録します。各例を使う前に、対象レコードと結果を利用する担当者を決めてください。
メールアドレスを検索条件として外部サービスから情報を得る構成です。APIの接続先と認証情報は設定から渡し、応答内の項目名は契約中のサービスの仕様に合わせて変更します。入力がない場合は呼び出さず、後続の確認処理へ渡します。
const axios = require('axios');

exports.main = async (event, callback) => {
  const email = event.inputFields['email'];

  if (!email) {
    return callback({
      outputFields: {
        enriched_company: '',
        enriched_title: '',
        enrichment_status: 'missing_input'
      }
    });
  }

  try {
    const response = await axios.get(process.env.ENRICHMENT_API_URL, {
      params: { email },
      headers: {
        Authorization: `Bearer ${process.env.ENRICHMENT_API_KEY}`
      }
    });

    callback({
      outputFields: {
        enriched_company: response.data.company?.name || '',
        enriched_title: response.data.title || '',
        enrichment_status: 'success'
      }
    });
  } catch (error) {
    callback({
      outputFields: {
        enriched_company: '',
        enriched_title: '',
        enrichment_status: 'lookup_failed'
      }
    });
  }
};
この例では取得失敗を確認用ステータスとして返すため、失敗の種類を後続処理へ渡していません。運用時は、次の点を先に決めます。
失敗時に再試行したい処理なら、外部サービスのエラーの種類を確認し、再試行する条件を別途定めます。
失敗をすべて同じ状態として扱うと、認証設定の修正が必要な場合と、一時的な応答不良を区別できません。
優先度の配点や金額の境界をコード内で決め打ちせず、営業側で承認した基準を入力として渡します。次の例は、取引金額と設定済みの比較基準から優先度を返す形です。判断基準を変更するときは、基準を管理する担当者と変更日を記録します。
exports.main = async (event, callback) => {
  const amount = Number(event.inputFields['amount']);
  const threshold = Number(event.inputFields['priority_threshold']);

  if (
    !Number.isFinite(amount) ||
    !Number.isFinite(threshold) ||
    threshold < 0
  ) {
    return callback({
      outputFields: {
        deal_priority: '',
        priority_status: 'check_input'
      }
    });
  }

  callback({
    outputFields: {
      deal_priority: amount >= threshold ? 'review_first' : 'standard',
      priority_status: 'success'
    }
  });
};
この優先度は営業判断の代わりにはなりません。後続の通知や確認順に使う場合は、比較基準が実際の取引判断と合っているかを担当者が実行履歴と照らし、合わなくなった時点で基準を見直します。
比較するときは、優先して確認すべきと担当者が判断した取引が、コードでも同じ区分になるかを試験用レコードで確かめます。食い違う場合は境界値だけを変える前に、次の点を確認します。
関連会社の情報を使う場合は、まず対象となる会社をどう特定するかを決めます。会社が複数関連付けられる運用なら、どの会社を採用するかのルールが必要です。会社IDを取得できた後は、そのIDで必要なプロパティを読み取れます。
const hubspot = require('@hubspot/api-client');

exports.main = async (event, callback) => {
  const companyId = event.inputFields['associated_company_id'];

  if (!companyId) {
    return callback({
      outputFields: {
        company_industry: '',
        company_size: '',
        company_lookup_status: 'no_company_selected'
      }
    });
  }

  const client = new hubspot.Client({
    accessToken: process.env.HUBSPOT_TOKEN
  });

  try {
    const company = await client.crm.companies.basicApi.getById(
      companyId,
      ['industry', 'numberofemployees']
    );

    callback({
      outputFields: {
        company_industry: company.properties.industry || '',
        company_size: company.properties.numberofemployees || '',
        company_lookup_status: 'success'
      }
    });
  } catch (error) {
    callback({
      outputFields: {
        company_industry: '',
        company_size: '',
        company_lookup_status: 'lookup_failed'
      }
    });
  }
};
この例は、対象会社のIDが前の処理で確定していることを前提にしています。IDを渡せない場合は、次を先に設計します。
会社がない状態と取得失敗を分けておくと、担当者が次に確認する内容を決められます。
会社の情報が取得できても、業種や従業員数が空欄の場合があります。後続でその値を使うなら、空欄を許容するのか、会社レコードの確認へ回すのかを決めてから更新条件を設定します。
Pythonを使う場合も、計算式や通知先を決める前に、入力値の意味と欠損時の扱いを定めます。コードが正しく動いても、業務上の前提が異なれば出力は判断に使えません。
顧客価値を計算するなら、次の値が同じ対象と期間を表しているか確認します。
次の例は、それらの前提を確認済みの入力として受け取り、計算可能かどうかを状態とともに返します。区分の境界は、計算結果を使う部署が定めてから後続アクションで設定します。
def main(event):
    fields = event.get('inputFields', {})

    try:
        monthly_revenue = float(fields['monthly_revenue'])
        churn_rate = float(fields['churn_rate'])
        gross_margin = float(fields['gross_margin'])
    except (KeyError, TypeError, ValueError):
        return {
            "outputFields": {
                "calculated_ltv": "",
                "ltv_status": "check_input"
            }
        }

    if monthly_revenue < 0 or not 0 < churn_rate <= 1 or not 0 <= gross_margin <= 1:
        return {
            "outputFields": {
                "calculated_ltv": "",
                "ltv_status": "check_input"
            }
        }

    ltv = monthly_revenue * gross_margin / churn_rate

    return {
        "outputFields": {
            "calculated_ltv": str(ltv),
            "ltv_status": "success"
        }
    }
この式は入力値の定義に依存します。解約率の集計方法や売上の対象が変わった場合は、以前と同じ式を使い続けてよいかを確認します。値が計算できない場合に仮の在籍期間を入れるのではなく、入力を確認する状態として扱います。
計算結果を区分や通知に使う前には、部署が普段参照している値と同じ条件で算出されているかを照合します。条件が一致しなければ、結果の大小で顧客を分けず、入力の定義と計算目的をそろえるところへ戻ります。
通知処理では、誰が受け取り、どの行動を取るための通知かを先に決めます。次の例は、取引情報をWebhookへ渡し、送信できたかどうかを後続アクションに返します。通知先の仕様と、送ってよい項目は運用前に確認します。
import os
import json
from urllib.request import Request, urlopen
from urllib.error import URLError

def main(event):
    fields = event.get('inputFields', {})
    webhook_url = os.environ.get('SLACK_WEBHOOK_URL')

    if not webhook_url or not fields.get('dealname') or not fields.get('dealstage'):
        return {
            "outputFields": {
                "notification_status": "check_input"
            }
        }

    message = {
        "text": (
            f"取引ステージ変更通知\n"
            f"取引名: {fields['dealname']}\n"
            f"新ステージ: {fields['dealstage']}"
        )
    }

    try:
        request = Request(
            webhook_url,
            data=json.dumps(message).encode('utf-8'),
            headers={'Content-Type': 'application/json'}
        )
        with urlopen(request) as response:
            response.read()
        status = 'sent'
    except URLError:
        status = 'send_failed'

    return {
        "outputFields": {
            "notification_status": status
        }
    }
通知が失敗した場合は、実行履歴で対象の取引を特定し、担当者が再送の要否を判断できるようにします。再実行によって同じ通知が重複する可能性も含め、通知先での扱いを決めておきます。
送信結果だけで業務完了と判断せず、受信者が何を確認し、どの情報を更新するかまで定めます。
通知内容だけで対象の取引を見分けられない場合は、送ってよい情報の範囲内で識別方法を見直します。
失敗時の設計は、エラー名を並べるだけでは完了しません。それぞれについて「自動で再試行するか」「担当者が設定を直すか」「入力元に確認を戻すか」を決めます。後続アクションが更新を行う場合は、成功を示す状態が返ったときだけ進む条件を設定します。
次の表を基に、対象の外部サービスと業務に応じた確認担当を決めます。対応方針を変えた場合は、テスト条件と運用資料も合わせて更新します。
| エラー | 起きる場面 | 対応方針 |
|---|---|---|
| タイムアウト | 外部APIの応答が遅い | 呼び出し回数や取得項目を減らし、処理を分けます |
| 認証エラー | トークンや権限に問題がある | シークレットと権限を見直し、担当者に通知します |
| レート制限 | 短時間の呼び出しが集中する | リトライの条件を限定し、呼び出し頻度を抑えます |
| データ型エラー | 空値や想定外の値が渡る | 入力を検証し、既定値または確認用ステータスを返します |
| メモリ不足 | 処理対象が大きい | 対象を絞るか、処理を分割します |
| 429・5xxエラー | 外部サービスの一時的な不調 | エラーを投げると最大3日間自動で再試行される。重複登録を防ぐ確認を先に決めます |
実行履歴を調べる際は、まず失敗したレコードと入力を確認し、次に外部サービスの応答や権限を確認します。同じ種類の失敗が異なるレコードでも起きるなら、個別データより設定や処理条件を優先して調べます。特定の入力だけで起きるなら、その入力を再現できる試験用レコードで原因を切り分けます。
Node.jsではcallback、Pythonではreturnで出力を渡します。値と状態を別々に返し、後続アクションでは状態を先に判定します。「成功」なら値を更新し、「入力の確認が必要」なら入力元へ戻し、「取得失敗」なら実行履歴と外部サービスの状況を確認する、と行動につながる分岐にします。
再試行が必要な失敗を、すべて確認用ステータスに変換する設計も避けます。再試行を検討するのは、レート制限や外部サービスの一時的な応答不良など、時間を置けば処理できる可能性がある失敗です。認証設定や入力値の修正が必要な失敗は担当者の確認へ回し、試験用レコードで実行履歴と後続の動きを確かめます。
公式ドキュメントによると、Node.jsではcatchの中でエラーを投げ(throw)、Pythonではexceptの中でraiseすると再試行されます。レート制限のエラー、またはaxiosや@hubspot/api-clientが返す429・5xxエラーの場合は、失敗の1分後から最大3日間、間隔を延ばしながら(最長8時間おき)再試行されます。上のコード例は失敗を状態として返しているため、自動再試行は行われません。再試行したい失敗だけを投げる、と使い分けます。
呼び出しが集中する場合は、アクションの「Configure rate limit」で実行回数と時間枠を設定できます。制限中は後続のアクションも待つため、通知が遅れてよい処理かを確認してから設定します。実行結果は、ワークフローの詳細ページの「アクションログ」で確認でき、テスト時のログにはメモリ使用量と総実行時間も表示されます。
自動再試行を選ぶ前には、同じ処理が再度実行されても、連携先の登録や通知が重複しないかを確認します。重複を判別する方法がない処理は、再試行の条件だけでなく、連携先で処理済みかを確かめる手順を先に設計します。
ワークフローの説明や運用資料には、コードの目的、入力元、出力先、失敗時の担当者、判断基準の管理者を記録します。実行履歴を見た担当者が、入力の問題なのか、外部サービスの問題なのか、設定の問題なのかを追える状態が目標です。
変更時は、コードだけでなく後続の分岐と更新先も確認します。対象外のプロパティまで更新していないか、同じレコードを再処理したときに重複した通知や更新が起きないかを試験用レコードで確かめます。原因を切り分けにくい場合は、外部情報の取得、値の整形、CRM更新の役割を分けて見直します。
引き継ぎ時には、正常時の結果だけでなく、入力不足と外部サービスの失敗を再現した結果も残します。担当者がその結果から確認先を判断できなければ、状態名、実行履歴で見る項目、運用資料の説明をそろえてから対象を広げます。
ユースケースを選ぶ際は、できる処理の種類よりも、その結果を誰が使うかを優先します。各処理について次を決めてからワークフローへ組み込みます。
フォームから得た値で外部情報を検索し、会社名や業種などを補う構成です。検索に使う値が欠けている場合や、外部情報と既存のCRM情報が食い違う場合の扱いを決めます。食い違いを自動で上書きしない運用なら、確認用の状態を返して担当者へ渡します。
適用前には、外部情報が既存値より優先される条件を具体化します。どちらを採用するか決められない項目は自動更新から外し、担当者が根拠を確認できる流れにします。
標準設定では表しにくい条件を計算し、営業が確認する順序の参考にする構成です。先に営業側で判断基準を定義し、その基準を入力と出力に対応付けます。優先度と実際の対応順が合わない事例が出たら、配点や境界だけでなく、入力データの欠損も確認します。
見直すときは、営業が先に確認した案件と、コードが優先した案件を同じ判断基準で比べます。差が出た理由を次に分け、どこを変えるか決めます。
取引の作成やステージ変更を起点に、必要な項目を外部の基幹システムへ渡す構成です。HubSpotと連携先のどちらで値を確定するか、同じ取引を再処理した場合にどう扱うかを決めます。連携が失敗したときは、再送前に連携先へ既に反映されていないかを確認できる手順が必要です。
送る項目は、連携先が処理に必要とするものから選びます。値の確定元、送信条件、処理済みの確認方法がそろわない場合は、自動送信へ進む前に連携先の担当者と業務ルールを確認します。
取引の状態や顧客区分に応じて、通知する担当者と内容を変える構成です。受信者が次の行動を判断できる情報だけを含めます。通知が増えて見過ごされるようになったら、実行履歴と実際の対応を照らし、通知条件を見直します。
通知条件を変える際は、通知を受けた担当者が実際に対応したケースと、対応が不要だったケースを比べます。不要な通知に共通する条件が見つかれば、その条件を分岐に反映できるか検討します。
電話番号や住所などを検証し、想定外の値を確認用ステータスとして返す構成です。自動修正する場合は、正規化のルールと元の値を確認できる方法を決めます。例外が繰り返し発生するなら、コードで吸収し続ける前に入力画面や入力ルールを見直します。
修正後の値を使う担当者が、元の値との違いを判断できることも確認します。どちらが正しいかコードだけで決められない場合は、自動修正せず確認に回します。
StartLinkはHubSpotゴールドパートナーとして、150社以上のHubSpot支援に携わっています。カスタムコードは、次の順で小さく始めます。
表計算シートとHubSpotの更新の差を減らしたい場合は、まずHubSpotとGoogleスプレッドシートの連携の使い分けを確認し、それでも足りない処理にカスタムコードを使います。会計や契約の標準連携で足りない部分は、自社開発のSyncシリーズで補えます。HubSpot導入全体の進め方はHubSpot導入・構築支援で確認できます。企業様によって最適な形は異なります。
この節の要点
公式ドキュメントでは、Data HubのProfessionalまたはEnterpriseのアカウントが必要とされています(Pythonはベータと記載)。1回の実行は20秒以内、使用メモリは128 MBまでです。使いたい処理がこの条件に収まる場合に採用し、合わない場合は標準アクションや処理の分割を検討します。利用可否だけでなく、試験用レコードで必要な入出力を確認し、後続アクションへ渡せることも確かめます。
対象アカウントでの利用可否を確かめたうえで、必要なライブラリとチームの保守体制で選びます。外部APIとの接続や計算の内容を小さく試し、入力不足や失敗時の出力までテストできる言語を採用します。両方で実現できるなら、変更時に担当者が原因を調べ、修正を引き継げる方を選びます。
失敗を出力ステータスとして返す場合と、エラーを投げてアクションを失敗させる場合で扱いが変わります。公式ドキュメントでは、エラーを投げると再試行され、レート制限や429・5xxのエラーは失敗の1分後から最大3日間(最長8時間おき)再試行されるとされています。後続で確認や更新を行いたい失敗は状態を返して分岐させ、再試行が必要な失敗は対象となる条件を確認して設計します。どちらも試験用レコードで実行履歴と後続の動きを確認します。外部への登録や通知を伴う処理では、再実行前に重複の有無を確かめる方法も決めてください。
APIキーやトークンはコードに直接書かず、カスタムコードアクションで使うシークレットに登録します。コードから環境変数として参照し、ログ、出力項目、通知文に値を含めないようにします。認証エラーが起きた場合は、値をログへ出すのではなく、シークレットの設定と必要な権限を担当者が確認します。
カスタムコードアクションを使う前に、標準アクションで表せない処理を特定します。採用する場合は、コードが受け取る値、返す値と状態、後続アクションを進める条件、失敗時に確認する担当者を一続きで設計します。
実装は次の順で進めると、判断が曖昧なまま対象を広げずに済みます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。現在のワークフローで標準アクションが担える範囲と、カスタムコードが必要な処理を整理するところからご相談いただけます。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。