この記事の結論
Agentic AI Foundation(AAIF)の設立背景と、AIエージェント連携をどの規格に乗せるべきかを、事業側の判断軸として整理します。
Agentic AI Foundation(AAIF)の設立背景と、AIエージェント連携をどの規格に乗せるべきかを、事業側の判断軸として整理します。
Agentic AI Foundation(AAIF)の設立背景と、AIエージェント連携をどの規格に乗せるべきかを、事業側の判断軸として整理します。
「新しい規格が出るたびに、どれに投資すべきか決められない」「連携を作り込んだ直後にベンダーが方針転換したら、投資が無駄になるのが怖い」「現場はまだスプレッドシートとコピー&ペーストで回っているのに、エージェントの話をされても実感が湧かない」——AI連携のご相談で、経営・情報システムの方からよく出てくる声です。
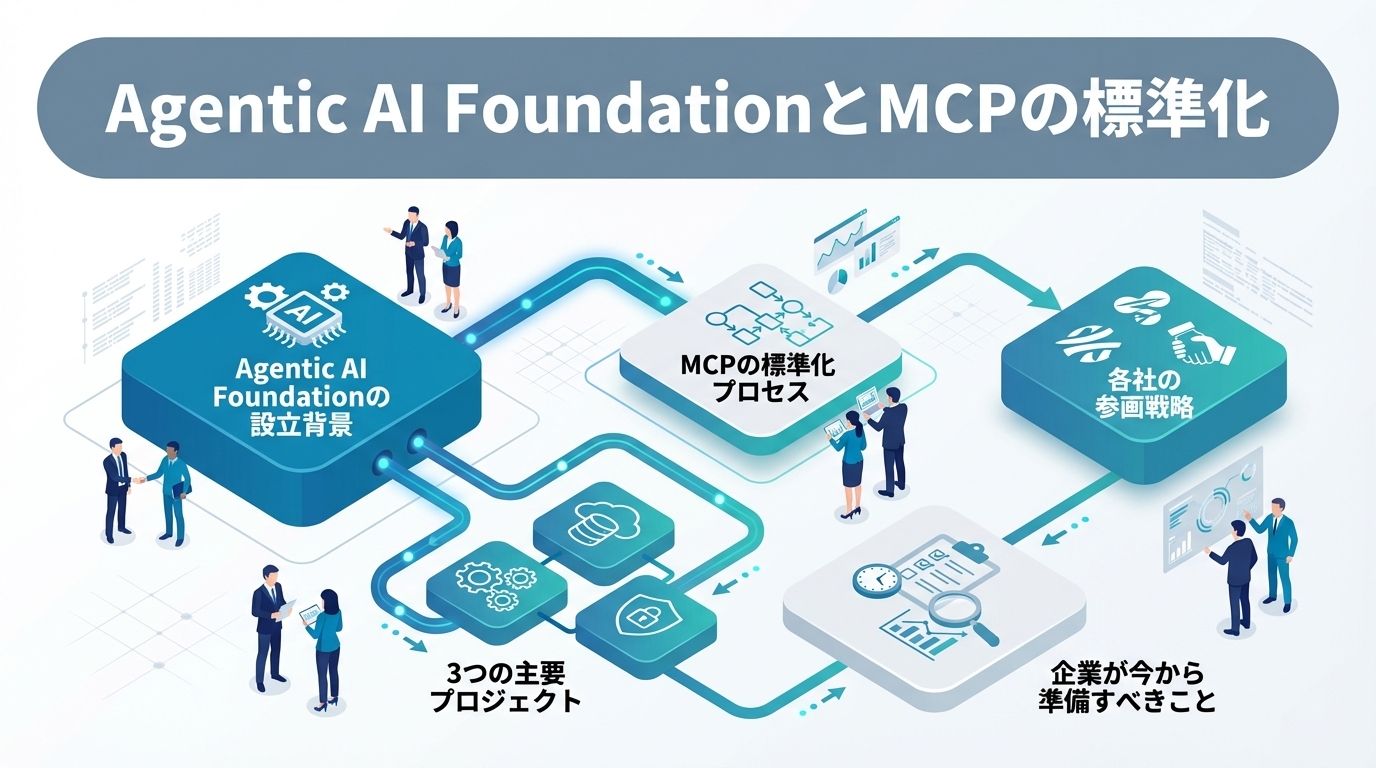
Agentic AI Foundation(AAIF)とは、Linux Foundation傘下で、AIエージェントが外部のツールやデータとつながるための規格を中立的に策定する組織です。 その中核に据えられたのがMCP(Model Context Protocol)で、Anthropicが開発した仕様がLinux Foundationへ寄贈され、特定ベンダーの所有物ではない業界標準として運営される形になりました。企業側から見ると、「どのAIベンダーに賭けるか」ではなく「標準に沿って自社データの出口を1本作るか」へ、問いそのものが変わったということです。
本記事は、AAIFの設立背景、MCPの標準化が業界に与える影響、そして他の主要プロジェクト(goose、AGENTS.md)との関係を解説します。詳しくは「MCPサーバーの構築ガイド」で解説しています。AI活用完全ガイドで、AI活用の全体像を把握できます。なお、参画企業や仕様のスケジュールは発表時点の情報です。個別の事実関係は今後も更新され得ますが、本記事ではその変化の中でも変わらない「構造」の部分を中心に整理しています。
この記事では、AAIFの設立背景から自社のMCP対応の進め方まで、事業側の判断に必要な情報を順を追って整理します。技術仕様の細部そのものよりも、「投資判断」と「自社の土台づくり」の観点を重視して書いています。
AIエージェントの基盤として、自社データをMCPで接続することを検討しているエンジニア・CTO・情報システム責任者の方に向けて書いています。最後まで読むと、「自社のどのデータから、どの順番でAIエージェント対応を進めるか」を自分の言葉で説明できるようになります。
AAIFの話は技術ニュースとして語られがちですが、事業側にとっての本質は「規格の断片化リスクが下がった」という一点にあります。ここでは、なぜ標準化が必要になったのか、なぜLinux Foundationだったのか、そして参画企業の顔ぶれから何が読み取れるのかを順に整理します。技術の詳細より先に、投資判断の文脈で押さえておきたい部分です。
AIは「チャットボット」から「自律的に行動するエージェント」へと進化してきました。この過程で各社が独自のエージェントフレームワークとツール連携方式を開発した結果、ベンダーロックインと規格の断片化が課題になりつつありました。詳しくは「MCPのエンタープライズ導入ガイド」で解説しています。
企業の立場で考えると、これは扱いにくい状況です。自社のCRMや基幹データをAIから使えるようにしたいと思っても、接続方式がAIベンダーごとに異なれば、その数だけ実装の作り分けが発生します。結果として「どこかのベンダーを選ばないと前に進めないが、選んだ瞬間に乗り換えコストが跳ね上がる」という状態になります。
こうした断片化は、AIに限らず新しい技術が広がる局面で繰り返し見られてきた構図です。そして現場で起きているのは、もう少し地味な話です。営業が顧客情報をまとめるのに、CRMを開き、メールを検索し、スプレッドシートの管理表を確認し、チャットの履歴を遡る。この作業をAIに任せたくても、接続方式がツールごとに違えば、そのつなぎ込みだけでプロジェクトが1本立ってしまいます。標準化は、このつなぎ込みの重複を減らすための取り組みだと捉えるとわかりやすいかと思います。
Linux Foundation傘下で設立された理由は、Linux、Kubernetes、Node.jsといった業界標準技術の中立的なガバナンスを長年にわたり実績として持つ組織だからです。特定のAI企業に依存しない中立性が、競合関係にあるOpenAI、Google、Microsoftが同じテーブルに着くことを可能にしました。
ここは見落とされやすいのですが、標準化の価値は「技術的に優れているか」よりも「誰が意思決定権を握っているか」で決まる側面があります。1社が仕様を所有している限り、その企業の事業戦略が変わった瞬間に仕様も変わり得ます。中立組織に移管されたという事実は、企業が中長期のIT投資を乗せる土台として重要な意味を持ちます。
| 企業 | 主な貢献 | MCP採用状況 |
|---|---|---|
| Anthropic | MCP開発・寄贈、Claudeでのネイティブサポート | Claude Desktop、Claude API |
| OpenAI | AGENTS.md寄贈、Agents SDKでのMCPサポート | ChatGPT Desktop、Responses API |
| Gemini/Vertex AIでのMCPサポート | Gemini、Google AI Studio | |
| Microsoft | Copilot/VS CodeでのMCPサポート | Microsoft Copilot、VS Code |
| AWS | クラウドインフラでのMCPホスティング | Amazon Bedrock |
| Cloudflare | エッジ環境でのMCPサーバーホスティング | Cloudflare Workers |
| Block | gooseフレームワーク寄贈 | goose AIエージェント |
| Bloomberg | 金融データMCPの実装 | Bloomberg Terminal連携 |
この表で注目したいのは、モデルを作る企業(Anthropic・OpenAI・Google)、クラウド基盤を提供する企業(Microsoft・AWS・Cloudflare)、そして実際に業務で使う側の企業(Block・Bloomberg)が揃っている点です。レイヤーの異なる関係者が同じテーブルに着いている構造は、標準が一部の都合で歪みにくいことを示しています。
ただし、標準化されたからといって「どのAIに切り替えても同じ結果が出る」わけではありません。プロトコルが共通化されるのは接続方式であり、モデルの応答品質や日本語での振る舞いは各社で差があります。接続の互換性と、実務で使える品質は別の話として評価する必要があります。
規格に投資するかどうかを判断するとき、仕様の中身より先に見るべきなのは「その仕様が誰によって、どう決まるのか」です。MCPはAnthropicからLinux Foundationへ寄贈され、SEPという公開プロセスで更新される体制になりました。この節では、その仕組みと、今後の進化方向を整理します。
MCPは2024年11月にAnthropicが開発・公開し、2025年12月にLinux Foundationに寄贈されました。この間にMCPはSDKのダウンロード数とアクティブサーバー数の両方で大きなエコシステムへと成長しており(寄贈発表時点の情報)、事実上の業界標準となった段階での中立的組織への移管です。
普及しきる前に標準化団体へ持ち込まれた規格は、そのまま使われなくなることも珍しくありません。MCPの場合は、実装が広がりエコシステムが形成された後で中立組織へ移っています。実装数が先にあり、統治がそれに追いついた形です。この順番は、投資判断の観点では安心材料になります。
MCPの仕様更新は、SEP(Spec Enhancement Proposal)と呼ばれる提案プロセスを通じて行われます。誰でもSEPを提案でき、オープンな議論を経てプロトコルに反映される仕組みです。発表されている計画では(2026年時点の情報)、必要なSEPの取りまとめを経て、次期仕様のリリースが予定されています。
自社の業務要件で困っていることがあれば、提案する側に回れるということでもあります。ただし、提案が通るまでには合意形成の時間がかかります。仕様変更を待つ前提で計画を組むのではなく、現行仕様でできる範囲から着手し、拡張は後から取り込む姿勢が現実的です。
なお、個別の日程は今後変わり得ます。投資判断で本当に見るべきなのは日程表ではなく、「変更が公開の場で合意される」という構造のほうです。仕様の中身が進化し続けても、決まり方が開かれている限り、自社はその変化に追従する手段を持てます。
発表されているMCPの進化方向は以下の通りです。
| 進化の方向 | 内容 | 企業側への影響 |
|---|---|---|
| ステートレスHTTPの強化 | エージェンティックアプリケーションはステートフルだが、プロトコル自体はステートレスにする | スケーラビリティとセッション管理の両立がしやすくなる |
| 認証の標準化 | OAuth 2.1のさらなる洗練と、既存IdPとの統合パターンの標準化 | 既存の認証基盤に乗せやすくなる |
| ツールアノテーションの拡張 | セキュリティレベル、実行コスト、レイテンシなどのメタデータ追加 | どのツールをAIに開放するかの判断材料が増える |
| エリシテーション | サーバーがクライアントに対して必要な情報を構造的に要求する仕組み | 情報不足による誤作動を減らせる |
この中で事業側が特に押さえておきたいのは、認証の標準化とツールアノテーションです。「AIエージェントに何をさせてよいか」の線引きを、担当者の裁量ではなく仕組みとして持てるかどうかが、実務で使えるかどうかを分けます。逆に言えば、この2つが自社の要件に届かない間は、書き込み系の処理を広く開放するのは時期尚早だと判断できます。
AAIFにはMCP、goose、AGENTS.mdという3つのプロジェクトがあります。並列に紹介されることが多いのですが、実際には担当する層が異なり、競合ではなく積み重なる関係です。ここを整理しておくと、自社が何に手を付けるべきかが判断しやすくなります。
AAIFの中核プロジェクトであるMCPは、AIモデルとツール・データを接続するための普遍的な標準プロトコルです。「AIのUSB-C」と例えられるように、どのAIモデル(Claude、ChatGPT、Gemini)からでも、どのツール(CRM、会計、チャット)にでも接続できる互換性を提供します。
接続の層で決めるべきは、技術的な実装よりも「どのデータ・どの操作をAIに開放するか」です。コンタクトの閲覧までなのか、取引の更新まで許すのか。この線引きは業務ルールそのものなので、エンジニアだけでは決められません。事業側と一緒に決める必要がある、という点が接続層の特徴です。
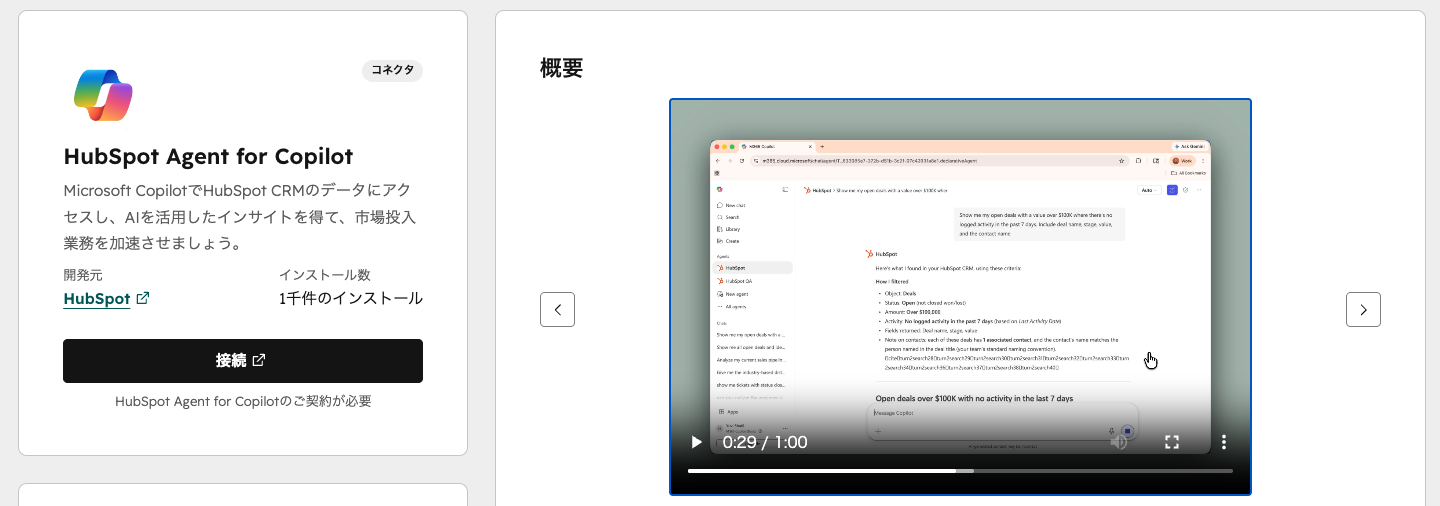
次の画面は、HubSpotが公式アプリとして提供している「HubSpot Agent for Copilot」のマーケットプレイス掲載ページです。CRM側が標準に対応することで、別ベンダーのAIアシスタントからCRMデータを扱えるようになる、という接続層の具体例にあたります。
Block社(旧Square)が開発したgooseは、ローカルファーストのオープンソースAIエージェントフレームワークです。言語モデル、拡張可能なツール、MCP標準のインテグレーションを組み合わせ、開発者が自社環境でAIエージェントを構築・実行するための基盤を提供します。MCPクライアントの参照実装としての役割も果たしています。
ローカルファーストという設計は、社外にデータを出しにくい業務での選択肢になります。ただし、自社環境で動かすということは、その環境の運用・監視・アップデートを自社で背負うということでもあります。小規模に検証する段階ではメリットが大きく、全社展開の段階では運用体制の設計が別途必要になります。検証のつもりで始めたものが本番運用になり、担当者1人しか中身を把握していない、という状態は避けたいところです。
OpenAIが2025年8月にリリースしたAGENTS.mdは、AIコーディングエージェントにプロジェクト固有のガイダンスを提供するための標準フォーマットです。リポジトリのルートにAGENTS.mdファイルを配置することで、AIエージェントがプロジェクトのコーディング規約、テスト方法、デプロイ手順を理解して作業できます。公開以降、多くのオープンソースプロジェクトで採用が進んでいると報告されています。
この考え方は、開発現場に限った話ではありません。AIに何かを任せるとき、「前提と作法をどこに書いておくか」を決めていないと、毎回プロンプトで説明し直すことになります。担当者ごとに指示の質が変わり、結果もばらつきます。属人的な指示ではなく、参照される場所に文脈を置いておく。これは仕組み化の発想そのもので、人が入れ替わっても同じ品質で回るための条件です。
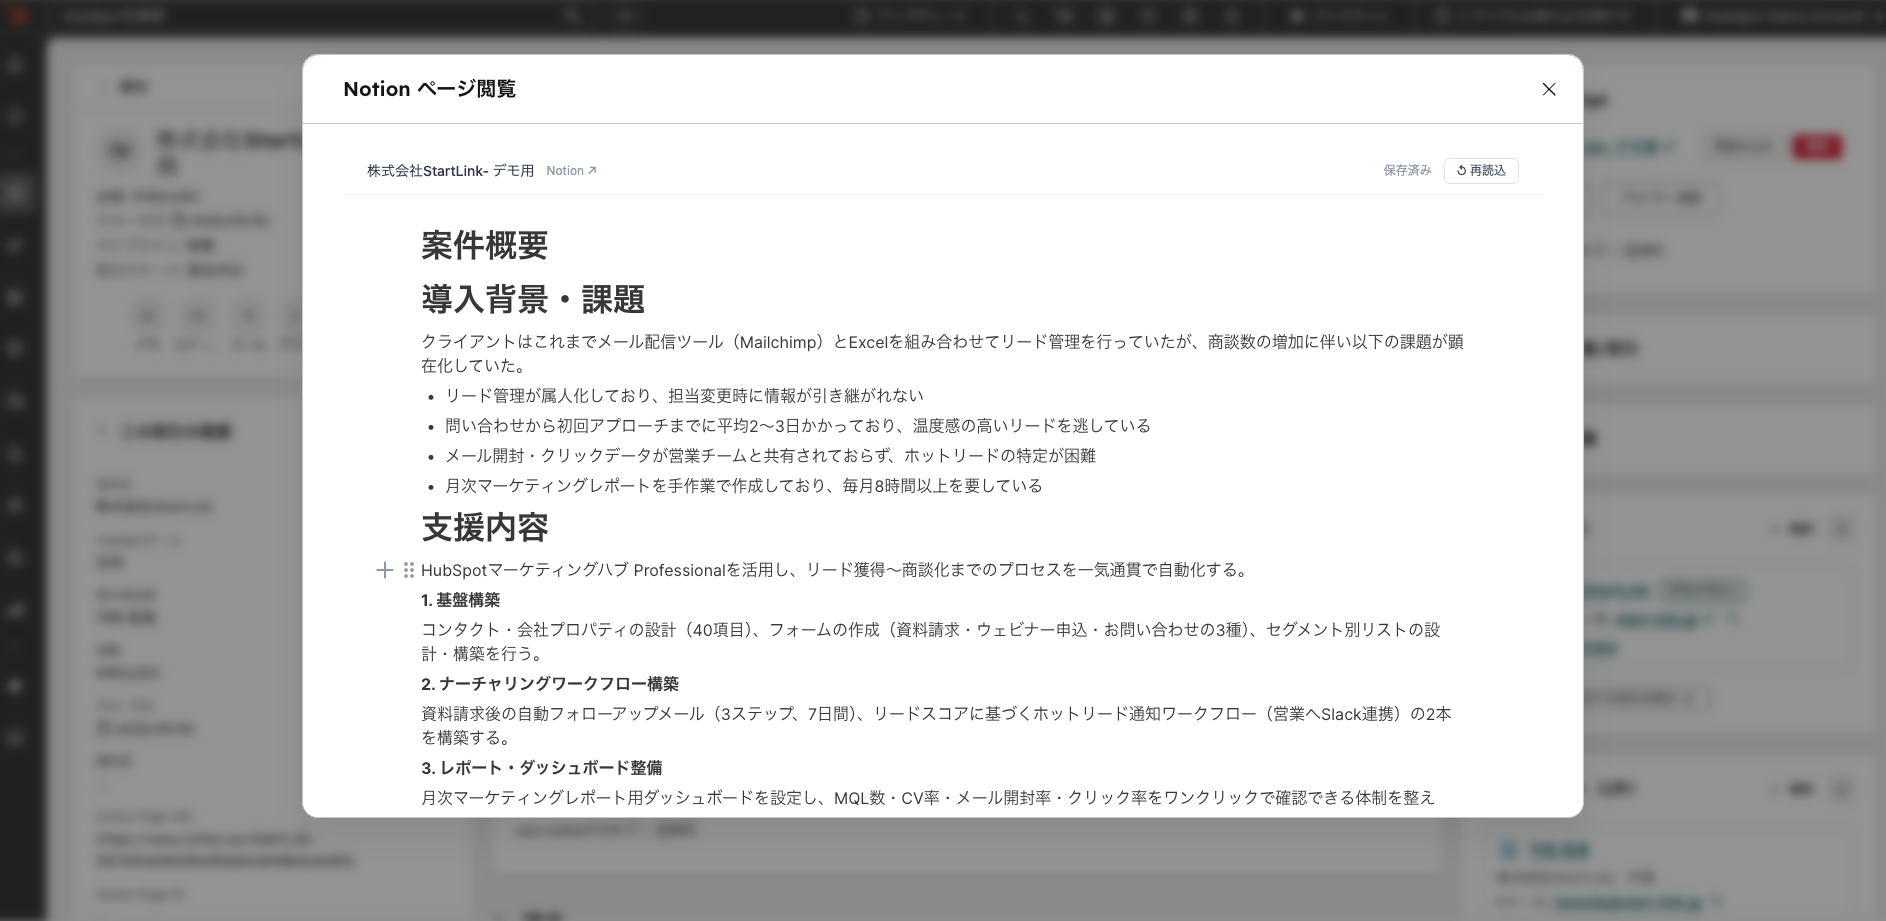
次の画面は、HubSpotのレコード画面のサイドバーにドキュメントを表示する連携カードの一例です。開発ドキュメントに限らず、案件に紐づく前提情報や手順書を「決まった場所」に置き、レコードから参照できるようにする。AGENTS.mdと同じ発想を、営業やカスタマーサクセスの現場に持ち込んだ実装例と見ることができます。
| 層 | プロジェクト | 決めること | 自社が着手する優先度の考え方 |
|---|---|---|---|
| 接続 | MCP | どのデータ・機能をAIに開放するか | 最初に着手する層。ここが無いと他が動かない |
| 実行 | goose等 | エージェントをどこで動かすか | 接続先が固まってから選ぶ |
| 文脈 | AGENTS.md等 | AIに与える前提と作法をどこに置くか | 運用を始めた直後から整備が必要になる |
多くの企業がつまずくのは、実行の層(どのエージェント製品を使うか)から入ってしまうケースです。接続する先のデータが整理されていなければ、どのエージェントを選んでも出てくる答えは同じように頼りないものになります。製品選定の会議を開く前に、自社のデータがどこにどう置かれているかを確認するほうが、結果的に近道になります。
競合関係にある各社がどう動いているかは、単なる業界ニュースではありません。「複数の有力プレイヤーが同じ標準に寄せている」という事実は、その標準に投資するリスクを下げます。ここでは各社の動きと、そこから読み取れることを整理します。
OpenAIは当初独自のツール連携方式(Function Calling)を推進していましたが、2025年3月にMCPのサポートを表明しました。この転換の背景については、MCP vs REST APIでも詳しく分析しています。Agents SDK、Responses API、ChatGPT DesktopでMCPネイティブサポートを実装し、AGENTS.mdの寄贈と合わせてオープンスタンダードへのシフトを示しています。
独自方式を持っていた企業が標準側へ寄ったという動きは、標準化の流れを判断するうえで重みがあります。自社が独自の連携方式を作り込もうとしている場合、その保守を何年背負うのかを考え直す材料になります。
Google DeepMindは2025年4月にMCPの採用を発表し、Gemini、Google AI Studio、Vertex AIでMCPサーバーへの接続を可能にしました。Google Workspaceとの統合により、Gmail、Google Calendar、Google DriveのデータをMCP経由でAIエージェントから操作できる環境を構築しています。
業務データの多くがGoogle Workspaceに置かれている企業にとっては、既存の資産をそのまま活かせる方向の動きです。一方で、「Workspaceにあるから安心」ではなく、どのデータをAIから触らせるかの線引きは自社で決める必要があります。ドライブに置かれた見積書や契約書をどう扱うかは、標準が決めてくれる話ではありません。
MicrosoftはMicrosoft CopilotとVS CodeでMCPをサポートし、Azure上でのMCPサーバーホスティングを推進しています。Entra ID(旧Azure AD)との認証統合により、エンタープライズ顧客がMCPを既存のセキュリティ基盤と統合しやすい環境を整えました。既存のID基盤に乗せられるという点は、情報システム部門にとっては導入判断の大きな部分を占めます。
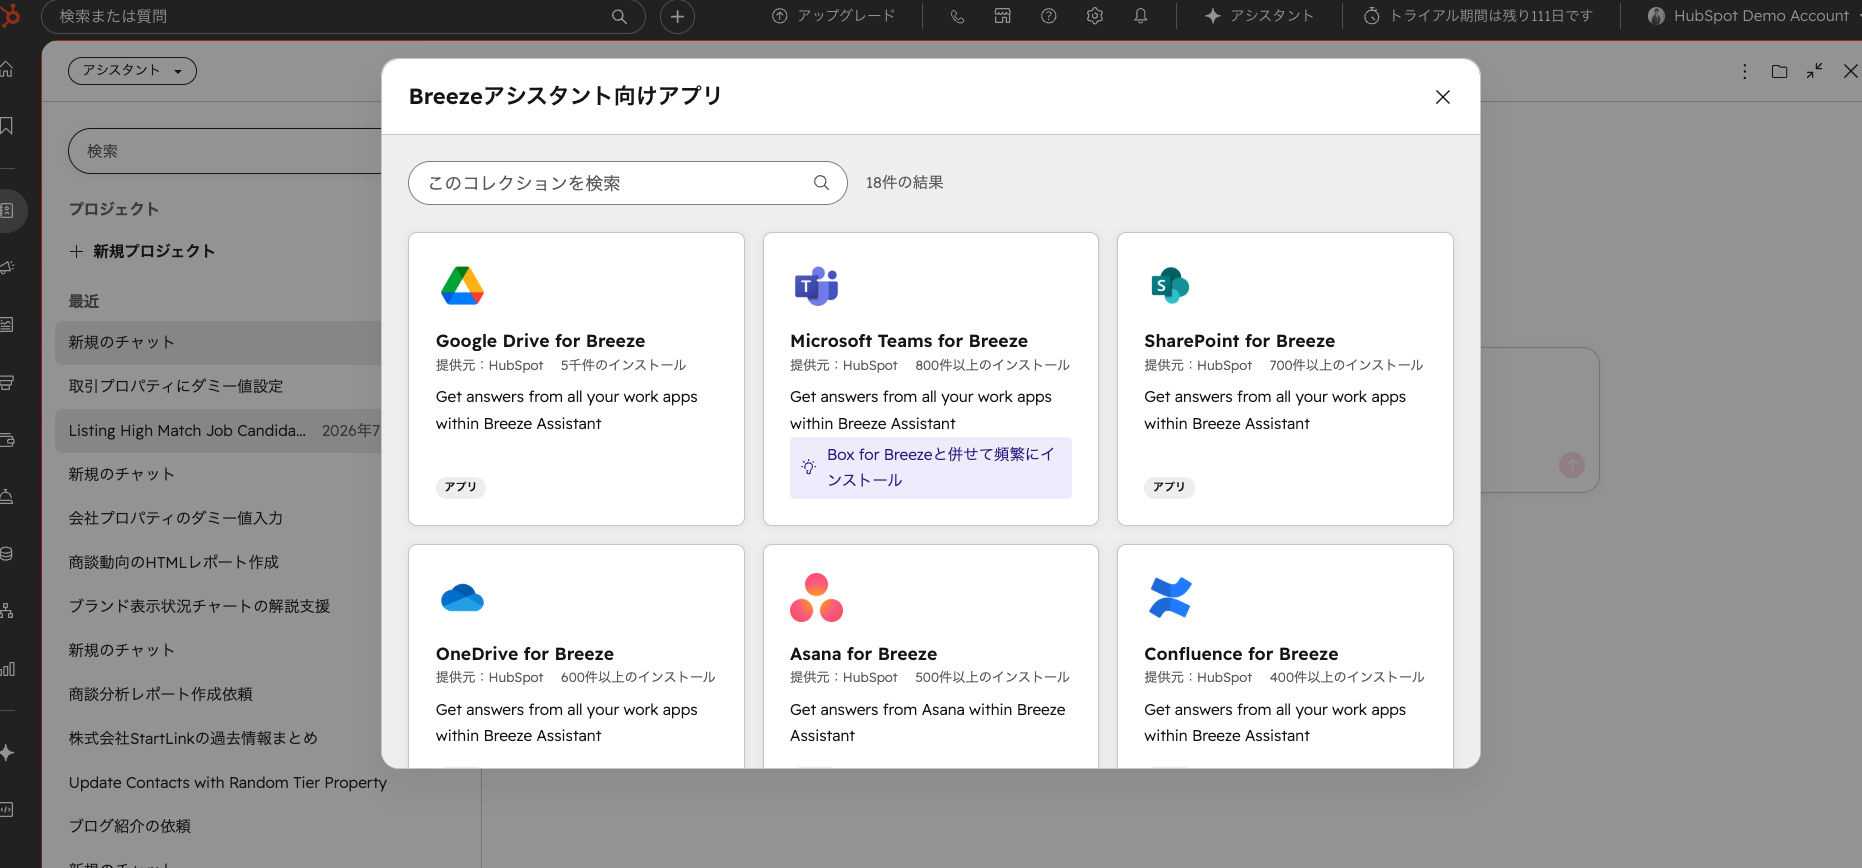
次の画面は、Breezeアシスタントから接続できるアプリの一覧です。OneDrive・SharePoint・Box・Google Drive・Teamsといった、すでに業務で使われているストレージやコミュニケーションツールが並んでいます。AI側から見た「接続先の候補」が、特別なシステムではなく日常の業務ツールであることが見て取れます。
| 読み取れる事実 | 自社の判断への影響 |
|---|---|
| 独自方式を持っていた企業が標準へ寄った | 自社独自の連携方式を新規に作り込む理由が弱くなる |
| モデル・基盤・利用企業の各層が参画している | 一部の事業判断で標準が急に消える可能性は下がる |
| 既存のID基盤との統合が進んでいる | 認証を一から設計せず、既存資産に乗せる前提で検討できる |
| 接続先候補が日常の業務ツールである | 特別なシステム投資より、既存ツールのデータ整理が先になる |
なお、各社の製品対応状況は発表時点のもので、今後も変わっていきます。変わらないのは「競合関係にある有力プレイヤーが同じ土台に投資している」という構図のほうです。個別の製品ニュースを追いかけるより、この構図を判断材料にすることが、この節の趣旨です。
ここまで標準化の話をしてきましたが、実務で最大の壁になるのは技術ではありません。AIエージェントに接続すべきデータが、そもそもスプレッドシートと個人のメールボックスに散らばっている状態だと、標準に対応しても取り出せるものがない、という話になります。
顧客リストはスプレッドシート、やり取りは個人のメール、進捗の共有はチャット、見積は各自のローカルファイル——この状態でAIエージェントをつないでも、返ってくるのは断片的な情報です。人間であれば「あの案件は確か営業の担当者が持っていたはず」と補完できますが、AIはその補完ができません。
さらに厄介なのは、同じ会社の情報が複数のシートに別々の表記で存在するケースです。顧客リストにもある、担当者マスタにもある、しかも更新日が違う。どちらが正なのかを判断できないまま参照させると、誤った前提で提案が生成されます。
CRMを「入力する場所」ではなく「事業成長のエンジン」として捉え直すと、AI対応の準備は次の3点に整理できます。
| 前提条件 | 内容 | AIエージェント連携での意味 |
|---|---|---|
| 一元管理 | コンタクト・会社・取引・チケットがリレーションデータベースとして紐づいている | 「この会社の過去のやり取り全部」を一度に取得できる |
| 自動化 | ステージ変更や担当者割当がワークフローで動く | 人の入力漏れによるデータの欠損が減る |
| 可視化 | ダッシュボードで指標がリアルタイムに見える | AIが参照する数値と、人が見る数値が一致する |
AIに接続する前に、この3点がどこまで整っているかを確認しておくことをおすすめします。接続は後からでも作れますが、データの整合性は後から遡って直すのが最も大変な部分です。
なお、この考え方はHubSpotに限った話ではなく、リレーションデータベースを持つCRM全般に共通します。製品の選定より先に、自社のデータをどう構造化するかを決めることが先決です。
データを整えようとすると、つい「とりあえず必要そうな項目を全部作る」方向に進みがちです。しかし実際には、ほとんど使われていない項目が大量に並んでいるCRMは珍しくありません。項目が多いほど入力されなくなり、入力されない項目はAIから見れば空欄のノイズになります。項目が少ないほうが、入力する側も何を書くべきかに集中できます。
必要なのは、ステージ移行時に必須入力を設定するような、少数の項目を漏れなく埋める仕組みです。例えば、見積提示のステージへ移すときは金額とクローズ予定日を必須にする、受注に移すときは受注理由を必須にする、といった形です。必須入力プロパティは、データ品質を担保すると同時に、新人が「この段階では何を確認すべきか」を学ぶ手がかりにもなります。人の努力や声かけに頼るのではなく、仕組みとして入力が揃う状態を作ることが、AI活用の下地になります。
AIに渡すデータの質は、結局のところ営業プロセスの設計で決まります。取引のステージをどう切るか、各ステージの受注確度をどう置くか、ステージの定義を社内でどう共有するか、移行時に何を必須入力にするか。この4つが決まっていると、パイプラインのデータはそのままAIが読める構造になります。
あわせて、失注した取引をそのまま放置せず、将来の掘り起こし対象としてナーチャリングの流れに戻す設計まで考えておきたいところです。失注理由が分類されて残っていれば、AIが参照する文脈としても価値のある履歴になりますし、「なぜ失注したか」の分析は製品や営業の改善にそのまま還元できます。
逆に、ステージの定義が人によって違う状態だと、「商談中」の意味が担当者ごとにずれたデータが積み上がります。その状態でAIに商談の要約や優先順位付けをさせても、出てくる答えは現場の感覚とかみ合いません。AI連携の前にプロセス設計を見直すことになるのは、遠回りに見えて実は本筋です。
AAIFの設立で標準が定まったとはいえ、いきなり全社規模のAIエージェント基盤を作る必要はありません。私たちがご相談をいただく際にお伝えしているのは、効果が見えやすい範囲から小さく始めて、段階的に広げる進め方です。
最初に選ぶのは、「今この瞬間、誰かが手作業で情報をかき集めている業務」です。商談前の顧客情報の整理、問い合わせ内容の分類、過去のやり取りの要約といった、範囲が明確で頻度の高い作業が向いています。
逆に向かないのは、最初から意思決定そのものをAIに任せようとするケースです。パイプラインのステージ設計や、ライフサイクルステージの定義といった「事業理解が前提になる判断」は、人が決めるべき領域です。AIに任せるのは情報収集と整理、判断は人が持つ。この線引きを最初に決めておくと、後の設計がぶれません。
小さく始めるといっても、権限設計は最初から必要です。どのデータをAIから読めるようにするか、書き込みまで許すのか、誰の権限で動くのか。ここを曖昧にしたまま広げると、後から権限を絞るのは手間がかかります。
特に、AIが生成した内容をそのまま外部に送信する設定は慎重に扱うべきです。私たちは、メール送信などの外部アクションは人が確認してから実行する運用を基本としてお伝えしています。下書きまでをAI、送信判断は人間、という分担です。自律的に送信まで任せる設定は、現時点では見送るほうが安全だと考えています。
1つの業務で効果が見えたら、隣接する業務へ広げます。コンタクト管理で使えたなら取引管理へ、取引管理で使えたら請求・会計側の連携へ、という順番です。全体フローとしては、コンタクト → 取引 → 顧客 → 請求という流れの中で、どこにAIを挟むと効くかを1つずつ検証していく形になります。
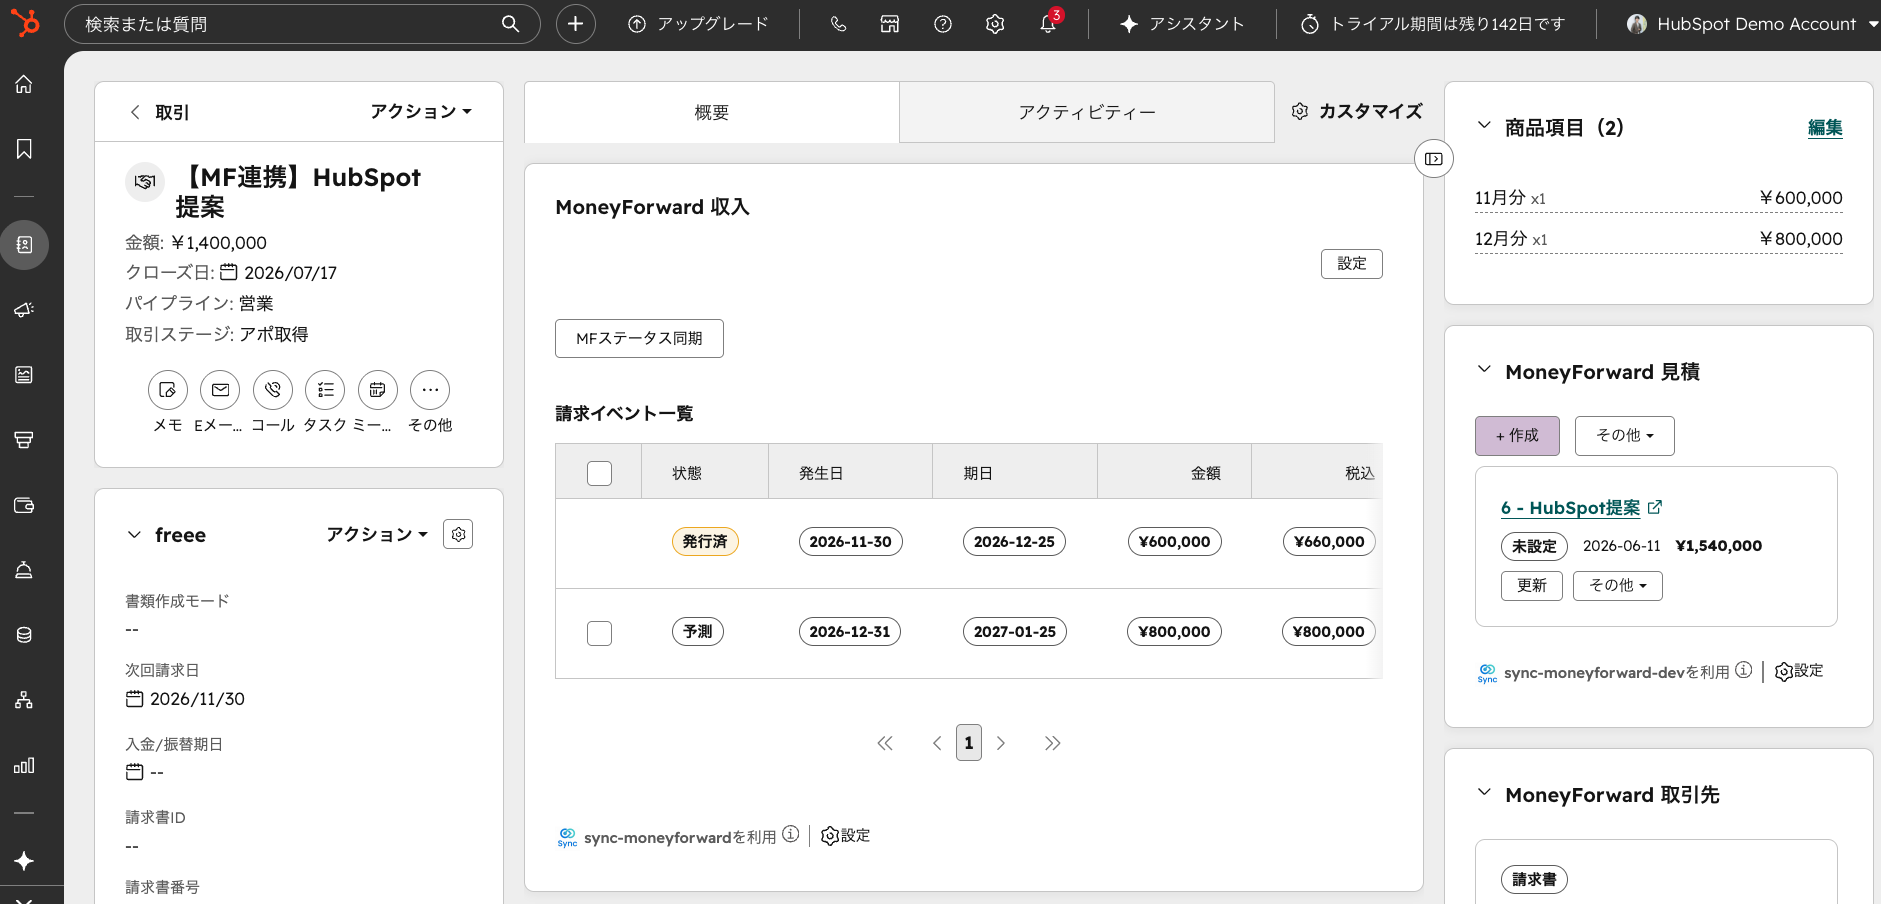
次の画面は、HubSpotの取引レコード上に、見積・取引先の連携カードと請求イベントの一覧(発行済・予測)を表示したものです。「取引」の段階から「請求」の情報まで1つのレコードでつながっていると、AIが参照する文脈もこの流れに沿って広げやすくなります。
| 段階 | 対象範囲 | 確認すること |
|---|---|---|
| 第1段階 | 1業務・読み取りのみ | 出てくる情報が実務で使える精度か |
| 第2段階 | 隣接業務へ拡張・限定的な書き込み | 権限設計と承認フローが機能しているか |
| 第3段階 | 部門横断・他システム連携 | 運用の担当者と監視の仕組みが決まっているか |
企業様によって最適な形は異なります。扱うデータの機密性、既存システムの構成、社内のリテラシーによって、どこまで進めるべきかも変わります。第1段階で十分に成果が出る企業もあれば、第3段階まで設計したほうがよい企業もあります。自社にフィットした範囲を見極めることが、ここでは要点になります。
導入で失敗しやすいのは、役割分担を決めないまま「AIでなんとかなるだろう」と進めてしまうケースです。あらかじめ整理しておくと、判断に迷う場面が減ります。
| AIに任せる | 人が判断する |
|---|---|
| 問い合わせ内容の分類 | 何をAIに開放するかの線引き |
| レコードの要約 | 業務プロセスそのものの設計 |
| 企業情報のリサーチ | 最終的な外部送信の可否 |
| 下書きの生成 | 重要度の高い案件への対応方針 |
| データの整理・名寄せの候補提示 | 例外ケースの扱い方 |
AIは超一流の担当者というより、リサーチして叩き台を持ってきてくれるアシスタントに近い存在です。叩き台の品質が上がれば人の時間は空きますが、最終判断まで預けられるわけではありません。特に、規模の大きい案件や条件が複雑な案件については、リサーチ結果は参考にしつつも、内容は人が書くほうがよいでしょう。ここを正しく期待値設定できるかどうかが、定着するかどうかを分けます。
標準化は多くの問題を解決しますが、すべてではありません。導入を検討する段階で知っておいたほうがよい制約を、率直にお伝えします。
MCPに対応すれば接続はできます。しかし、接続した先のデータが整理されていなければ、返ってくる答えの質は上がりません。前の節で触れたとおり、データの一元管理と入力の仕組み化が先です。標準化の話題に乗って接続基盤だけ作り、肝心のデータが散らばったまま、という状態は避けたいところです。
多くのAIプロダクトは英語圏を起点に設計されています。生成される文章がそのまま日本のビジネス文書として通用するとは限らず、敬語や商習慣上の作法は、指示として明示的に与える必要があります。「丁寧語とビジネス上のお作法を守る」といったルールを、プロンプトやテンプレートの側に書いておくイメージです。この調整をどこで持つかを決めておかないと、現場で「結局書き直している」という状態になります。
MCPの仕様はSEPプロセスを通じて今後も更新されます。現時点で実装した内容が、将来の仕様変更で見直しを要する可能性はあります。ただし、これは独自方式を作り込む場合と比べれば小さいリスクです。独自方式は自社だけで保守し続ける必要がありますが、標準であれば移行の情報や事例が共有されます。
率直に申し上げると、すべての企業が今すぐMCP対応を進めるべきかというと、そうではありません。データがまだCRMに集約されていない、業務プロセス自体が標準化されていない、という段階であれば、先にやるべきことがあります。AIエージェント連携は、土台が整った企業が次の一段を上がるための手段であって、土台の代わりにはなりません。
| 今は見送ってよいケース | 先に取り組むべきこと |
|---|---|
| 顧客情報がスプレッドシートに分散している | CRMへの一元化とデータの名寄せ |
| 商談ステージの定義が担当者ごとに違う | ステージ定義の共通化と必須入力の設定 |
| 誰がどの業務を担当しているか曖昧 | 業務プロセスと担当範囲の整理 |
| 運用を見る担当者が決まっていない | 運用体制と監視の役割分担の決定 |
AAIFはLinux Foundationの傘下プロジェクトであり、プラチナ・ゴールド・シルバーの各メンバーシップティアが用意されています。また、MCPの仕様策定やgooseの開発にはオープンソースコントリビューターとして誰でも参加できます。GitHubリポジトリでのIssue報告やPull Request、SEPの提案が可能です。自社の業務要件に起因する課題があれば、提案する側に回ることもできます。
MCPの仕様策定プロセスがより透明になります。従来はAnthropicが主導していた仕様更新が、SEPプロセスを通じて複数企業の合意に基づいて行われるようになります。これにより、特定企業に有利な仕様変更が行われるリスクが低減し、エコシステム全体の信頼性が向上します。企業のIT投資判断という観点では、仕様の決まり方が公開されていること自体が評価材料になります。
MCPはツール・データとAIモデルを接続するプロトコルであり、エージェント間通信のプロトコルであるGoogleのA2A(Agent-to-Agent)とは補完的な関係にあります。Function Callingは各AIモデル固有のインターフェースですが、MCPという共通プロトコルへの収束が進んでいます。どちらか一方を選ぶ、という対立軸では捉えないほうが実態に近いです。
日本企業にとって、MCPの業界標準化は「自社のデータやAPIをAI対応にする」際の投資判断を容易にします。特定のAIベンダーに依存することなく、標準化されたプロトコルでAIエージェントとの連携基盤を構築できるため、中長期のIT投資リスクが軽減されます。日本のSaaS企業(freee、Sansan、マネーフォワードなど)がMCPサーバーを公開することで、日本のビジネスソフトウェアエコシステム全体のAI対応が加速する可能性があります。
自社のデータがどこに、どんな状態で存在しているかの棚卸しからです。スプレッドシートと個人のメールに情報が散らばっている状態では、標準に対応しても取り出せるものがありません。CRMへの一元化と、入力が漏れなく揃う仕組みづくりを先に進めたうえで、効果が見えやすい1業務からAI連携を試すのが現実的な順序です。
本記事では、Agentic AI FoundationとMCPの標準化について、設立背景・主要プロジェクト・各社の参画戦略・今後のロードマップ、そして自社で進める際の順序を解説しました。このテーマの全記事はMCP連携ガイドでご覧いただけます。
ポイントを振り返ります。
まずは、自社のデータの棚卸しから始めてみてください。次の3ステップが最初の一歩になります。
MCPの基本的な仕組みについてはMCPとは何かを、実装手順はMCPサーバーの構築ガイドを、活用の具体例はMCP活用事例をご参照ください。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。