この記事の結論
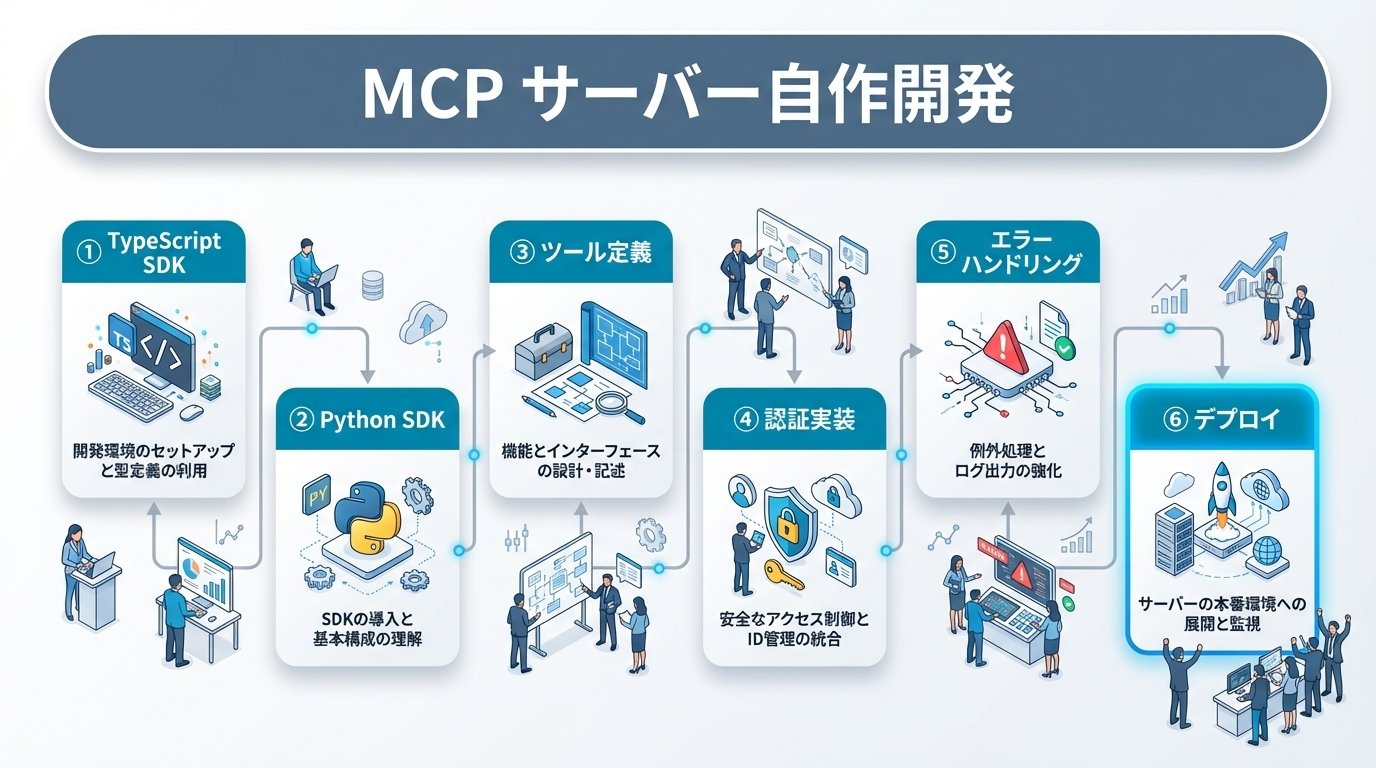
MCPサーバーは、TypeScript SDKかPython SDKを使えば小さな規模から自作できます。成果を分けるのはコードの量ではなく、AIが迷わず使えるツール設計です。
MCPサーバーは、TypeScript SDKかPython SDKを使えば小さな規模から自作できます。成果を分けるのはコードの量ではなく、AIが迷わず使えるツール設計です。
MCPサーバーは、TypeScript SDKかPython SDKを使えば小さな規模から自作できます。成果を分けるのはコードの量ではなく、AIが迷わず使えるツール設計です。
既存のMCPサーバーで自社の業務フローを扱えない場合や、社内APIをAIから呼び出したい場合は、自作を検討する余地があります。まず必要な操作と既存の連携手段を照合し、どこに独自のツールが要るかを見極めます。
MCPサーバーの自作とは、社内APIや独自の業務ロジックを、AIエージェントが自分で判断して呼び出せる「ツール」として公開する開発のことです。Anthropic社が公開したModel Context Protocol(MCP)は、AIモデルと外部システムをつなぐオープンスタンダードとして広がっています。
ただし、公開されているMCPサーバーは汎用的なものが中心で、自社独自の業務ロジックや社内APIをAIから扱うには、MCPサーバーを自作することになります。AI活用完全ガイドで、AI活用の全体像を把握できます。
CRM特化型のコンサルタントとして、HubSpot MCPサーバーやfreee MCPサーバーを日常的に活用している立場からいえば、MCPサーバーの自作は、AIエージェントを自社の業務に合わせて働かせるための現実的な手段だと考えています。本記事では、自作すべきかどうかの判断から、SDKの選び方、ツール定義の設計、認証とエラーハンドリング、本番運用までを順番に解説します。
自社独自のMCPサーバーを開発し、業務ツールとAIエージェントを接続したいエンジニアに向けた記事です。
MCPサーバーの自作は目的ではなく、業務の隙間を埋めるための手段です。まず、今どこで人が手作業でデータを運んでいるかを洗い出し、既存のMCPサーバーや公式連携で埋まるかを見極めてから自作に進む順序をおすすめします。この順序を守ると、作らなくてよいサーバーに工数をかけずに済みます。
例えば、社内の在庫管理システムから数値をスプレッドシートに書き出し、CRMの取引情報と突き合わせてからAIに貼り付けて要約させる、という流れが残っていないでしょうか。この形では、書き出した時点でデータが古くなり、担当者ごとに別のファイルが増えて、どれが正しい数値なのか分からなくなります。AIに渡す前の「人による転記」がボトルネックになっている業務こそ、MCPサーバーでシステムとAIを直接つなぐ価値が高い領域です。
候補の洗い出しは、「誰が・どのシステムから・何をコピーして・どこに貼っているか」を一覧にするところから始めてみてください。一覧の中で、転記の頻度が高く、転記ミスが後工程に響く業務から順に並べると、MCP化の優先順位がそのまま決まります。
HubSpot、Slack、Notion、GitHub、Google Workspaceなど、主要SaaSのMCPサーバーは充実してきています。一方で、次のようなケースは既存サーバーでは対応できず、自作の対象になります。
| ケース | 具体例 | 自作が求められる理由 |
|---|---|---|
| 社内専用API | 在庫管理システム、独自CRM、社内ナレッジDB | 公開サーバーが存在しない |
| 業務ロジックの組み込み | 見積計算、与信判断、承認フロー | 汎用サーバーでは業務ロジックを表現できない |
| 複数システムの横断操作 | CRM+会計+在庫の横断クエリ | 個別サーバーの組み合わせでは非効率 |
| セキュリティ要件 | オンプレミス限定、特定IPレンジ制限 | 公開サーバーでは自社のセキュリティポリシーに合わない |
| パフォーマンス最適化 | 大量データの事前集約、キャッシュ戦略 | 汎用サーバーでは応答速度が足りない |
ここが要点ですが、MCPサーバーの自作は「既存APIのラッパーを書く」こととは性質が異なります。MCPサーバーには、AIモデルが「どのツールを使うべきか」を自分で判断するためのメタ情報(ツールの説明文、入力スキーマ、アノテーション)を持たせます。APIを呼べるだけのサーバーでは、AIがツールを選び間違えたり、誤ったパラメータを渡したりします。ツールの意味・用途・副作用を正確に書き込むことが、開発の中心になります。
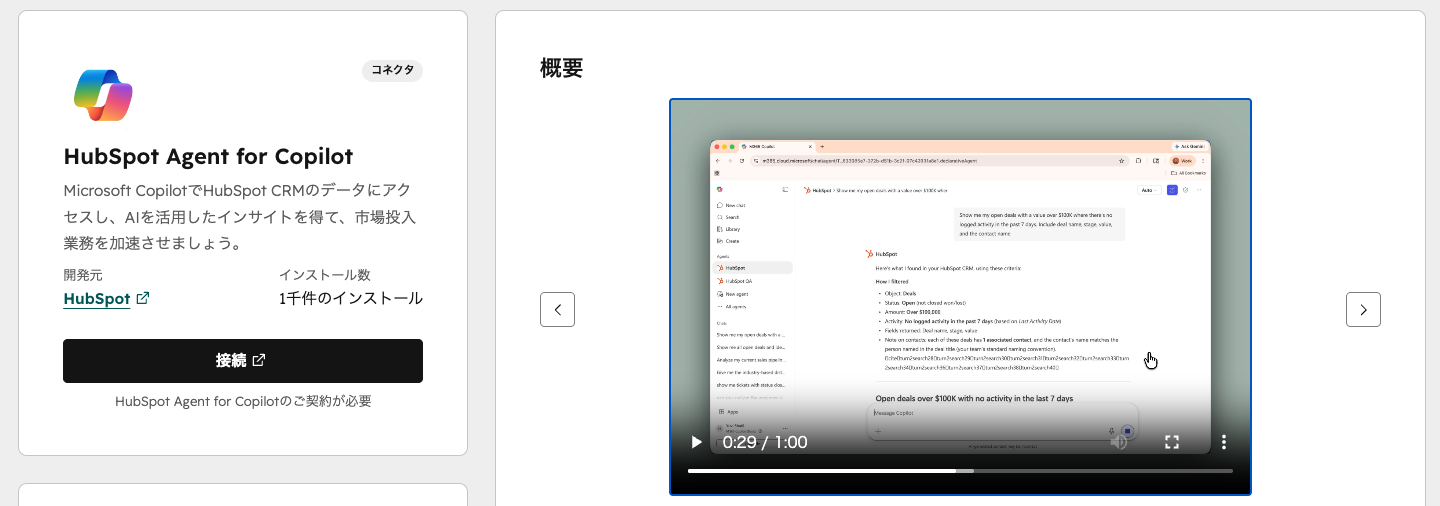
自作を決める前に、公式に提供されている連携アプリがないかを探しておくと遠回りを避けられます。次の画面は、HubSpot公式アプリ「HubSpot Agent for Copilot」のマーケットプレイス掲載ページで、開発元としてHubSpotが表示され、製品デモ動画のサムネイルが掲載されています。
自作するかどうかは、次の3つの軸で判断すると整理しやすくなります。
| 軸 | 見るべき問い | 既存サーバーを選ぶ | 自作を選ぶ |
|---|---|---|---|
| カバレッジ | 必要な操作を既存サーバーで実行できるか | 業務で使う操作の大半が揃っている | 業務の中心となる操作が欠けている |
| カスタマイズ性 | 業務固有のバリデーションや承認を挟むか | 汎用的な検索・更新で足りる | 見積計算や承認フローなど自社ルールを組み込む |
| 保守体制 | 仕様変更やSDK更新に追従する担当者を置けるか | 担当者を置けない | 担当者と改修の予算を確保できる |
判断の分かれ目は保守体制です。カバレッジとカスタマイズ性が自作側に倒れていても、保守する担当者を置けない場合は、既存サーバーと業務側の運用ルールの組み合わせで始め、担当者を確保できた段階で自作に切り替える進め方をおすすめします。
実装に入る前に、MCPサーバーがどのような部品で構成され、クライアントとどう通信するかを押さえておきます。構造を理解しておくと、「何をツールにして、何をリソースにするか」という設計判断で迷いにくくなります。MCPはJSON-RPC 2.0をベースにしたプロトコルで、サーバーはAIモデル(クライアント)と外部システムの橋渡しをするミドルウェアの役割を持ちます。
MCPサーバーが公開できる機能は、次の3つのプリミティブで構成されています。
| コンポーネント | 役割 | 具体例 |
|---|---|---|
| ツール(Tools) | AIが実行できるアクション | データベース検索、API呼び出し、ファイル操作 |
| リソース(Resources) | AIが参照できるデータ | ドキュメント、設定ファイル、データベースレコード |
| プロンプト(Prompts) | 事前定義されたテンプレート | レポート生成テンプレート、分析クエリテンプレート |
中心になるのはツールですが、リソースとプロンプトを組み合わせるとAIエージェントの活用幅が広がります。リソースはURI形式で識別するデータで、設定ファイルやドキュメントのような静的なものはサーバー起動時に登録し、データベースレコードのような動的なものはリソーステンプレートで定義します。例えば、社内のナレッジベースをリソースとして公開すれば、AIエージェントが回答時にその内容を参照できます。
プロンプトテンプレートは、特定の業務に合わせた入力パターンを事前に定義する機能です。例えば「月次売上レポートの生成」というテンプレートを用意しておけば、AIは対象月や部門といったパラメータをユーザーに確認し、必要なツールを順番に呼び出します。担当者ごとに依頼の書き方がばらつく業務ほど、テンプレート化の効果が大きくなります。
MCPの通信は、次の順序で進みます。
initialize リクエストを送信するtools/list で利用できるツールの一覧と説明文・スキーマを取得するtools/callで引数を渡して呼び出す(出典:MCP仕様「Tools」)この動的ディスカバリーの仕組みにより、クライアント側に事前のハードコーディングがなくても、AIは利用できる機能を把握できます。裏を返せば、手順3で返す説明文とスキーマの品質が、そのままAIの判断精度になるということです。
MCPサーバーのトランスポートには、ローカルプロセス間通信の stdio と、ネットワーク経由の Streamable HTTP の2種類があります。Streamable HTTPは、従来のSSE(Server-Sent Events)方式に代わって標準になったトランスポートで、単一のHTTPエンドポイントでPOSTとGETの両方を扱えます。
| 項目 | stdio | Streamable HTTP |
|---|---|---|
| 起動方法 | クライアントがローカルプロセスとして起動 | サーバーとして常時稼働 |
| 想定利用者 | 開発者本人、チーム内 | 社外ユーザー、複数チーム |
| デプロイ | 不要 | コンテナ・サーバーレス・VMなど |
| クライアント認証 | トランスポート層では不要 | OAuth 2.1などで実装 |
| 既存インフラとの相性 | ― | ロードバランサー、CDN、WAFと組み合わせやすい |
利用者が開発者本人とチーム内に限られるならstdio、社外や複数チームに公開するならStreamable HTTPを選びます。最初はstdioで作り、利用者が増えた段階でStreamable HTTPに載せ替える順序にすると、認証やインフラの設計を後回しにして業務への効果を先に検証できます。
MCPの公式SDKとしては、TypeScriptとPythonの2つが中心です。どちらもMCPプロトコルの機能をサポートしていますが、スキーマ定義の方法やデプロイ先の選択肢に違いがあります。言語の好みではなく、つなぎたい既存システムとチームのスキルで選ぶことをおすすめします。
| 比較軸 | TypeScript SDK | Python SDK |
|---|---|---|
| GitHubリポジトリ | modelcontextprotocol/typescript-sdk | modelcontextprotocol/python-sdk |
| スキーマ定義 | Zod | Pydantic |
| トランスポート | stdio / Streamable HTTP | stdio / Streamable HTTP |
| 型安全性 | TypeScriptの型システムで静的チェック | 型ヒント+Pydanticで実行時バリデーション |
| 非同期処理 | Node.jsのイベントループ | asyncio |
| デプロイ先の例 | Vercel / Cloudflare Workers / AWS Lambda | AWS Lambda / Google Cloud Functions / 自社サーバー |
| 向いている用途 | Webアプリ連携、フロントエンドとの統合 | データ分析、ML連携、既存Pythonシステムとの統合 |
| 参考情報 | 公開されているMCPサーバーにTypeScript製が多く、参考実装を探しやすい | データサイエンス系の連携事例が多い |
判断に迷ったときは、次の表の上から順に当てはめてみてください。
| 状況 | 選ぶSDK | 理由 |
|---|---|---|
| つなぐ先のシステムがDjangoやFastAPIで作られている | Python SDK | 既存のモデル定義やライブラリをそのまま使える |
| データ集計や機械学習の処理をツールにしたい | Python SDK | 分析ライブラリとの連携がしやすい |
| Next.jsなどのWebアプリにMCP機能を組み込みたい | TypeScript SDK | 同じコードベースで管理できる |
| 初めて自作し、参考実装を見ながら進めたい | TypeScript SDK | 公開されている実装例を探しやすい |
保守する人が書ける言語を選ぶことも、見落とされがちな判断材料です。作った人しか読めない言語で書くと、異動や退職のタイミングでサーバーが止まったまま放置されます。チームの誰が引き継いでも読める言語を選ぶことが、属人化を防ぐ第一歩になります。
ここからは、社内の顧客情報APIをMCP対応させる例で、最小構成の実装を見ていきます。最初から多くのツールを作るのではなく、検索のような読み取り専用のツール1つで動かし、AIが正しく使えることを見てから広げる進め方をおすすめします。コード例のAPIエンドポイントは説明用の架空のものです。
TypeScript SDKでは、McpServer のインスタンスを作成し、ツールを定義して、トランスポートに接続します。
import { McpServer } from "@modelcontextprotocol/sdk/server/mcp.js";
import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
import { z } from "zod";

const server = new McpServer({
  name: "internal-crm-server",
  version: "1.0.0",
});

server.tool(
  "search_customers",
  "顧客名・メールアドレス・会社名で顧客情報を検索します。部分一致で検索され、最大20件を返します。",
  {
    query: z.string().describe("検索キーワード(顧客名、メールアドレス、会社名のいずれか)"),
    limit: z.number().optional().default(10).describe("取得件数の上限(デフォルト: 10、最大: 20)"),
  },
  async ({ query, limit }) => {
    const response = await fetch("https://internal-api.example.com/customers/search", {
      method: "POST",
      headers: {
        "Content-Type": "application/json",
        Authorization: `Bearer ${process.env.INTERNAL_API_TOKEN}`,
      },
      body: JSON.stringify({ query, limit: Math.min(limit, 20) }),
    });

    if (!response.ok) {
      return {
        content: [{ type: "text", text: `検索に失敗しました: ${response.statusText}` }],
        isError: true,
      };
    }

    const customers = await response.json();
    return {
      content: [{ type: "text", text: JSON.stringify(customers, null, 2) }],
    };
  }
);

const transport = new StdioServerTransport();
await server.connect(transport);構造はシンプルで、server.tool() にツール名・説明文・入力スキーマ・処理本体を渡すだけです。説明文に「部分一致」「最大20件」と制約まで書いている点が、後述するツール設計の考え方につながります。
Python SDKでは、FastMCP クラスを使うとデコレータでツールを定義できます。
import os

import httpx
from mcp.server.fastmcp import FastMCP
from pydantic import BaseModel, Field

mcp = FastMCP("internal-crm-server")

class CustomerSearchResult(BaseModel):
    id: str
    name: str
    email: str
    company: str
    status: str

@mcp.tool()
async def search_customers(
    query: str = Field(description="検索キーワード(顧客名、メールアドレス、会社名)"),
    limit: int = Field(default=10, le=20, description="取得件数の上限(最大20)"),
) -> list[CustomerSearchResult]:
    """顧客名・メールアドレス・会社名で顧客情報を検索します。部分一致で最大20件を返します。"""
    async with httpx.AsyncClient() as client:
        response = await client.post(
            "https://internal-api.example.com/customers/search",
            json={"query": query, "limit": limit},
            headers={"Authorization": f"Bearer {os.environ['INTERNAL_API_TOKEN']}"},
        )
        response.raise_for_status()
        return [CustomerSearchResult(**c) for c in response.json()]

if __name__ == "__main__":
    mcp.run()
FastMCP は、関数のdocstringをツールの説明文として、型ヒントとPydanticの Field を入力スキーマとして使います。TypeScript SDKよりコード量が少なく、Pythonに慣れた開発者には扱いやすい書き方です。
ツールが数個を超えてきたら、サーバー本体・ツール定義・リソースハンドラーをファイルで分けます。
| 置き場所 | 置くもの | 分ける理由 |
|---|---|---|
| サーバー本体 | インスタンス生成、トランスポート接続 | 起動設定の変更がツールに影響しない |
| ツール定義(ツールごとに1ファイル) | 説明文、スキーマ、処理本体 | チーム開発での競合を避け、ツール単位でテストできる |
| リソースハンドラー | 静的リソース、リソーステンプレート | 参照データの追加がツールに影響しない |
ツールごとにファイルを分けておくと、「このツールの説明文を直したら、AIの選び方がどう変わったか」をツール単位で比べられます。説明文の改善を繰り返すMCP開発では、この粒度でテストできることが効いてきます。
MCPサーバーの品質は、APIが動くかどうかより、AIがツールを正しく選び、正しいパラメータを渡せるかで決まります。この章では、説明文・粒度・アノテーション・エラーメッセージの4つを、AIの判断しやすさという観点から設計する方法を整理します。いずれも、人間の新人に業務マニュアルを渡すときと同じ発想で考えると設計しやすくなります。
AIモデルは、ツールの説明文を読んで「どのツールを使うべきか」を判断します。次の4つの原則で書くと、AIの判断精度が上がります。
| 原則 | 改善前 | 改善後 |
|---|---|---|
| 何ができるかを明確に書く | 顧客情報を操作します | 顧客名・メールアドレス・会社名で顧客情報を検索します |
| 制約を明示する | 顧客を検索します | 部分一致で検索し、最大20件を返します |
| パラメータの意味を具体的に書く | query: 検索語 | 検索キーワード(顧客名、メールアドレス、会社名のいずれか) |
| 副作用を宣言する | 顧客を更新します | 顧客のステータスを更新します。この操作は元に戻せません |
似た名前のツールが複数ある場合は、「顧客IDが分かっているときはget_customer、分からないときはsearch_customersを使います」のように、使い分けの条件まで説明文に書いておくと、AIの選び間違いが減ります。
MCPのツール粒度は、REST APIのエンドポイント粒度と一致させる必要はありません。REST APIでは GET /customers と GET /customers/:id は別エンドポイントですが、MCPツールとしては「顧客検索」と「顧客詳細取得」を1つにまとめるか分けるかを、AIが選びやすいかどうかで決めます。
| 判断の目安 | まとめる | 分ける |
|---|---|---|
| 入力の違い | パラメータの有無だけが違う | 必要な入力の種類がまったく違う |
| 副作用 | どちらも読み取り専用 | 読み取りと書き込みが混ざる |
| 利用場面 | 同じ質問の流れで続けて使う | 別の業務場面で使う |
読み取りと書き込みを1つのツールにまとめると、AIが検索のつもりで更新処理を呼ぶ余地が生まれます。副作用の有無が違う操作は、別のツールとして分けることをおすすめします。
MCPの仕様には、ツールの振る舞いをメタデータとして宣言するアノテーションがあり、例えばreadOnlyHint(読み取り専用か)やdestructiveHint(破壊的な変更を伴うか)を指定できます(出典:MCP TypeScript SDK「Tool annotations」)。
仕様上、クライアントは信頼できるサーバーから来たものでない限り、アノテーションを信頼できない情報として扱うこととされています(出典:Tools - Model Context Protocol Specification)。
つまり、アノテーションはクライアント側でユーザー確認を挟むための手がかりにはなりますが、それだけで安全が担保されるわけではありません。サーバー側でも、書き込み系ツールには入力値のバリデーションや対象件数の上限を設け、アノテーションと説明文とサーバー側の制御の3つで副作用を管理する設計にします。
MCPサーバーのエラーハンドリングは、AIエージェントが「エラーの原因を理解して、次の行動を判断できる」ことを目標に設計します。単に例外を投げるのではなく、AIが読める形でエラー情報を返します。
if (response.status === 404) {
  return {
    content: [{ type: "text", text: `顧客ID "${customerId}" は存在しません。search_customersツールで検索できます。` }],
    isError: true,
  };
}
if (response.status === 429) {
  return {
    content: [{ type: "text", text: "APIレート制限に達しました。30秒後に再試行してください。" }],
    isError: true,
  };
}
ポイントは、エラーメッセージの中に次の行動のヒントを含めることです。
| エラーの種類 | メッセージに含める内容 |
|---|---|
| 対象が見つからない | 代わりに使えるツール名と、その使い方 |
| レート制限 | 待つべき時間と、再試行してよいか |
| 入力値の不正 | どのパラメータが、どの形式であるべきか |
| 権限不足 | AIでは解決できず、人に確認を依頼すべきであること |
「顧客IDが存在しません」だけでなく「search_customersツールで検索できます」と書くことで、AIエージェントが自分でリカバリーの操作を選べるようになります。
MCPサーバーの認証は、どのトランスポートを使うかで考え方が大きく変わります。また、認証で「誰が使えるか」を決めたあとに、「AIにどこまで任せ、どこで人が判断するか」を決めることも、自作サーバーの設計に含まれます。この章では、その両方を扱います。
MCPサーバーの認証は、次の3つのレイヤーを区別して設計します。
| レイヤー | 説明 | 実装例 |
|---|---|---|
| クライアント認証 | MCPクライアント(Claude Desktopなど)がMCPサーバーに接続する際の認証 | OAuth 2.1、APIキー |
| バックエンド認証 | MCPサーバーが社内APIや外部サービスに接続する際の認証 | 環境変数でのトークン管理 |
| ユーザー認証 | エンドユーザーの権限に基づくアクセス制御 | JWTトークン、RBAC |
MCPの認可仕様では、HTTPベースのトランスポートはこの仕様に沿うことが推奨され、stdioトランスポートではこの仕様には従わず、環境から認証情報を取得することが推奨されています(出典:Authorization - Model Context Protocol Specification)。
stdioであればバックエンド認証の設計から始め、Streamable HTTPで公開する段階でクライアント認証とユーザー認証を加える、という順序で進められます。
stdioトランスポートでは、Claude Desktopの設定ファイル(claude_desktop_config.json)で環境変数を渡す形が一般的です。
{
  "mcpServers": {
    "internal-crm": {
      "command": "node",
      "args": ["./dist/server.js"],
      "env": {
        "INTERNAL_API_TOKEN": "your-api-token-here",
        "DATABASE_URL": "postgresql://user:pass@localhost:5432/crm"
      }
    }
  }
}認証情報はコードに直接書かず、環境変数で管理してください。さらに、社内APIのトークンは読み取り用と書き込み用で分けて発行し、まずは読み取り用だけをMCPサーバーに渡すと、ツールの設計ミスがあってもデータを壊す範囲を限定できます。MCPのセキュリティ設計の詳細はMCPのセキュリティリスクと実践的な対策ガイドをご覧ください。
MCPの仕様では、ツールはAIモデルが呼び出しを決めるものとされ、ツールの呼び出しを人が拒否できる状態を保つことが推奨されています(出典:Tools - Model Context Protocol Specification)。自作サーバーでも、この考え方に沿って、AIに任せる操作と人が判断する操作を分けておくことをおすすめします。
| AIに任せる操作 | 人が判断する操作 |
|---|---|
| 顧客情報・取引情報の検索と要約 | 顧客への外部送信(メール・チャット) |
| 問い合わせ内容の分類 | 取引金額や受注日の変更 |
| レポート用データの集計 | 大型案件へのアプローチ内容の決定 |
| 更新内容の下書き作成 | 下書きを反映するかどうかの最終判断 |
実装としては、書き込み系ツールを「下書きを作るツール」と「確定するツール」に分け、確定するツールはクライアント側でユーザー確認が出る設定にしておく形が扱いやすいと考えています。AIには下書きまでを速く作らせ、最終判断は人が持つ分担にすると、AIの判断ミスが顧客や経営数値に直接届くことを防げます。
CRMとAIエージェントをつなぐとき、MCPサーバーを単体の技術として考えると、「便利だが使われないツール」が増えていきます。コンタクトから取引、顧客、請求までの一連の流れのどこでAIに何をさせるかを先に決め、その穴を埋める形で自作サーバーを位置づけると、業務に定着しやすくなります。
自作MCPサーバーの役割は、業務フローの段階ごとに整理すると見えてきます。
| 業務の段階 | HubSpot側で扱う情報 | 自作MCPサーバーで補う例 |
|---|---|---|
| コンタクト | リード、問い合わせ内容 | 社内ナレッジDBを参照して、問い合わせへの回答案を作る |
| 取引 | 取引ステージ、金額、クローズ日 | 独自の見積計算ロジックや在庫システムを呼び出す |
| 顧客 | 会社、契約状況 | カスタムオブジェクトで管理するプロジェクトやサブスクリプションを参照する |
| 請求 | 請求に関わる取引情報 | 会計側のMCPサーバー(freee MCPサーバーなど)と組み合わせて横断的に照会する |
HubSpot MCPサーバーの基本的な活用方法はHubSpot MCPサーバーによるCRM操作の自動化で解説しています。標準オブジェクトの操作は既存のサーバーに任せ、業務固有の部分だけを自作する組み合わせにすると、保守する範囲を小さく保てます。
HubSpot CRMでは、コンタクト・会社・取引といった標準オブジェクトに加えて、カスタムオブジェクトを作成できます。カスタムオブジェクトはEnterpriseプランで利用できる機能です(出典:HubSpot「Create and edit custom objects」)。
例えば「プロジェクト管理」や「サブスクリプション管理」をカスタムオブジェクトで扱っている場合、公式のHubSpot MCPサーバーが対応する標準オブジェクトの操作だけでは、業務の中心となるデータに届かないことがあります。
このような場合は、HubSpot APIのカスタムオブジェクトのエンドポイントをラップするツールを自作します。そうすると、「この取引に紐づくプロジェクトの進捗を教えて」「サブスクリプションの更新期限が今月中の顧客を一覧にして」といった業務固有の問い合わせに、AIエージェントが直接答えられるようになります。
ツールを増やしすぎると、AIは似たツールの中から選び間違え、保守する側も全体を把握できなくなります。
ツール追加の判断は、「このツールがないと、どの業務で人が手作業に戻るか」を説明できるものに絞ることをおすすめします。次の運用ルールを決めておくと、ツールの乱立を仕組みで防げます。
この設計にはもう1つの効果があります。整理された説明文を持つツール群は、新しく加わったメンバーにとって「このシステムで何ができ、何に気をつけるべきか」を示すマニュアルにもなります。特定の詳しい人に聞かなくても、AIに聞けば社内システムの使い方が分かる状態は、個人の力量に頼らずに業務を引き継げる仕組みと言えます。
MCPサーバーは、いきなり多機能なものを作るより、読み取り専用のツール1つから始め、AIが正しく使えることを見ながら段階的に広げるほうが結果的に早く定着します。この章では、開発の手順と各段階で次へ進む条件、デバッグ、本番運用の設計を順に整理します。
既存の社内APIをMCPサーバーとして公開する手順は、次の5段階です。
| ステップ | やること | 次へ進む条件 |
|---|---|---|
| 1. API仕様の棚卸し | エンドポイント一覧を作り、AIエージェントが使う操作だけに絞る | 公開するツール候補と、その業務場面を一覧にできている |
| 2. ツール粒度の設計 | 検索と詳細取得をまとめるか分けるかなどを、AIの選びやすさで決める | 読み取りと書き込みが別のツールに分かれている |
| 3. 入力スキーマの定義 | Zod(TypeScript)またはPydantic(Python)で定義し、各フィールドの説明を書く | 全パラメータに意味と形式の説明が付いている |
| 4. エラーハンドリングの実装 | 次の行動のヒントを含むエラーメッセージを返す | 主要なエラーで、AIが自分でリカバリー操作を選べる |
| 5. テストとデバッグ | MCP Inspectorと実際のAIクライアントで動作を見る | 想定した質問に対して、AIが意図どおりのツールを選んでいる |
すべてのAPIエンドポイントをツール化する必要はありません。ステップ1で業務場面を書けないエンドポイントは、この段階では公開しない判断で問題ありません。
MCPサーバーのテストには、MCP Inspectorが便利です。ブラウザベースのUIからツールを直接呼び出して、レスポンスの形式や内容を見られます。
npx @modelcontextprotocol/inspector node ./dist/server.js開発に使うツールは、次のように使い分けます。
| ツール | 用途 | 提供元 |
|---|---|---|
| MCP Inspector | ブラウザUIでツール呼び出しをテスト | 公式 |
| Claude Desktop | 実際のAIクライアントでの動作確認 | Anthropic |
| Claude Code | CLIベースでの高速テスト・反復開発 | Anthropic |
MCP CLI(mcp dev) |
Python SDK付属の開発サーバー | 公式 |
Inspectorでは「ツールが正しく動くか」を、Claude DesktopやClaude Codeでは「AIが正しくツールを選ぶか」を見る、という分担にすると、問題がコードにあるのか説明文にあるのかを切り分けられます。
Claude Code Hooksを活用した開発自動化と組み合わせれば、コード変更時に自動でテストを走らせる仕組みも作れます。Claude Codeを活用した経営データの可視化やコンテンツマーケティングの支援の取り組みもご紹介しています。
ログ出力には1点、stdio特有の落とし穴があります。stdioトランスポートでは標準出力がMCPの通信に使われるため、console.log で標準出力にログを書くと通信が壊れます。ログは console.error で標準エラー出力に書くか、MCPのロギング機能を使ってクライアントに送ってください。
Streamable HTTPで公開する場合、デプロイ先はコンテナ(Docker/Kubernetes)、サーバーレス(AWS Lambda、Google Cloud Functions)、従来のVMなどから選べます。
Cloudflareは自社のWorkers環境でMCPサーバーのホスティングを公式にサポートしており、エッジ環境での運用も選択肢になります。社外公開や複数チームへの展開を見込むなら、早い段階でStreamable HTTPとコンテナの構成を試しておくと、載せ替えの手戻りが減ります。
本番環境では、次の順で監視を組み立てます。
MCPの通信はJSON-RPCベースのため、リクエストとレスポンスを構造化ログとして記録できます。一方で、CRMと連携するサーバーのログには、氏名・メールアドレス・電話番号といった個人情報がそのまま含まれます。ログを書き出す直前の処理でこれらのフィールドをマスクし、マスク前のペイロードはディスクに残さない設計にしてください。マスク対象のフィールド名を設定ファイルで管理しておくと、ツールを追加したときの漏れを防げます。
MCPサーバーの自作は強力な手段ですが、万能ではありません。導入してから「思っていたのと違う」とならないよう、制約と向かないケースを率直に整理しておきます。
MCPは、トランスポートの標準がSSEからStreamable HTTPに移ったように、仕様が進化を続けています。SDKのバージョンアップに伴って、コードの修正が発生する場合があります。SDKのバージョンを固定し、更新は仕様の変更履歴を読んだうえでテスト環境から段階的に反映する運用にしておくと、ある日突然サーバーが動かなくなる事態を避けられます。
ツールの説明文やスキーマの品質は、AIの判断精度に直結します。「コードは正しく動くのに、AIが正しく使ってくれない」という問題の多くは、コードではなくメタ情報に原因があります。また、AIが「なぜそのツールを選んだか」「なぜそのパラメータを渡したか」を追うデバッグは、従来のAPIデバッグとは性質が異なります。
改善は次の手順で進めます。
説明文と入力スキーマを整えても、モデルが意図と異なるツールを選ぶ可能性は残ります。変更や削除を伴うツールには、人が呼び出しを拒否できる承認手順を設けてください(出典:MCP仕様「Tools」)。
次のような状況では、自作以外の選択肢から検討することをおすすめします。
| 状況 | 自作が向かない理由 | 代わりの選択肢 |
|---|---|---|
| 既存サーバーで必要な操作の大半を実行できる | 自作分の保守負担に見合わない | 既存サーバーを使い、不足分は運用ルールで補う |
| 保守担当者を置けない | 仕様変更で止まったまま放置される | 公式連携やマーケットプレイスのアプリを使う |
| 元データがスプレッドシートに散らばっている | AIがつなぐ先のデータが定まらない | 先にCRMへの一元管理を進める |
| 業務ルールが担当者ごとに違う | ツールに組み込むルールを決められない | 先に業務プロセスとデータ定義を揃える |
特に3行目と4行目は見落とされがちです。データが一元管理されておらず、業務ルールも揃っていない状態でMCPサーバーを作っても、AIはばらばらのデータをばらばらのルールで扱うだけになります。MCPサーバーの自作は、CRMでのデータ一元管理と業務プロセスの整理ができてはじめて効果が出る取り組みだと考えています。
この節の要点は次のとおりです。
ツールが数個の小規模なサーバーであれば、SDKのボイラープレートが充実しているため、プロトコルを理解していれば短期間で開発からテストまで進められます。ツール数が多い本格的なサーバーでは、実装そのものより、説明文の改善を繰り返すテストと、ドキュメント整備に時間がかかります。まずは読み取り専用のツール1つで動かし、所要時間の感覚をつかんでから計画を立てることをおすすめします。
公開されているMCPサーバーやAnthropic公式のリファレンスサーバーにはTypeScript製のものが多く、参考実装を探しやすいのはTypeScript SDKです。初めて自作する場合は、TypeScript SDKから始めると迷いにくいと考えています。一方、データ分析や機械学習との連携ではPython SDKの事例が充実しており、既存システムがPythonであればPython SDKを選ぶほうが自然です。
開発者本人やチーム内での利用であれば、stdioが手軽です。サーバーをnodeやpythonのプロセスとして起動するだけで使えるため、デプロイの手間がかかりません。社外のユーザーや複数チームに公開する場合はStreamable HTTPが適していますが、OAuth 2.1による認証やHTTPSの設定を追加で設計することになります。
MCP Inspector(npx @modelcontextprotocol/inspector)を使うと、ブラウザのUIからツールを直接呼び出し、レスポンスの形式や内容を見られます。あわせて、MCPクライアントライブラリでサーバーにプログラムから接続し、各ツールの入出力を検証するユニットテストも有効です。最後に、実際のAIクライアントで業務の質問を投げ、意図どおりのツールが選ばれるかを見ます。
Claude Desktopの設定ファイル(macOSの場合は ~/Library/Application Support/Claude/claude_desktop_config.json)の mcpServers セクションに、サーバーの起動コマンドと環境変数を記述します。設定後にClaude Desktopを再起動すると、登録したツールが利用できるようになります。
前提知識としては、TypeScriptまたはPythonの基本的な開発経験と、REST APIの基本的な理解があれば十分で、プロトコルの概要は公式ドキュメント(modelcontextprotocol.io)で把握できます。
MCPサーバーの自作は、TypeScript SDKやPython SDKが整ってきたことで、小さな規模から始めやすくなっています。成果を左右するのはコードの書き方より設計の考え方で、ツールの粒度、説明文の品質、エラーメッセージの内容を、AIが適切に判断できるかという観点で決めていくことがポイントになってきます。
本記事の要点を整理します。
まずは、読み取り専用のツール1つから始めてみてください。次の3ステップで進められます。
このテーマの記事はMCP連携ガイドでまとめてご覧いただけます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。