この記事の結論
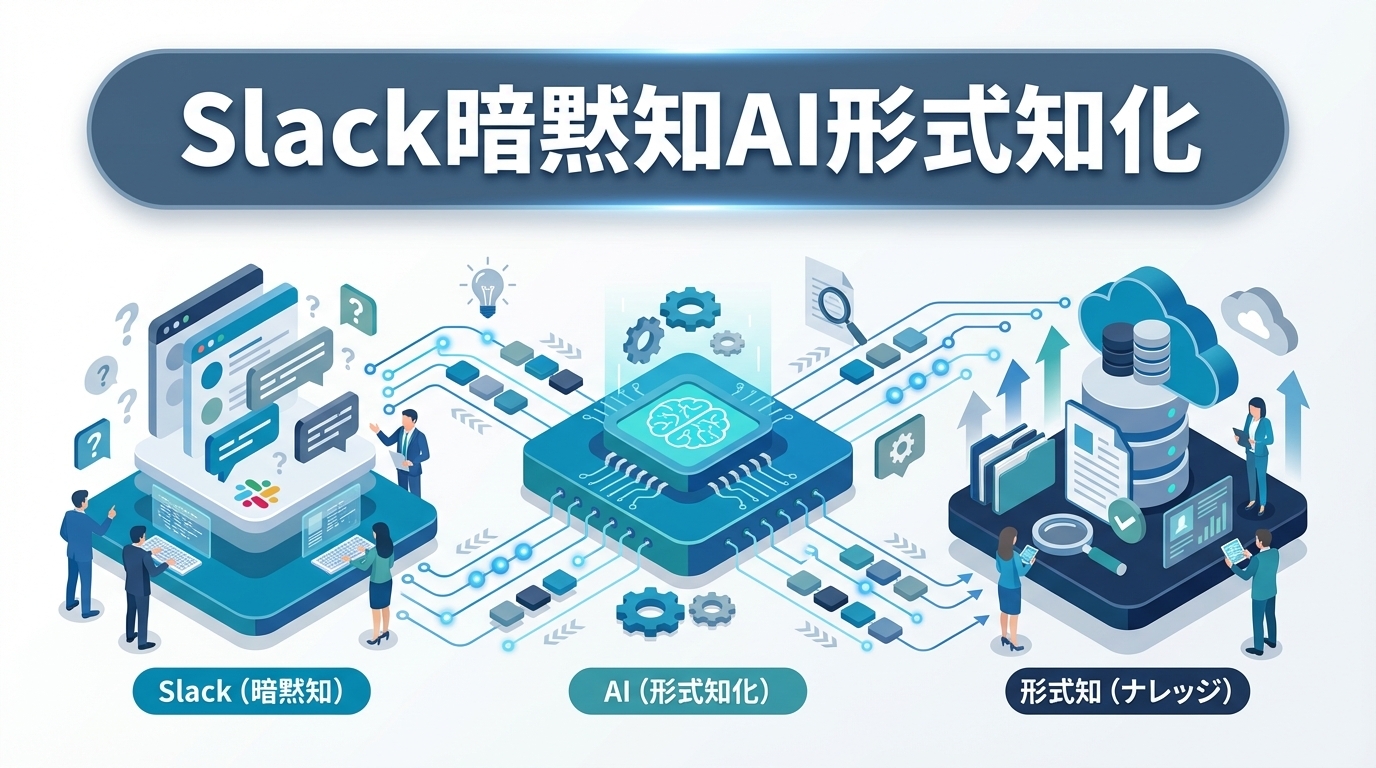
Slackの会話には、判断基準やトラブル対応の知恵が含まれることがあります。AIで会話を整理し、人が確認して公開する流れを設計すれば、後から探して再利用しやすい形で残せます。
Slackの会話には、判断基準やトラブル対応の知恵が含まれることがあります。AIで会話を整理し、人が確認して公開する流れを設計すれば、後から探して再利用しやすい形で残せます。
Slackの会話には、判断基準やトラブル対応の知恵が含まれることがあります。AIで会話を整理し、人が確認して公開する流れを設計すれば、後から探して再利用しやすい形で残せます。
「それ、前にSlackで誰かが答えてたんだけど…」「このトラブル、前にも同じ対応をした気がする」「新人から同じ質問が何度も届く」——こうした場面では、情報が残っていても、必要な人が見つけられないことがあります。
Slackのナレッジ管理とは、チャットに埋もれた判断基準やノウハウを抽出・整理し、検索して再利用できる形で蓄積する取り組みです。AIには抽出・要約・分類の下書きを任せ、内容の正確さや公開範囲は人が判断します。
AI活用完全ガイドで、AI活用の全体像を把握できます。AIの基本については「AIとは?ビジネス活用の全体像をわかりやすく解説」で解説しています。
関連する記事の一覧はAI実務活用ガイドをご覧ください。
Slackでのやりとりを組織のナレッジとして残したいチームに向けて、仕組みづくりの考え方と進め方を整理します。扱うのは次の5点です。
Slackでは、業務の相談や判断が日々交わされます。一方、会話は時系列に流れるため、後から必要な知見を探すには、当時の話題や言葉を手がかりにする必要があります。
企業のナレッジは、保存のされ方によって3つの層に分けて考えられます。以下は、保存場所を整理するための例です。
| 層 | 内容 | 保存状態 |
|---|---|---|
| 公式ドキュメント | マニュアル、仕様書、FAQ | WikiやNotionで管理されている |
| 半公式ナレッジ | 議事録、レビューコメント、設計メモ | ツール内に散在 |
| 暗黙知 | ベテランの判断基準、トラブル対応ノウハウ | Slackの会話に埋もれている |
3番目の「暗黙知」に当たる会話には、手順だけでなく、状況に応じた判断理由が含まれる場合があります。ただし、会話をそのまま公式なルールとして扱うことはできません。後から使うには、元の文脈を確かめ、現在も有効な内容かを担当者が確認する必要があります。
過去の会話を検索するとき、探す人が当時の書き手と違う言葉を使うことがあります。例えば「請求書の宛名が違う」と探しても、過去の会話には「送付先の会社名がずれていた」と書かれているかもしれません。
このような場合は、似た意味の表現も候補に含めて探し、見つかったスレッドの前後関係を確認する方法が考えられます。AIによる要約や検索結果は、元の会話へたどるための手がかりとして使います。関連する業務の情報整理については、経営データの可視化やコンテンツマーケティングの支援のページもご覧ください。
「良い回答を見つけたらFAQ台帳に転記する」という運用は、担当者の時間に更新が左右されます。似た内容が複数の場所に残れば、どれを参照すべきかの判断も必要になります。
そこで、会話から候補を拾って文章の下書きにする工程をAIに任せ、人は採用・修正・公開の判断に集中する設計を検討します。更新先と責任者も先に決めておくと、公開後の管理がしやすくなります。
FAQ作成では、Slackの会話から「質問と、それに対する回答」の候補を探し、個別のやりとりを再利用しやすい文章に整えます。候補が見つかっても、回答が正しい、現在も有効、公開してよいとは限りません。抽出から公開までを一つの流れとして設計します。
以下は、FAQ作成を設計する際の工程例です。表にある投稿先や処理は、導入時に選ぶ構成要素であり、標準で自動実行される機能を示すものではありません。
| 段階 | 処理 | 主な内容 |
|---|---|---|
| データ抽出・前処理 | 会話からQ&A候補を取り出す | Q&A形式の会話を抽出、質問の分類・クラスタリング、重複質問の統合 |
| AI処理(LLM) | 候補をFAQの文章に整える | 質問の一般化(固有名詞を汎用表現に)、回答の要約・構造化、カテゴリの自動分類 |
| FAQドキュメント生成 | 整えたFAQを置き場所に反映する | NotionやConfluenceへの自動投稿、Slack Canvasへの反映 |
「質問の一般化」は慎重に行います。「A案件の見積もりで割引欄が表示されない」という個別の質問を、別の案件にも使えるFAQへ書き直せる場合があります。一方、案件固有の設定が原因なら、固有名詞を外すだけでは誤解を招きます。公開前に適用条件を確認してください。
次のパターンは、確認すべきスレッドを絞るための候補です。どれも回答の正確さを証明するものではありません。
| パターン | 検知ルール | 例 |
|---|---|---|
| 明示的な質問 | 「?」で終わるメッセージ | 「この機能の設定方法は?」 |
| 暗黙的な質問 | 「〜について教えてください」「〜がわかりません」 | 「権限設定の方法がわかりません」 |
| 回答が付いたスレッド | 質問メッセージに複数のスレッド返信が付いている | (自動判定) |
| リアクション付き回答 | チェックマークや賛同のリアクションが一定数以上付いている | チームが「有用」と認めた回答 |
返信数やリアクション数を条件に使う場合は、チャンネルごとの会話量を見ながら調整します。まず少数の候補を人が確認し、採用できたものと取りこぼしたものを記録すると、ルールを見直す材料になります。
次の表は、FAQを継続して管理するための設計例です。通知や追跡を使う場合は、そのための設定や実装が必要です。
| 仕組み | 説明 |
|---|---|
| 自動レビュー通知 | 生成されたFAQを、元のスレッドの投稿者にDMで確認依頼する |
| 鮮度管理 | FAQ作成日から一定期間が経ったら「要更新」フラグを付ける |
| 利用追跡 | FAQが参照された回数を記録し、よく使われる順に並べる |
| フィードバックループ | 「この回答は役に立ちましたか?」をリアクションで投票してもらう |
更新の目安は、内容ごとに決めます。変更されやすい設定手順と、変更頻度の低い説明を同じ周期で確認する必要はありません。参照回数も確認し、よく使われるFAQから優先して見直す運用が考えられます。
プロジェクトの課題や判断理由を後から参照したい場合は、会話を振り返りの材料として残す方法があります。AIによる要約は下書きにとどめ、決定事項や成果は担当者が確認します。
プロジェクトが終わった後、当時のチャンネルを読み返すだけでは、どの案が最終決定だったのか分かりにくい場合があります。知見として残す対象を「課題」「対応」「判断理由」「次回への学び」に分け、元の会話と照合して記録します。
次の表は、要約を行う場合の運用設計例です。各行は実施済みの取り組みや、AIが自動で正しく整理できることを報告するものではありません。頻度は会話量とレビューできる人員に合わせて決めます。
| フェーズ | 処理 | 頻度 |
|---|---|---|
| 日次サマリー | その日のチャンネルの会話をAIで要約 | 毎営業日の終了後 |
| 週次レポート | 週単位の進捗・課題・決定事項をAIが整理 | 毎週末 |
| マイルストーン記録 | 重要な意思決定・方針変更を検知して記録 | 出来事が起きたとき |
| プロジェクト終了時 | 全期間の知見をAIが「振り返りレポート」として生成 | プロジェクト終了時 |
すべてを同時に始める必要はありません。会話量が少なければ週次の下書きから試し、重要な決定は担当者がその都度記録します。要約に「決定事項」と書かれていても、元の会話で合意が確認できなければ確定情報として残さないようにします。
レポートの項目を先に決めておくと、人が確認すべき箇所が明確になります。以下も作成時の分担例です。
| 項目 | 記載する内容 | 作成の分担 |
|---|---|---|
| 基本情報 | プロジェクト名、期間、参加メンバー | AIがチャンネル情報から下書き |
| 主要な成果 | 実装したこと、改善したこと | AIが下書きし、成果の数値は人が記入 |
| 直面した課題と解決策 | 課題、解決策、そこから得た学び | AIが会話から抽出し、人が補足 |
| 次回プロジェクトへの提言 | 事前に確認しておくべき事項 | 人が中心に記入 |
例えば、ある会話に「APIのレート制限に到達した」という課題と「バッチ処理に変更した」という対応が残っていたとしても、その対応で問題が解消したかは別に確認します。成果の数値や次回への提言も、会話から推測して埋めず、担当者が根拠を確認して記入します。
新人向けには、公式ドキュメントに加え、よくある質問や社内で使われる言葉を探せるようにする設計が考えられます。Slackの会話は参考になりますが、古い慣習や個人の見解が混ざるため、公式情報との優先順位を決めておく必要があります。
| 課題 | 影響 |
|---|---|
| マニュアルが古い・散在している | 新人が正しい情報にたどり着けない |
| 先輩社員に質問するハードルが高い | 「こんなこと聞いていいのか」と遠慮して学習が遅れる |
| 同じ質問が毎回繰り返される | 教える側の負担が増える |
| 暗黙のルールが文書化されていない | 失敗して初めて学ぶことになり、影響が大きい |
この表は、オンボーディングの仕組みを見直す際に確認したい課題の例です。自社でどの課題が起きているかを確かめてから、扱う情報を選びます。
Slack上に新人向けのAIアシスタントを構築するなら、次の流れが一案です。
#onboarding のような専用チャンネルで質問します。出典を添えるのは、新人が回答の根拠を確認できるようにするためです。会話と公式ドキュメントの内容が食い違う場合は、回答を断定せず、担当者に確認できる導線を用意します。
アシスタントの話し方や回答のルールを、文章で定義しておく方法もあります。以下は、応答に関する設定を検討する際の参考画像です。
次の画像は、Breezeカスタマーエージェント ガイドライン設定画面です。
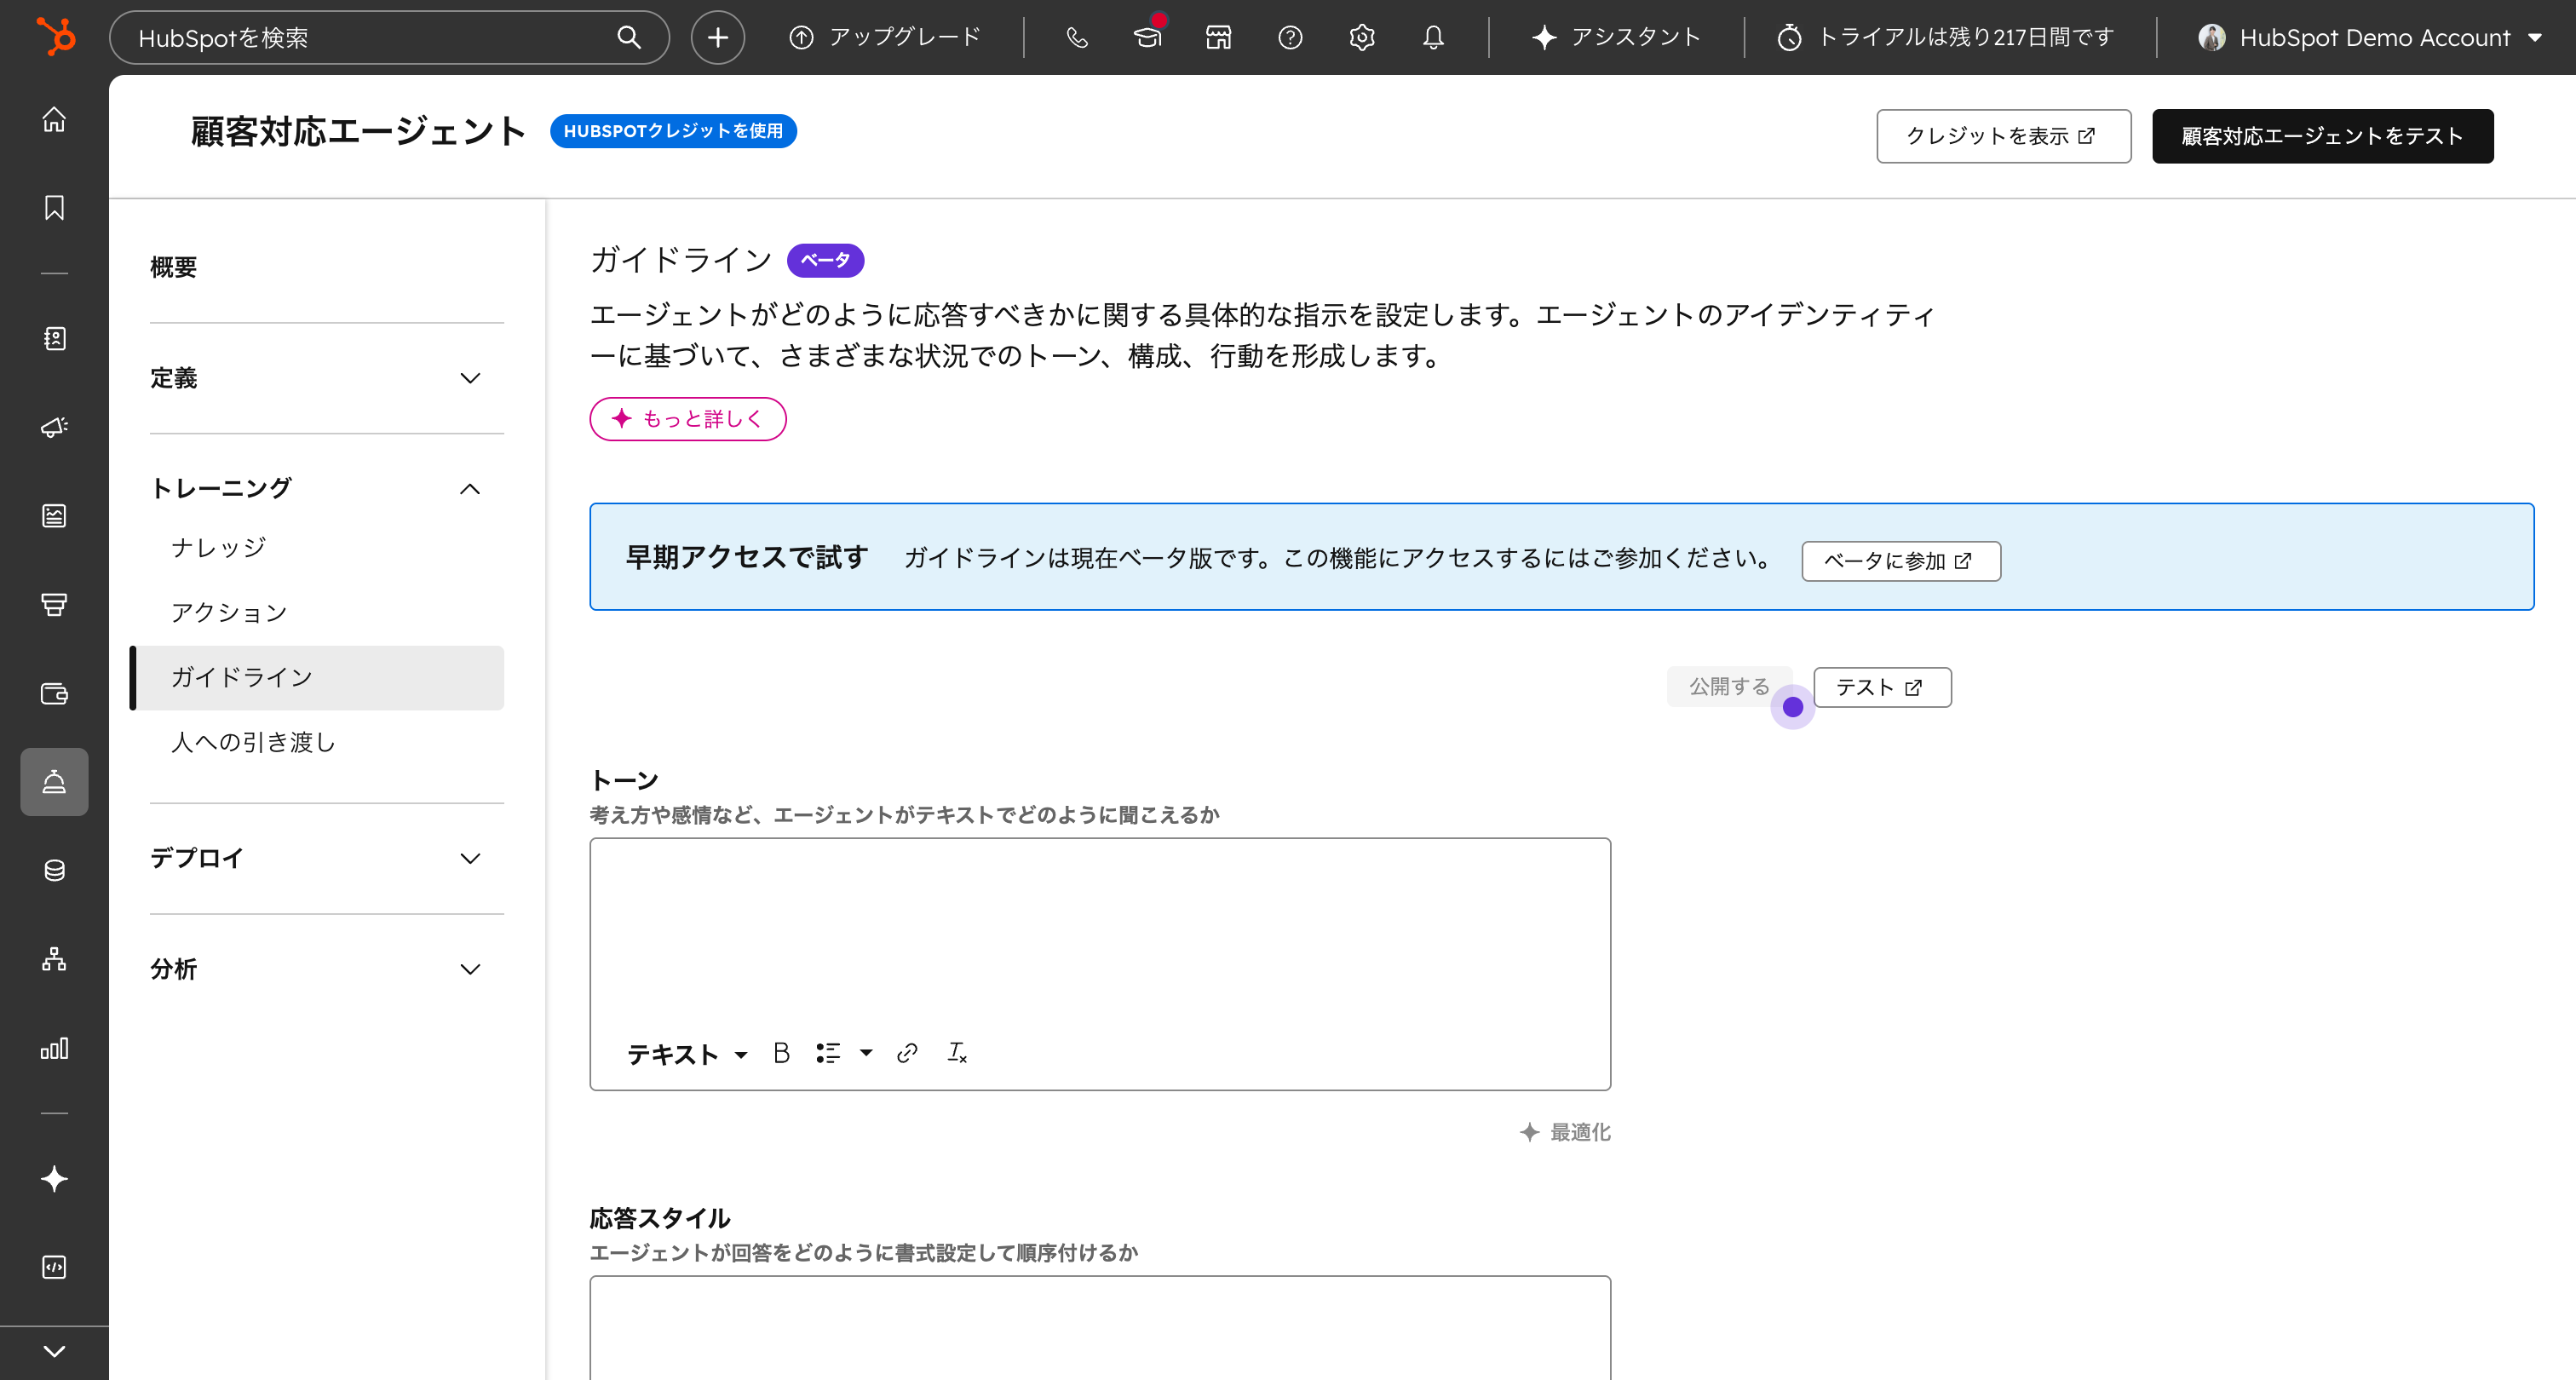
社内向けアシスタントを設計する場合も、「社内用語の初出には説明を添える」「分からないときは推測せず担当者を案内する」など、回答の方針を先に決められます。利用する環境で設定できる範囲は、実際の画面と仕様を確認してください。
オンボーディングで扱うナレッジは、次のように分類できます。
| カテゴリ | 内容例 | データソース |
|---|---|---|
| 会社・組織 | 組織図、各部署の役割、主要メンバー | 公式ドキュメント |
| ツール・環境 | 各ツールの設定方法、アクセス権限の申請方法 | IT部門のFAQとSlackの会話 |
| 業務プロセス | 承認フロー、レポートの書き方、会議体の説明 | 公式マニュアルとSlackの会話 |
| 暗黙のルール | 「この場合はこうする」「あのツールはこう使う」 | Slackの会話から抽出したFAQ |
| 専門知識 | 業界用語、技術スタック、製品知識 | ドキュメントとSlackの会話 |
会話から見つけた「暗黙のルール」は、現在の正式な運用と一致するか確認してからFAQにします。社内データを参照して回答を作る仕組みについては、「RAGとは?社内データ活用でAIの精度を高める仕組みと導入方法」で解説しています。
AIは候補の抽出や文章の下書きに使えます。一方、その内容を組織の知識として公開してよいかは、元の会話、現行のルール、公開範囲を確認したうえで人が決めます。
| 作業 | AIに任せる | 人が判断する |
|---|---|---|
| Q&A候補の抽出 | 会話から質問と回答の組を拾う | 抽出ルールの基準を決める |
| FAQ文案の作成 | 要約・一般化した下書きを作る | 公開してよいかを決める |
| カテゴリ分類 | 既存カテゴリへの振り分け | カテゴリ体系そのものを設計する |
| 社内ルールの説明 | 過去の会話をもとに説明を下書きする | ルールの解釈や例外の扱いを決める |
| 分析対象の範囲 | — | 取り込むチャンネルと除外するチャンネルを決める |
| 顧客に関わる回答 | 回答案を作る | 顧客に出してよい内容かを判断する |
カテゴリ体系や抽出基準は、組織と質問の内容に合わせて決めます。企業様によって最適な形は異なります。まず実際の質問を少数確認し、どの情報が必要とされているかを把握するところから始めます。
Slackの会話には、途中で結論が変わったスレッドや、特定の状況でだけ通用する回答もあります。AIが作ったFAQを公開する前に、元のスレッドと照合し、適用条件や公開範囲を確認します。
確認する人は、元の投稿者だけで足りるとは限りません。現行のルールを管理する担当者や、そのカテゴリのオーナーが承認する流れを決めておきます。
レビューや更新を特定の人の記憶だけに頼らないために、担当者、期限、引き継ぐ情報を明文化します。以下は運用を設計する際の比較例です。
| 運用の要素 | 人に頼る場合 | 仕組みで回す場合 |
|---|---|---|
| レビュー依頼 | 担当者が気づいたときに声をかける | 生成と同時に確認依頼のDMが自動で届く |
| 更新の判断 | 誰かが古さに気づいたら直す | 期限切れのFAQにフラグが付き、オーナーに通知される |
| オーナーの管理 | 詳しい人が暗黙に担う | カテゴリごとにオーナーを登録し、交代時は登録を差し替える |
| 引き継ぎ | 口頭と個人のメモで伝える | 抽出基準・カテゴリ体系・承認ルールを1つの運用ドキュメントにまとめる |
右列の仕組みを採用する場合も、通知先が退職・異動後に更新されるよう、オーナーの管理方法まで決めておきます。
会話を検索し、見つかった資料を参照して回答案を作る方法として、ベクトル検索とRAGを組み合わせる構成があります。RAG(検索拡張生成)は、回答の作成前に関連資料を検索する設計です。検索された内容が正しいとは限らないため、出典とアクセス権限の確認も必要です。
以下は構成を検討する際の選択肢です。製品の採用を推奨したり、特定の組み合わせの動作を保証したりするものではありません。
| コンポーネント | 選択肢 | 役割 |
|---|---|---|
| Embedding Model | OpenAI text-embedding-3-small / Cohere embed-v3 | テキストをベクトルに変換する |
| ベクトルDB | Pinecone / Weaviate / Qdrant / Chroma | ベクトルを保存し、意味の近さで検索する |
| LLM(回答生成) | Claude Sonnet / GPT-4o | 検索結果をもとに回答を生成する |
| オーケストレーション | LangChain / LlamaIndex | RAGの処理の流れを組み立てる |
選定時は、既存環境、扱うデータの範囲、アクセス権限、保守を担当する人を確認します。検索結果に利用者が閲覧できない会話を含めない設計も必要です。
次の表は、Slackの会話を検索対象にする場合の処理例です。取得できるデータと必要な権限を確認してから具体化します。
| 順序 | 処理 | 内容 |
|---|---|---|
| 1 | メッセージ取得 | Slack Conversations APIから日次バッチで取得する |
| 2 | 前処理 | メンションの除去、URLの正規化、Botの発言の除外 |
| 3 | チャンク分割 | スレッド単位でまとまりを作る |
| 4 | Embedding | ベクトルに変換してDBに格納する |
| 5 | メタデータ付与 | チャンネル名、投稿者、日時、リアクション数を付ける |
スレッド単位でまとめると、質問と返信の関係を保ちやすくなります。ただし、一つのスレッドで複数の話題を扱っている場合もあるため、実際の会話を見て分割方法を調整します。リアクション数は候補を並べる参考にはなりますが、回答の正しさを示す指標としては扱いません。
実装前には、取得する会話の種類と、利用環境に適用されるAPIの条件を確認します。
conversations.history が関係します(出典:conversations.history method|Slack API)conversations.replies が関係します(出典:conversations.replies method|Slack API)取得量を設計する際は、Rate limits|Slack APIも確認します。
次の表は、条件ごとに検討する設計例です。利用可能な履歴や取得条件は、導入する環境で確認してください。
| 状況 | 選ぶ設計 |
|---|---|
| 取り込むチャンネル数やメッセージ量が多い | リアルタイム取得ではなく夜間の日次バッチにし、前回以降の差分だけを取得する |
| スレッドでのやりとりが中心のチャンネル | 親メッセージを取得したあと、返信が付いたものだけ conversations.replies で追加取得する |
| 無料プランのワークスペース | 参照できる過去メッセージの期間に制限があるため、初回取り込みを早めに済ませ、以降は日次で蓄積する |
Slackの会話に顧客対応の判断理由が残っている場合は、担当者が必要なときに参照できる場所を考えます。HubSpotを使っているチームでは、顧客の記録と、判断の根拠になる社内ナレッジをどのように行き来するかが設計上の論点です。
顧客に関わる対応履歴と、複数の案件に共通する手順や判断基準は、用途が異なります。どちらをどこに記録し、担当者がどう参照するかを決めておくと、過去の経緯を確認しやすくなります。
SlackからFAQ候補を作る場合も、顧客固有の情報を一般向けのFAQに混ぜないよう確認します。社内だけで閲覧する情報と、顧客対応に使う回答案の公開範囲も分けて判断します。
顧客対応に関わるナレッジが必要になる場面を整理した例です。表の各段階で同じ仕組みを導入する必要はありません。
| 段階 | 使われるナレッジの例 | 活用の場面 |
|---|---|---|
| コンタクト(リード対応) | 問い合わせの振り分け基準、よくある質問への回答 | 初回対応の品質をそろえる |
| 取引 | 提案時の判断基準、過去の失注理由と対処 | 商談の進め方を担当者間で共有する |
| 顧客(サポート) | トラブル対応の手順、製品のよくある質問 | チケット対応で回答を探す時間を短くする |
| 請求 | 契約・請求に関する社内ルール | 例外対応の判断をそろえる |
まず、自社で同じ質問や確認が繰り返されている段階を特定します。HubSpotからの参照方法を考えるのは、その段階で使うFAQの内容と管理者が決まってからです。
参照先を検討する際は、次の画像も確認資料の一つになります。ただし、画像だけで現在利用できる入力ソース、連携範囲、アクセス権限は判断できません。導入環境で実際の設定を確認してください。
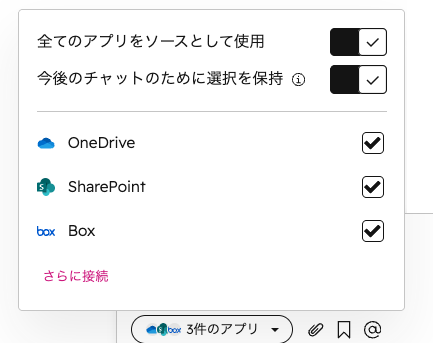
Slack由来のFAQを別の場所に保管する場合は、更新後の内容が参照先にどう反映されるか、閲覧権限が引き継がれるかを先に確認します。
NotionでFAQを管理している場合は、HubSpotでの問い合わせ対応中にその情報へたどり着く方法を検討できます。Sync for Notionを候補にする場合は、必要な参照方法や利用条件を製品ページで確認してください。HubSpotマーケットプレイスの掲載ページも参照できます。
次の画像は、Notionページの作成に関わるワークフローアクションを検討する際の参考です。FAQの参照や更新がこの画面だけで実現することを示すものではありません。
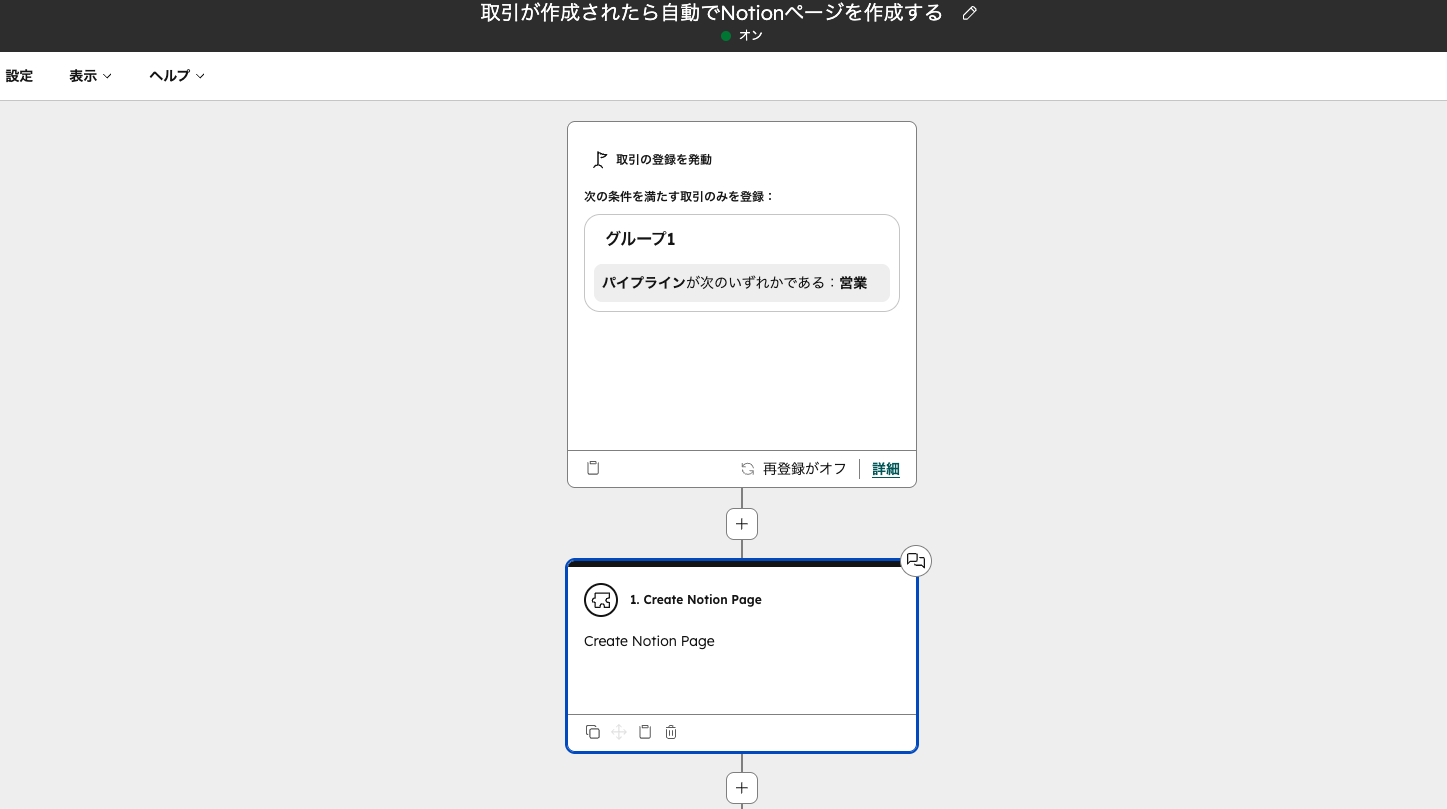
引用:Sync for Notion|ワークフローアクションでNotionページを自動作成
Slackの会話から作ったFAQを顧客対応に使うなら、連携方法に加えて、公開前の承認と更新時の責任者を決めることが必要です。
最初から全チャンネルを対象にせず、繰り返し質問が確認できる範囲で試すと、候補の品質やレビューの負担を確かめられます。以下は段階的な進め方の例です。
この段階では、候補が何件できたかだけでなく、どれを採用できたか、修正に何が必要だったかを確認します。誤った候補が多ければ、対象範囲や抽出方法を見直します。
提示したFAQが実際の質問に合っていたか、出典を確認できたかを記録します。候補が的外れな場合は、取り込む範囲や検索単位を見直します。
各段階の取り組みと、次に進む際に確認したい状態を表にまとめます。
| 段階 | 主な取り組み | 次に進む目安 |
|---|---|---|
| 第1段階 | 特定チャンネルのFAQ候補を生成し、人がレビューして登録する | FAQ候補の採用率が安定し、繰り返し質問の減少が見えてきた |
| 第2段階 | 日次取り込みと候補提示、オンボーディングのパイロット | 候補提示による自己解決のケースが増えてきた |
| 第3段階 | 承認フロー付きの自動化、アーカイブ、全社展開 | — |
表の目安は、導入結果を示すものではありません。次の段階へ進むかは、実際の記録とレビュー体制を見て判断します。
AIが会話を整理しても、元の情報に欠けている文脈や、公開してはいけない情報まで自動で判断できるとは限りません。導入前に、対象範囲と確認方法を決めておきます。
Slackの会話には、雑談、冗談、短い返信、途中で訂正された説明が含まれます。これらを前後の文脈なしに要約すると、誤ったFAQになる可能性があります。
次の対処を行います。
会話を分析対象にする前に、次の項目を決めます。
DMやプライベートチャンネルを扱うかどうかは、関係者の合意と組織のルールを確認したうえで慎重に判断してください。
初期段階では対象を限定し、分析対象から外す申し出を受ける方法も用意します。公開するFAQから個人情報や顧客固有の情報を除けるかも、レビューで確認します。
検索基盤の構築、AIの利用、継続的なレビューには費用と担当者の時間がかかります。小さな範囲で試し、候補の採用状況や質問対応の変化を確認してから、対象を広げるか判断します。
公開したFAQも時間とともに古くなります。作成日、確認日、オーナー、元の会話を記録し、更新が必要になったときに確認できるようにしておきます。
この節の要点は次のとおりです。
会話から候補を探し、人が確認してナレッジ化するという考え方は応用できます。ただし、取得できるデータ、権限、APIの条件はツールごとに確認が必要です。Microsoft Teamsでの取得方法を検討する場合も、利用環境の仕様を確かめてから設計してください。AIへの指示の書き方については「プロンプトエンジニアリング実践ガイド」で解説しています。
必要な量を一律には決められません。まず対象チャンネルの会話を少数確認し、繰り返される質問と、根拠を確認できる回答があるかを見ます。候補が少なければ、自動抽出を広げる前に、人がよくある質問をFAQにして型を作る方法があります。
技術的に取得できるかに加えて、そのデータを分析に使ってよいかを確認する必要があります。利用目的、対象者の合意、アクセス権限、除外方法を決めずに取り込まないでください。まず対象範囲を限定して運用を確かめる進め方が考えられます。
既存の置き場所にFAQを追加する場合は、重複確認、カテゴリ分け、公開前のレビュー、更新後の反映方法を決めます。自動投稿を検討するなら、利用する環境のAPIと権限を確認してください。HubSpotのチケット対応からNotionのFAQを参照したい場合は、Sync for Notionのような連携アプリも検討対象になります。
対象チャンネルを決め、導入前後で同じ質問が繰り返された回数や、FAQ候補の採用状況を記録します。新人向けなら、必要な情報にたどり着けたか、担当者への引き継ぎが必要だったかも確認できます。参照回数だけで成果を判断せず、回答が役立ったかを利用者と担当者の双方に確かめます。
Slackの会話からナレッジを作るには、候補を見つける仕組みと、内容を確認して維持する運用の両方が必要です。AIは抽出や下書きを支援できますが、会話の結論、現在のルールとの一致、公開範囲は人が確認します。
本記事の要点は次のとおりです。
まずは、同じ質問が繰り返されているSlackチャンネルを一つ選び、次の順序で試してください。
この記録が、ナレッジ化する領域と、仕組みを広げるかどうかを判断する材料になります。
CRMを活用した業務効率化やAIとの連携に関するご相談は、StartLinkまでお気軽にお問い合わせください。
このテーマと関連する内容を、次の記事でも詳しく解説しています。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。