この記事の結論
AI活用の壁は「モデルの賢さ」ではなく「どの仕事にどのモデルを置くか」という設計です。小規模言語モデル(SLM)は、定型業務をコストと速度で引き受ける“現場担当”として設計すると効きます。
AI活用の壁は「モデルの賢さ」ではなく「どの仕事にどのモデルを置くか」という設計です。小規模言語モデル(SLM)は、定型業務をコストと速度で引き受ける“現場担当”として設計すると効きます。
AI活用の壁は「モデルの賢さ」ではなく「どの仕事にどのモデルを置くか」という設計です。小規模言語モデル(SLM)は、定型業務をコストと速度で引き受ける“現場担当”として設計すると効きます。
「AIを業務に導入したいが、API料金が月額数十万円になるのではないか」
「問い合わせ分類くらいなら自動化したいが、機密データを外部に出したくない」
「モデルが多すぎて、どれを選べばいいのか判断できない」——
こうした声を、私たちはCRM導入の現場でよく伺います。小規模言語モデル(SLM)とは、パラメータ数を1B〜10B程度に抑え、少ない計算資源で高速に動作するよう設計された言語モデルです。分類・抽出・要約といった定型的なタスクであれば、パラメータ数が数十分の一でも実務に足る精度を出せるケースが多く、コスト・速度・データ管理の3点で選択肢になります。詳しくは「ファインチューニングの企業活用ガイド」で解説しています。
本記事では、SLMの基本概念から具体的なモデル選定基準、企業での活用パターンまでを体系的に解説します。AI活用完全ガイドで、AI活用の全体像を把握できます。
AI導入のコスト構造や選定基準に迷っている方に向けて、モデルの比較から自社業務への落とし込み方までを一つの流れとして整理しました。
AI導入のコスト負担を抑えつつ業務の自動化を進めたい、中小企業の経営者・DX責任者・情報システム部門の方に向けて書いています。最後まで読むと、自社の業務を棚卸しして「どのタスクをSLMに寄せ、どこから試すか」を自分で設計できるようになります。
SLMとLLMの違いは、しばしば「サイズが小さいか大きいか」だけで語られます。しかし実務で効いてくるのは、コスト構造・応答速度・データの置き場所という運用面の差です。ここを押さえておくと、モデル選定が「性能比較」から「業務設計」に変わります。まずは分類の基準から整理します。
言語モデルの規模は、パラメータ数によって大まかに分類されます。
| 分類 | パラメータ数 | 代表モデル | 推論コスト(目安) |
|---|---|---|---|
| 小規模(SLM) | 1B〜10B | Phi-3 Mini、Gemma 2 2B | 月額数千〜数万円 |
| 中規模 | 10B〜70B | Llama 3.1 70B、Mixtral 8x7B | 月額数万〜十数万円 |
| 大規模(LLM) | 70B以上 | GPT-4、Claude 3 Opus | 月額数十万〜数百万円 |
ここで重要なのは、パラメータ数が多いほど「賢い」とは限らないことです。Microsoftが開発したPhi-3 Miniは3.8Bパラメータでありながら、いくつかのベンチマークでLlama 3 8Bに匹敵するスコアを記録しています。少ないパラメータでも、学習データの品質と学習手法の工夫次第で高い性能を発揮できるのです。詳しくは「RAG構築の実践ガイド」で解説しています。
この事実が示すのは、「一番大きいモデルを選んでおけば安心」という選び方が、実はコストの取りこぼしになりやすいということです。業務ごとに必要な推論の深さは違うので、モデル選定は自社の業務内容から逆算するのが筋になります。
大規模LLMをAPI経由で利用する場合、トークン単価が高額になります。一方、Phi-3 MiniのようなSLMであれば、Azure AI Studioなどのマネージドサービス経由で、同種の定型タスクを大規模LLMのAPIより抑えた単価で処理できます。
自社サーバーやエッジデバイスでSLMを動作させれば、API利用料そのものがゼロになります。初期のハードウェア投資は必要ですが、リクエスト量が一定規模を超えると、API従量課金を続けるより累計コストが下がる分岐点が生まれます。
逆に言えば、月間のリクエストが数百件程度にとどまるうちは、API利用の方が運用負荷を含めて合理的な場合もあります。「SLMだから安く済む」ではなく、「処理量が一定を超えると構造が変わる」という理解の方が実務では役に立ちます。
SLMは推論に必要な計算量が少ないため、応答速度が速くなります。クラウドAPI経由の大規模LLMではネットワーク往復やキューイングの待ち時間が発生するのに対し、SLMをローカル環境で実行すれば、その待ち時間を構造的に削ることができます。
チャットボットやリアルタイムの顧客対応では、この速度差がユーザー体験を大きく左右します。応答が返るまでの待ち時間が長いほど利用者が離れやすくなるため、AI応答速度は体験品質の一部として扱うのが妥当です。
ただし、速度が価値になるのは「待たせると離脱する場面」に限られます。夜間のバッチ処理で数千件のデータを分類するような用途では、数秒の差は成果に影響しません。速度をモデル選定の第一基準にするかどうかは、その処理が同期か非同期かで決めるのがよいかなと思います。
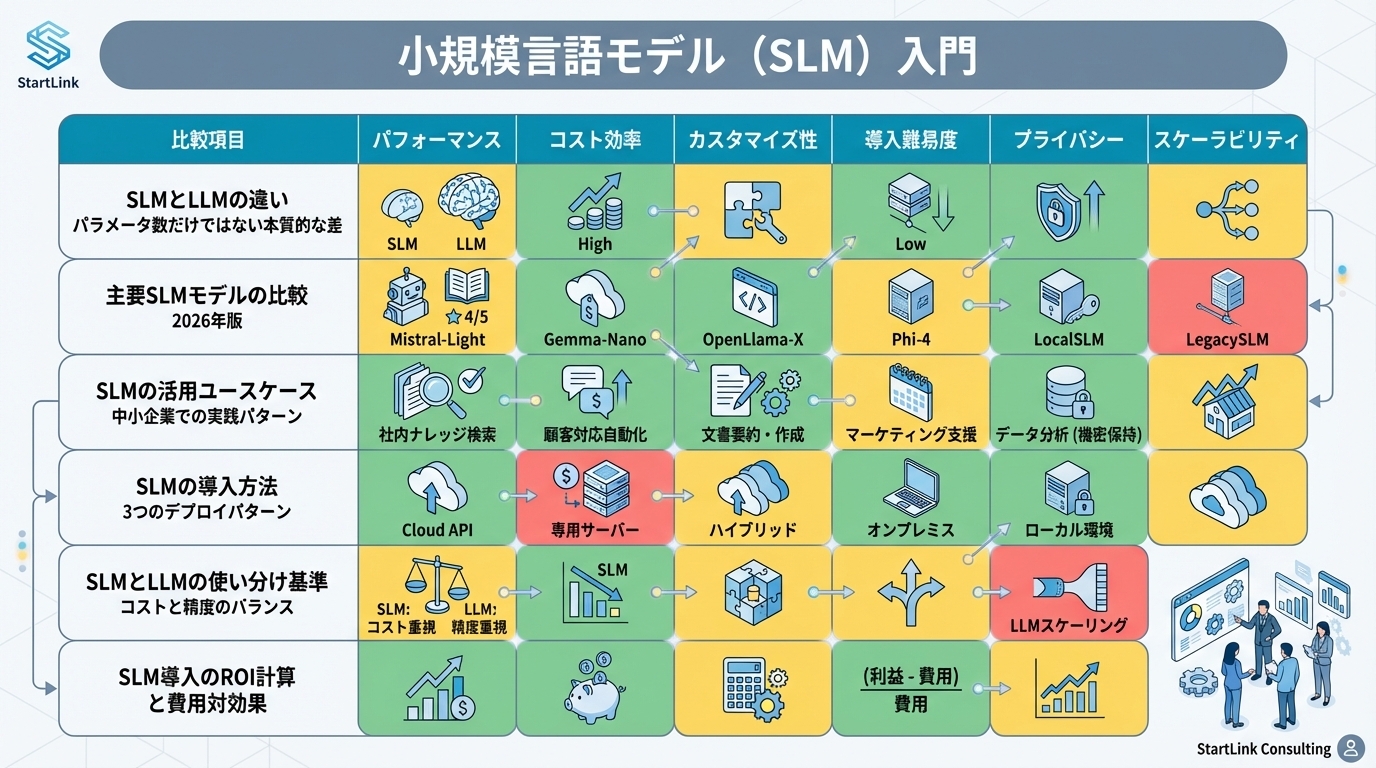
SLMは選択肢が多く、「どれが一番強いか」を追うと比較が終わりません。実務では、モデルの設計思想と自社の既存インフラとの相性で絞り込むのが早道です。ここでは代表的な4系統の特徴を、選定の観点から整理します。
MicrosoftのPhi-3シリーズは、SLMの代名詞ともいえるモデルです。次の3サイズが提供されており、用途に応じて選択できます。
Phi-3の最大の特徴は「教科書品質の合成データ」で学習されている点です。Webクロールで収集したノイズの多いデータではなく、構造化された高品質データで学習することで、少ないパラメータ数で高い推論能力を実現しています。Azure AI Studio、Ollama、ONNX Runtimeなど多様な環境で動作し、企業導入のハードルが低い点も強みです。
3サイズが揃っていることは、検証の進め方の面でも扱いやすさにつながります。まずMiniで精度を測り、足りなければSmall、Mediumへと段階的に上げていけるため、最初から大きいモデルを用意しなくても判断が進みます。
Googleが公開したGemma 2は、2B・9B・27Bの3サイズが提供されています。特に2Bモデルは、スマートフォンやIoTデバイスでも動作可能な軽量さが特徴です。
Gemma 2はGoogleのDeepMind技術をベースにしており、推論効率が高いモデルです。Google Cloud Vertex AI上でのデプロイが容易で、すでにGoogle Workspaceを利用している企業にとっては、既存のインフラとの親和性が高い選択肢になります。
モデル選定では、この「既存インフラとの親和性」が意外と効きます。認証・権限管理・請求をどこに寄せるかは運用の手間に直結するので、性能が近い候補が並んだときは、社内で既に使っているクラウドに合わせる判断も十分に合理的です。
Metaが公開したLlama 3.2には、1Bと3Bの小規模モデルが含まれています。オープンソースで商用利用可能な点が最大の強みで、ファインチューニングやカスタマイズの自由度が高いです。
Llama 3.2の小規模モデルは、テキスト要約・分類・情報抽出といった定型の業務タスクで実務に使える水準の精度が期待できるモデルです。自社データでファインチューニングすれば、特定ドメインではさらに高精度なモデルを構築できます。ファインチューニングの具体的な方法は「ファインチューニング実践ガイド」で詳しく解説しています。
ただし、カスタマイズの自由度が高いということは、その自由度を扱える体制が必要だということでもあります。学習データの整備・評価・再学習を誰が担うのかが決まっていないまま手を出すと、運用が止まりやすくなります。
Appleが公開したOpenELMは、iPhoneやiPadなどのAppleデバイス上での動作を想定した超軽量モデルです。270M〜3Bのラインナップがあり、オンデバイスAIの実現に向けた重要な選択肢です。
その他にも、Alibaba CloudのQwen2(0.5B〜72B)やStabilityAIのStableLM(1.6B〜12B)など、様々な企業・研究機関がSLMを公開しています。選択肢が多いため、自社の用途に合ったモデルを見極めることが重要です。
モデルを選ぶ順序としては、次の流れが実務的です。
カタログを端から比べるより、制約から絞る方が早く決まります。
SLMは単体で導入しても効果が見えにくく、既存の業務フローのどの工程を置き換えるのかを決めて初めて成果につながります。ここでは、比較的成果が出やすい3つの型を、業務の流れの中での位置づけとあわせて説明します。
カスタマーサポートの一次対応は、SLMが効果を発揮しやすい領域のひとつです。顧客からの問い合わせの多くは、FAQに記載済みの定型的な質問で占められるケースがよくあります。この定型応答をSLMに任せることで、人的リソースを複雑な問い合わせに集中させられます。
具体的な構成としては、Phi-3 MiniをRAG(Retrieval-Augmented Generation:検索で関連情報を引いてから回答を生成する手法)と組み合わせる方法が有効です。社内のFAQデータベースやマニュアルをベクトル化し、問い合わせ内容に関連する情報を検索してからSLMに回答を生成させます。この構成であれば、GPT-4のAPIを呼び出す場合と比較して、月額コストを大きく抑えられます。
ここで結果を左右するのはモデルの性能よりも、参照させるナレッジの品質です。FAQが古い・表記が揺れている・そもそも書かれていない状態では、どのモデルを選んでも回答は安定しません。モデル選定の前に、回答の根拠になるドキュメントを整える方が先になります。
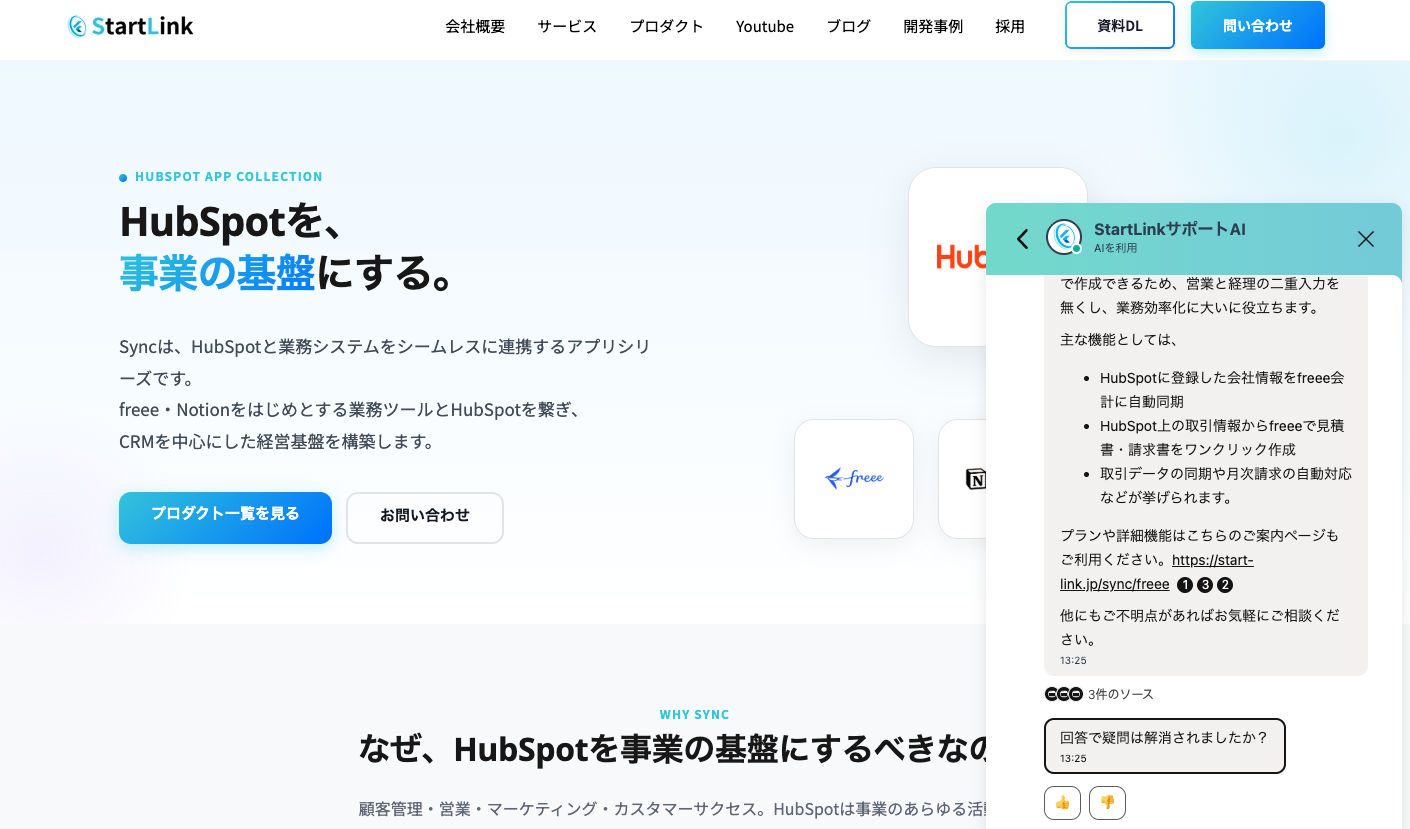
以下の画面は、当社サイトに設置しているサポートAIが、公開情報の範囲で製品の機能説明とページ案内を返している様子です。参照するナレッジの範囲を絞ることで、回答の予測可能性を確保しています。
社内に蓄積された議事録、提案書、報告書を要約・検索するタスクは、SLMで十分に対応可能です。ドキュメントを読み込んで「3行で要約して」「この報告書のリスク要因を抽出して」といったリクエストに応えるだけなら、3B〜7Bクラスのモデルで実用的な精度が出ます。
社内ドキュメントには機密情報が含まれるため、外部APIに送信したくないというニーズも多いです。SLMをオンプレミスで動かせば、データが社外に出ることなくAI活用を実現できます。ローカル環境でのLLM実行について詳しくは「ローカルLLM導入ガイド」をご覧ください。
この用途で見落とされがちなのが、要約した結果をどこに戻すかという設計です。要約がチャット画面の中だけに残ると、次の担当者には引き継がれません。商談の議事録要約であれば、CRMの取引レコードのノートに書き戻すところまでを一連の流れとして設計しておくと、情報が人ではなくシステムに溜まっていきます。
商談メモや顧客フィードバックを自動分類するタスクにも、SLMは向いています。たとえば、商談メモから「価格への懸念」「競合比較中」「導入時期未定」といったタグを自動付与することで、営業パイプラインの分析精度が向上します。
この分類が効いてくるのは、失注分析の場面です。失注理由が「価格」「競合他社」「製品機能」「時期」「社内決裁」といったカテゴリーで揃っていれば、レポートで傾向を見て、マーケティングや製品開発に共有できます。逆に、自由記述のメモがバラバラに残っているだけでは、集計ができず改善に回りません。分類の目的は「タグを付けること」ではなく、「レポートで見える形にして次の打ち手を決めること」にあります。
この用途では、自社の営業データでファインチューニングしたSLMが高い精度を発揮します。汎用LLMでは拾いきれない業界固有の表現やニュアンスを、自社データで学習させることで的確に分類できるようになります。ただし、そもそも入力されているメモが薄ければ、AIが何をどう分類しても精度は上がりません。取引ステージを進めるときに必要な情報を必須入力にするなど、データが自然に揃う仕組みを先に作っておくことが結構ミソになってきます。
SLMを「どこで動かすか」は、コストだけでなくセキュリティ要件と運用体制で決まります。ここではクラウド・オンプレミス・エッジの3パターンを、選定基準とあわせて整理します。企業様によって最適な形は異なりますので、自社の制約に当てはめて読んでいただければと思います。
最も手軽なのは、Azure AI Studio、Google Cloud Vertex AI、Amazon Bedrockなどのクラウドプラットフォーム経由でSLMを利用する方法です。インフラ構築が不要で、即日利用を開始できます。Claude Codeを使った経営データの可視化にも、こうした考え方が反映されています。
Azure AI StudioではPhi-3シリーズが、Vertex AIではGemma 2が、それぞれマネージドサービスとして提供されています。GPT-4やClaude 3のAPIを利用する場合と比較して、トークン単価が抑えられます。
最初の検証はこのパターンから始めるのが現実的です。精度が業務に耐えるかどうかは実データを通さないと分からないので、インフラ投資の前に「そもそも使えるのか」を確かめる段階として位置づけるとよいかなと思います。
Ollama、llama.cpp、vLLMなどのツールを使えば、自社サーバーやローカルPCでSLMを実行できます。データが社外に出ないため、セキュリティ要件が厳しい業種(金融・医療・官公庁)に適しています。
必要なハードウェアスペックの目安は以下のとおりです。
| モデルサイズ | 必要GPU VRAM | 推奨GPU | 概算費用 |
|---|---|---|---|
| 1B〜3B | 4GB以上 | NVIDIA RTX 3060 | 約5万円 |
| 7B〜8B | 8GB以上 | NVIDIA RTX 4070 | 約10万円 |
| 13B〜14B | 16GB以上 | NVIDIA RTX 4090 | 約25万円 |
量子化(Quantization:モデルの数値精度を落として軽量化する手法)を適用すれば、必要なVRAMをさらに削減できます。4bit量子化を適用した7Bモデルであれば、4GBのVRAMでも動作可能です。
ただし、このパターンは機材が揃えば終わりではありません。モデルの更新、障害時の切り分け、ログの保全までを誰が見るのかが決まっていないと、導入した人が異動した時点で止まります。運用担当を1人の属人作業にせず、手順を文書化して引き継げる形にしておくことが前提になります。
スマートフォン、タブレット、IoTデバイスなどのエッジデバイスでSLMを実行するパターンです。ネットワーク接続が不安定な環境や、リアルタイム性が求められる用途に適しています。
AppleのCore ML、GoogleのMediaPipe、QualcommのAI Engineなどのフレームワークを使えば、モバイルデバイス上でSLMを動作させられます。建設現場での安全点検、物流倉庫でのピッキング指示、店舗での接客支援など、現場で即座にAI推論が必要なシーンで力を発揮します。
3パターンの選び分けは、次の表のように整理できます。
| 判断軸 | クラウドAPI | オンプレミス | エッジデバイス |
|---|---|---|---|
| 立ち上げの速さ | 即日〜数日 | 数週間 | 数週間〜 |
| データの所在 | クラウド事業者に依存 | 社内に留まる | 端末内に留まる |
| 向く処理量 | 少量〜中量 | 中量〜大量 | 現場単位の都度処理 |
| 必要な体制 | API実装ができる担当 | サーバー運用ができる担当 | アプリ開発の担当 |
| 主な用途 | 精度検証・小規模運用 | 機密データの常時処理 | オフライン・即応が必要な現場 |
すべてのタスクを一つのモデルで処理しようとすると、どこかで無理が出ます。簡単な仕事に高価なモデルを使えば費用が膨らみ、複雑な仕事に軽量モデルを使えば品質が落ちます。ここでは、タスクの性質でモデルを振り分ける考え方を整理します。
以下のタスクはSLMで十分な精度が得られるケースが多いです。
共通しているのは、「正解の形があらかじめ決まっている」タスクだという点です。出力先のプロパティや選択肢が定義されていれば、モデルはその枠に当てはめるだけで済むため、小さいモデルでも安定します。
以下のタスクは、大規模LLMの方が明らかに優れた結果を出します。
モデルの大小に関わらず、AIに任せてよい工程とそうでない工程があります。私たちがAI活用の設計でよく使う線引きは次のとおりです。
| AIに任せる(SLMで十分なことが多い) | 人が判断する |
|---|---|
| 問い合わせの種別分類 | 顧客への最終的な回答の送信可否 |
| 商談メモの要約・タグ付け | 商談ステージを進めるかどうかの判断 |
| 失注理由のカテゴリー割り当て | 失注理由を踏まえた次の打ち手の決定 |
| 重複データの検出・整形 | 営業プロセスや評価軸そのものの設計 |
| 定型FAQへの一次応答 | クレーム対応・金額規模の大きい案件の対応 |
ポイントは、自律送信のような「AIが最後まで完結する」設定をいきなり有効にしないことです。分類や下書き生成までをAIに任せ、外部に出る内容は人が確認してから出す。この順序を守るだけで、導入初期のリスクはかなり下げられます。
実務では、SLMとLLMを組み合わせた「ハイブリッド構成」がコスト効率に優れます。具体的には、まずSLMで一次処理(分類・抽出・簡易応答)を行い、SLMで対応できない複雑なリクエストのみをLLMにエスカレーションする構成です。
たとえばカスタマーサポートでは、SLMが問い合わせを分類し、定型的な質問にはSLMが直接回答、複雑な質問や感情的なクレームのみをLLMに転送するというフローが考えられます。この構成にすることで、LLMのAPI利用量を抑えつつ、顧客満足度を維持しやすくなります。
この振り分けを、担当者の勘ではなくルールとして書き下ろしておくことが大事です。「この条件ならSLM、この条件ならLLM、この条件なら人」という基準が文書化されていれば、新しく入ったメンバーでも同じ判断ができますし、精度が落ちたときに原因の切り分けもできます。
SLMは単体のツールとして置くより、顧客データの流れ(コンタクト獲得 → 商談 → 受注 → 顧客フォロー)の中に組み込んだ方が成果が出ます。ここでは、HubSpotを使っている場合を例に、どの工程にAI処理を差し込むかを整理します。
問い合わせ対応や商談管理をスプレッドシートで運用していると、AIを入れたくても差し込む場所がありません。問い合わせの一覧はスプレッドシート、やり取りはメールとチャット、提案書はクラウドストレージ、と情報が分散しているため、AIに読ませる対象も出力の戻し先も定まらないからです。
AI活用の前提は、データが1か所に集まっていることです。コンタクト・会社・取引・チケットが紐づいたCRMに情報が集約されていれば、「取引レコードに紐づく直近のやり取りを要約して、プロパティに書き戻す」といった処理が自然に組めます。AI導入の第一歩が、実はデータの一元管理になるというのは、現場でよく起きることです。
HubSpotのワークフローを使うと、トリガー(フォーム送信、取引ステージの変更など)をきっかけに、AIによる処理を挟んでプロパティを更新する流れを組めます。たとえば次のような形です。
| 工程 | トリガー | AIが行う処理 | 結果の保存先 |
|---|---|---|---|
| リード獲得 | 問い合わせフォーム送信 | 内容を「商談希望/サポート/営業提案」に分類 | コンタクトのプロパティ |
| 商談中 | 商談メモの追加 | メモを要約し、懸念点をタグ化 | 取引のプロパティ・ノート |
| 失注時 | 取引ステージが「失注」に変更 | 失注理由をカテゴリーに割り当て | 取引の失注理由プロパティ |
| 顧客フォロー | サポート問い合わせ受信 | FAQを参照して一次回答案を作成 | チケットの下書き |
重要なのは、AIの出力をチャット画面に残さず、CRMのプロパティに落とすことです。プロパティに入っていれば、そのままレポートで集計できます。失注理由がカテゴリーで揃っていれば円グラフにでき、営業とマーケティングで同じ数字を見ながら改善の議論ができます。
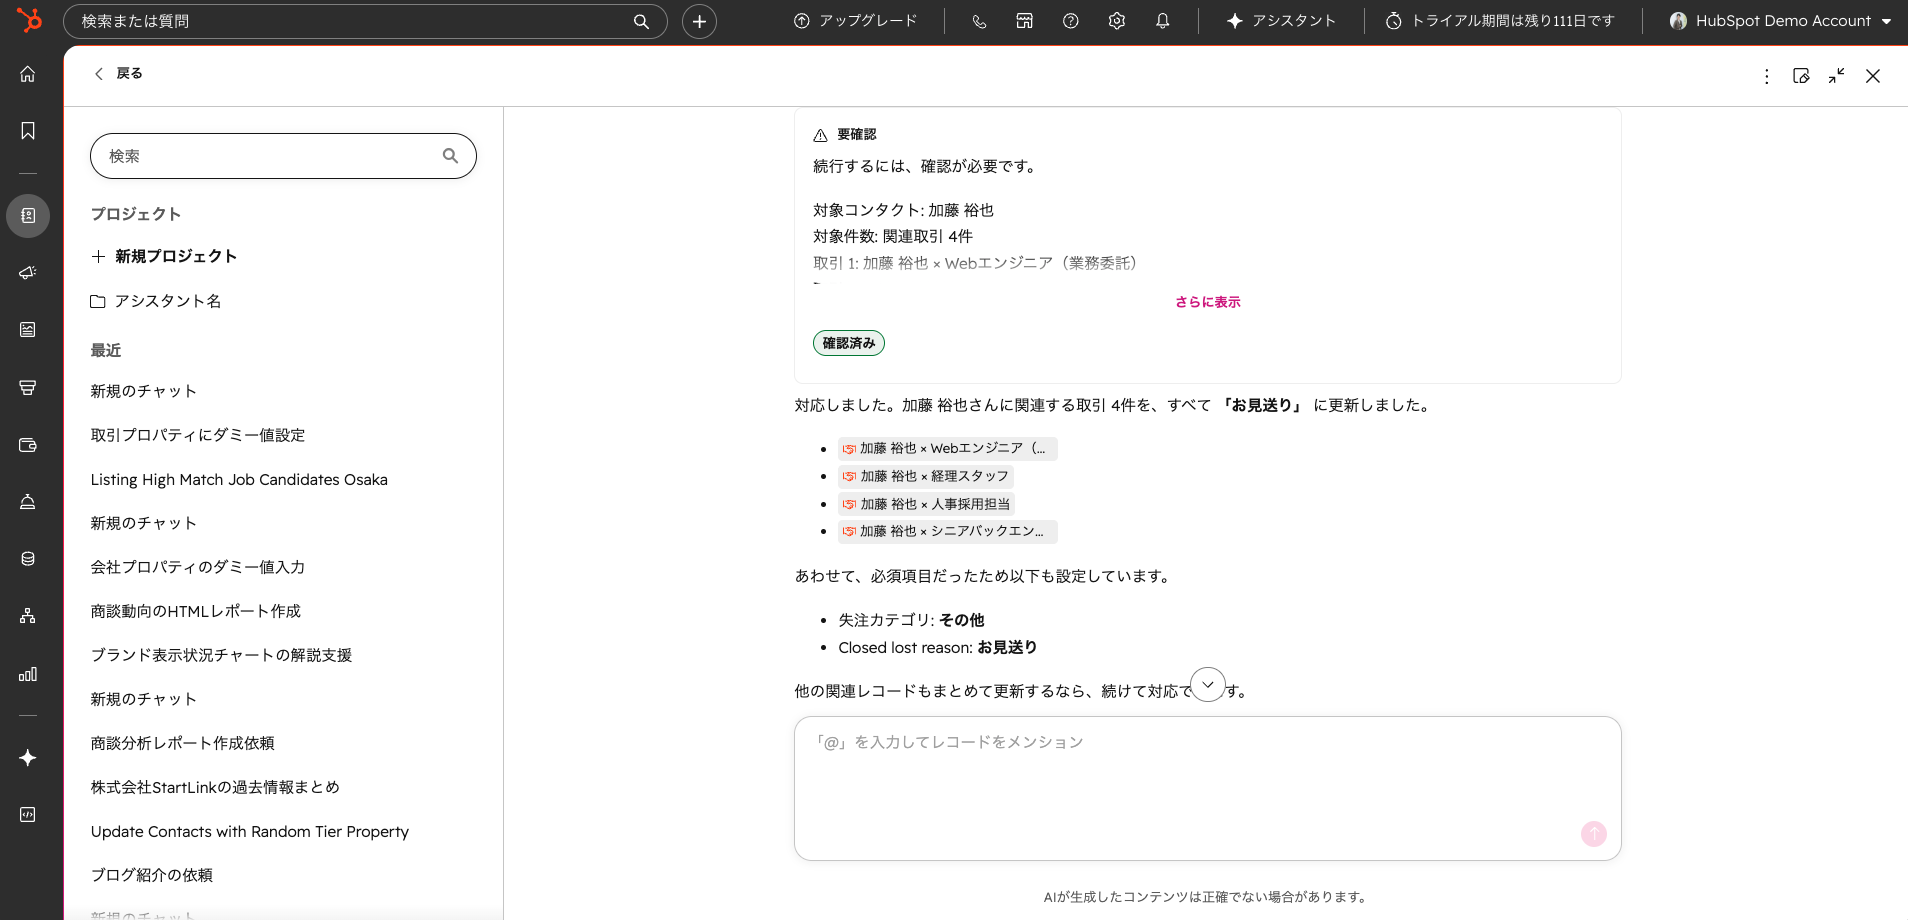
以下の画面は、AIがCRM上の複数レコードのプロパティを一括で更新している様子です。こうして更新された値は、そのまま集計やレポートに反映されます。
AIに分類させる以上、分類先の選択肢が定義されていなければ結果は散らばります。失注理由なら「価格」「競合他社」「製品機能」「時期」「社内決裁」のように、集計して意味のある粒度で選択肢を決めておく必要があります。
ここで気をつけたいのが、項目を増やしすぎないことです。SFAでよくあるのが、使っていない項目が大量に並び、実際に見ているのは一部だけという状態です。項目が少ない方が入力も分析も集中できますし、AIの分類精度も安定します。プロパティは最小限から始めて、運用しながら足りないものを足していく方が結果的にうまくいきます。
なお、こうした構成はHubSpotに限った話ではありません。コンタクト・会社・取引がリレーションで紐づくCRMであれば、同様の設計は可能です。大事なのは製品名ではなく、データが1か所に集まり、AIの出力がそこに書き戻される構造になっているかどうかです。
導入判断では、削減できるコストだけでなく、追加で発生する運用負荷も並べて見る必要があります。ここでは概算の比較と、率直に言ってSLMが向かない場面を整理します。
月間10万件のテキスト分類タスクを処理する場合のコスト比較を示します。
| 方式 | 月額コスト(概算) | 応答速度 | データセキュリティ |
|---|---|---|---|
| GPT-4 API | 約30万〜50万円 | 3〜10秒 | データが外部に送信される |
| GPT-3.5 Turbo API | 約3万〜5万円 | 1〜3秒 | データが外部に送信される |
| SLM(クラウド) | 約1万〜3万円 | 0.5〜2秒 | クラウド事業者に依存 |
| SLM(オンプレミス) | 初期投資のみ(電気代月数千円) | 0.1〜1秒 | データが社外に出ない |
月間10万件規模のタスクであれば、SLMのオンプレミス運用に切り替えることで、処理にかかる費用の構造を大きく変えられます。ただしこの表には、モデルの更新や監視にかかる人的な工数は含まれていません。実際の比較では、そこまで含めて判断する必要があります。
SLM導入を検討する際は、以下の点を事前に確認しましょう。
正直に書くと、次のような場合はSLMを選ばない方がよいと考えています。
| 向かないケース | 理由 |
|---|---|
| 処理件数が月数百件程度 | 運用工数の方が費用を上回りやすい |
| 出力の正解が定義しづらい業務 | 分類先が曖昧だと精度を評価できない |
| 日本語の微妙なニュアンス判断が成果を左右する | 学習データに占める日本語の割合が少なく、追加調整の負荷が大きい |
| 運用を担える人が社内に1人もいない | 更新・障害対応で止まり、属人化する |
| 参照させるドキュメントが整っていない | モデルを変えても回答品質は改善しない |
こうした場合は、まず業務のルールとデータを整えるところから着手した方が、結果的に早く成果に届きます。AIは、整っていない業務を整えてはくれません。
いきなり全社展開を目指すと、検証も合意形成も止まりがちです。私たちがAI活用の支援でお勧めしているのは、効果が見えやすい業務をひとつ選んで小さく回し、成果を確認してから範囲を広げる進め方です。
最初に選ぶべきは、「毎日発生し」「正解が明確で」「失敗しても被害が小さい」業務です。問い合わせフォームの種別分類や、商談メモの要約あたりが典型的な候補になります。この段階ではクラウドAPI経由でPhi-3やGemma 2の小さいモデルを使い、インフラ投資はしません。
一致率が業務で許容できる水準かどうかを、感覚ではなく数字で確認するのがポイントです。
精度に目処が立ったら、CRMのワークフローに組み込み、出力をプロパティに書き戻すところまでを作ります。ここまでやって初めて、AIの処理結果がレポートで見える状態になります。
同時に、人のレビュー工程も決めます。外部に送る文面は人が確認する、分類結果は週次でサンプルチェックする、といったルールを最初に定めておくと、後から運用が崩れにくくなります。
1つ目の業務で成果が確認できたら、隣接する業務に広げます。処理件数が増えてAPI費用が目立ってきた段階で、初めてオンプレミス運用やファインチューニングを検討するという順序です。最初から大きく作らないことで、途中で方針を変える余地を残せます。
なお、当社自身もサイト上のサポートAIで、参照するナレッジの範囲を絞った状態から運用を始めています。回答できる範囲を限定してから広げる方が、期待値のズレを起こしにくいためです。
| ステップ | やること | 判断する指標 |
|---|---|---|
| 1. 検証 | 1業務を選び、クラウドAPIで精度を測る | 人の分類との一致率 |
| 2. 組み込み | ワークフローに組み込み、結果をプロパティに保存 | 処理件数・レビュー時の修正率 |
| 3. 拡張 | 隣接業務へ展開、必要ならオンプレミス化 | 月間処理量・運用工数 |
クラウドAPI経由であれば、REST APIを呼び出せるレベルの技術力で利用を開始できます。Azure AI StudioやVertex AIにはGUI操作でモデルをデプロイできる機能もあり、専門知識がなくても導入可能です。オンプレミス運用の場合は、サーバー管理とPythonの基本的なスキルが必要になります。まずはクラウドで試し、必要性が明確になってから環境を移す順序をお勧めします。
タスクの種類によります。テキスト分類や情報抽出のような定型タスクでは、SLMでも実務に足る精度を出せるケースが多い一方、複雑な推論や長文生成ではLLMに劣ります。導入前にプロトタイプで精度検証を行い、自社の業務で許容できる水準かどうかを確認することを推奨します。判断基準は「一般的な精度」ではなく「自社データでの一致率」で持つのがよいかなと思います。
一般的な方法は「ルーティング」です。次のような仕組みを構築します。
この振り分けロジック自体をSLMで実行するのが効率的です。切り替え条件は担当者の判断に委ねず、明文化してワークフローに落としておくと、担当が変わっても同じ動きを再現できます。
SLMは学習データに占める日本語の割合が少ないため、英語と比較すると日本語の精度はやや低い傾向にあります。ただし、日本語データでファインチューニングを行えば改善が期待できます。Llama 3.2やQwen2は日本語対応が比較的良好で、日本語のベンチマークでも高いスコアを記録しています。敬語やビジネス上の言い回しについては、プロンプトで明示的に指示しておくと出力が安定しやすくなります。
SLMは各社が継続的に開発を進めている領域で、新しいバージョンや派生モデルが比較的早いサイクルで公開される傾向があります。ただし、自社でファインチューニングしたモデルは、ベースモデルの更新に合わせて再学習が必要になる場合があります。誰がいつ更新し、精度をどう再評価するかまでを含めた運用設計を、導入時に決めておくことが重要です。
小規模言語モデル(SLM)は、大規模LLMの「コストが高い・応答が遅い・データを外部に出したくない」という3つの課題に対する現実的な選択肢です。本記事で整理した要点は次のとおりです。
企業様によって最適な形は異なります。扱うデータの機密性、月間の処理件数、社内の技術体制によって、選ぶべきモデルもデプロイ先も変わってきます。まずは自社の業務を棚卸しして、「毎日発生する定型作業」をひとつ選ぶところから始めていただければと思います。
次の一歩として、以下の3つを進めてみてください。
このテーマの全記事はAIテックトレンドガイドでご覧いただけます。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
記事の内容を、そのまま実務に落とし込みたい方向け
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。