
この記事の結論
CRMデータクレンジングは、汚れたデータを掃除する後処理ではなく、データ品質を保ち続ける仕組みづくりです。
CRMデータクレンジングは、汚れたデータを掃除する後処理ではなく、データ品質を保ち続ける仕組みづくりです。
HubSpotゴールドパートナーのStartLinkが、HubSpot導入・AI活用・CRM整備・業務効率化までをまとめて支援しています。記事で気になったテーマを、そのまま相談ベースで整理できます。
CRMデータクレンジングは、汚れたデータを掃除する後処理ではなく、データ品質を保ち続ける仕組みづくりです。
「CRMに重複レコードが増え続けて、どれが正しいデータかわからない」「営業が入力するデータの表記がバラバラで、レポートの数字が信用できない」「名寄せをしたいが、どこから手をつければいいのか見当がつかない」——CRM運用が軌道に乗り始めた企業ほど、こうしたデータ品質の問題に直面します。
CRMデータクレンジングとは、CRMに蓄積されたデータの誤り・重複・不整合・欠損を検出し、修正・統合・補完する一連のプロセスを、継続的な仕組みとして運用に組み込む取り組みのことです。CRMは「入力→蓄積→活用」のデータサイクルで価値を発揮しますが、このサイクルが回り続けるためには、蓄積されるデータの品質を維持・向上させる仕組みが不可欠です。CRM導入の進め方の段階からデータ品質を意識した設計を行うことが、運用定着の鍵を握ります。
Excelやスプレッドシートで顧客リストを管理していた時期に、ファイルごとの表記ゆれや担当者マスターとの差分に悩まされた経験がある方も多いのではないでしょうか。CRMに移行しても、クレンジングの仕組みがなければ同じ問題がCRMの中で再発します。本記事では、名寄せの考え方、重複管理の仕組み、データ品質が劣化する原因とその対策、そしてHubSpotにおける実装パターンまで、CRM設計者・運用担当者がすぐに活用できる知見を体系的にお伝えします。前提となる考え方はCRM/SFA導入ガイドで解説しています。
CRMの設計・運用を担当される方に向けて、データクレンジングを「考え方」「仕組み」「実装」「運用」の順に整理してお伝えします。
CRMの導入設計や運用改善を検討しているBtoB企業のマーケティング・営業企画・RevOps担当者の方に向けて書いています。最後まで読むと、自社のデータ品質を測定し、クレンジングの仕組みを設計して運用に載せるまでの一連の流れを描けるようになります。
CRMの価値は、コンタクトの獲得から取引・顧客管理へと続く一気通貫のデータの流れの中で生まれます。その流れの土台にある「蓄積されたデータ」の品質を守るのがデータクレンジングです。まず定義と基本アクション、データベース設計との関係を整理します。
データクレンジングとは、CRMに蓄積されたデータの誤り・重複・不整合・欠損を検出し、修正・統合・補完する一連のプロセスのことです。日本語では「データ浄化」「データクリーニング」とも呼ばれます。
ここで重要なのは、データクレンジングは「一度やって終わり」のプロジェクトではなく、CRM運用に組み込む継続的な仕組みであるという点です。データは日々入力・更新・インポートされるため、品質は放置すれば少しずつ劣化していきます。クレンジングを一回限りのイベントとして捉えるのではなく、運用プロセスの一部として設計することが、データ品質を持続的に維持するための前提条件です。
データクレンジングは、以下の4つの基本アクションに分解できます。
| アクション | 目的 | 具体例 |
|---|---|---|
| 修正(Correction) | 誤ったデータを正しい値に修正する | 誤字脱字の修正、電話番号のフォーマット統一、住所の正規化 |
| 統合(Merge) | 重複するレコードを1つに統合する | 同一人物の複数コンタクトレコードの統合、同一企業の重複レコードのマージ |
| 補完(Enrichment) | 欠損している情報を補う | 業種情報の追加、従業員数の補完、企業ドメインの紐付け |
| 削除(Deletion) | 不要なデータを除去する | バウンスメールアドレスの削除、テストデータの除去、明らかな無効レコードの除外 |
この4つのアクションを体系的に設計し、運用に組み込むことがデータクレンジングの全体像です。
CRMデータベース設計の基本では、「オブジェクト」「プロパティ」「関連付け」の3つの構成要素による設計思想を解説しました。データベース設計が「きれいなデータを蓄積するための器」を整える作業だとすれば、データクレンジングは「器に入ったデータの品質を維持する」ための仕組みづくりです。
どれほど優れた設計をしても、運用の中でデータは汚れていきます。入力ミス、表記ゆれ、重複作成、情報の陳腐化は避けられません。だからこそ、設計と並行してクレンジングの仕組みを組み込むことが、CRM運用の成功に不可欠なのです。
データクレンジングの具体的な手法に入る前に、なぜデータ品質が劣化するのかを理解しておく必要があります。原因を正確に把握していなければ、対策は対症療法に留まります。データ品質が劣化する原因は、以下の5つに集約されます。
原因1:入力ルールの不在・不徹底
データ品質劣化の根本的な原因のひとつは、入力ルールが定められていない、あるいは定めていても徹底されていないことです。
例えば、会社名の入力ひとつをとっても、「株式会社」を前につけるか後につけるか、「(株)」と略すか、英語表記と日本語表記のどちらを使うか。こうしたルールが不明確だと、同じ企業が「株式会社ABC」「ABC株式会社」「(株)ABC」「ABC Inc.」として複数レコード登録されます。結果として、名寄せが困難になり、レポートの数値が分散し、正確な全体像が把握できなくなります。
入力ルールの問題は、プロパティのフィールドタイプとも密接に関係します。自由記述(テキスト)フィールドが多いほど入力のバラつきが増え、選択式(ドロップダウン、ラジオボタン等)フィールドが多いほどデータの一貫性が保たれます。ただし、選択肢が現実の業務と乖離していると「その他」に集中したり、そもそも入力されなかったりするため、選択肢の設計自体にも注意が必要です。
原因2:重複レコードの発生
重複レコードは、CRMにおけるデータ品質問題の中でも発生しやすく、影響が大きくなりやすい問題です。重複が発生する主な経路は以下の通りです。
重複レコードの問題は、単に「同じレコードが2つある」にとどまりません。情報が分散し、どのレコードが「正」かわからなくなることが本質的な問題です。ある担当者の活動履歴が2つのレコードに分かれていれば、その人との関係性の全体像が見えなくなります。片方の営業が知っている情報をもう片方が知らない、という事態が発生します。
ビジネスの世界では、情報は常に変化しています。担当者の異動・退職、企業の合併・社名変更、電話番号やメールアドレスの変更。こうした変化に対応しなければ、CRMに蓄積されたデータは時間とともに実態と乖離していきます。
何も手を打たなければ、データベースの中身は年々実態と合わなくなっていきます。この経年劣化への対策を怠ると、メール配信のバウンス率が上がり、営業が古い情報を元にアプローチして信頼を損なうリスクが生じます。
展示会で獲得した名刺データ、購入したリストデータ、他システムからの移行データなど、外部からデータを取り込む場面はCRM運用において頻繁に発生します。このとき、外部データの品質がそのままCRM全体のデータ品質に影響します。
外部データには、表記ゆれ、フォーマットの不統一、不正確な情報、古い情報が含まれていることが多くあります。これらを無検証でインポートすると、それまで維持してきたデータ品質が一気に劣化します。「インポートは品質リスクの最大の入口」と認識し、取り込み前のクレンジングプロセスをあらかじめ設けておくことが重要です。
運用開始当初はルールが守られていても、担当者の異動や組織の拡大に伴い、ルールが属人化・形骸化するケースが多く見られます。
運用ルールの設計と維持についてはCRM運用ルール設計ガイドで詳しく解説していますが、ここではルールの形骸化がデータ品質劣化の構造的な原因になるという点を強調しておきます。
データクレンジングの設計にあたっては、まず「データ品質とは何か」を定量的に定義する必要があります。品質の定義が曖昧なままでは、改善の進捗を測定できず、取り組みが形骸化します。ここでは評価の軸と、それを一覧化するスコアカードの設計を紹介します。
| 評価軸 | 定義 | 測定指標の例 |
|---|---|---|
| 正確性(Accuracy) | データが実態を正しく反映しているか | メールバウンス率、電話番号の有効率 |
| 完全性(Completeness) | 必要な項目が埋まっているか | 必須プロパティの入力率、関連付け率 |
| 一貫性(Consistency) | データの表記・形式が統一されているか | 表記ゆれの発生率、フォーマット不一致率 |
| 一意性(Uniqueness) | 重複レコードが存在しないか | 重複レコード数、重複率 |
| 鮮度(Timeliness) | データが最新の状態に保たれているか | 最終更新日からの経過日数、情報更新率 |
| 有効性(Validity) | データが定められた形式・ルールに適合しているか | メールアドレスの形式チェック通過率、電話番号の桁数適合率 |
上記の6つの評価軸を組み合わせて、データ品質スコアカードを設計することをおすすめします。スコアカードとは、データ品質の状態を定量的に一覧化し、定期的にモニタリングするための指標体系です。
例えば、以下のような形式です。
| 指標 | 対象オブジェクト | 目標値 | 測定方法 |
|---|---|---|---|
| メールアドレス入力率 | コンタクト | 95%以上 | レポートで未入力コンタクトの割合を集計 |
| 会社との関連付け率 | コンタクト | 90%以上 | 会社未関連付けコンタクトの割合を集計 |
| 重複レコード率 | コンタクト・会社 | 3%以下 | 重複管理ツールで検出された候補の割合 |
| 業種プロパティ入力率 | 会社 | 80%以上 | レポートで未入力レコードの割合を集計 |
スコアカードは月次で確認し、目標値を下回った項目に対してアクションを講じるサイクルを回します。これにより、データ品質の改善が「感覚」ではなく「数値」に基づくものになります。目標値はあくまで例であり、企業様によって最適な形は異なりますので、自社の業務で本当に必要な項目から設定してみてください。
名寄せとは、同一の実体(人物・企業)を指す複数のレコードを特定し、1つのレコードに統合するプロセスです。CRMデータクレンジングにおいて、名寄せは技術的な難度が高く、ビジネスインパクトも大きい領域です。ここでは一意キーの定義、マッチングのアプローチ、統合時のルールの3点を整理します。
名寄せの設計で最初に決めるべきは、何を基準に「同一」と判断するかという一意キー(ユニークキー)の定義です。
| オブジェクト | 推奨一意キー | 補助キー(併用推奨) | 注意点 |
|---|---|---|---|
| コンタクト | メールアドレス | 氏名+会社名、電話番号 | 共有アドレス(info@等)は別扱いにする |
| 会社 | 企業ドメイン | 正式社名、法人番号 | グループ企業で同一ドメインを使うケースに注意 |
| 取引 | 取引名+会社名+時期 | 外部案件ID | 命名規則の統一が前提 |
HubSpotの場合、コンタクトはメールアドレスを一意キーとして自動的に重複を防ぐ仕組みがあります。同じメールアドレスのコンタクトが既に存在する場合、新規レコードは作成されず、既存レコードが更新されます。この仕組みを活用するためにも、メールアドレスの入力を徹底することが重要です。
一方、会社オブジェクトについてはドメイン名を一意キーとして管理するのが有効です。HubSpotでは会社の「ドメイン名」プロパティを使って重複を検出する仕組みが用意されています。
名寄せには、以下の3つのアプローチがあります。自社の状況に応じて適切なアプローチを選択、あるいは組み合わせることが重要です。
| アプローチ | 仕組み | 強み | 注意点 |
|---|---|---|---|
| 完全一致マッチング | 一意キーが完全に一致するレコードを対象にする | 誤検出が少なく精度が高い | 表記ゆれによる検出漏れが起きやすい |
| あいまい一致マッチング | 編集距離などのアルゴリズムで「似ている」レコードを候補化する | 表記ゆれも検出できる | 誤検出のリスクがあり、最終判断は人間が行う |
| ルールベースマッチング | 複数条件の組み合わせで候補を検出する | 自社業務に合わせて調整できる | ルール設計に業務理解が必要 |
アプローチ1:完全一致マッチング
一意キーが完全に一致するレコードを名寄せ対象とする方法です。メールアドレスや企業ドメインなど、表記ゆれが発生しにくい項目を使う場合に有効です。精度は高いものの、検出漏れ(表記ゆれによるマッチ失敗)が発生しやすいという特性があります。
アプローチ2:あいまい一致マッチング
レーベンシュタイン距離(編集距離)やサウンデックスなどのアルゴリズムを使い、「似ている」レコードを名寄せ候補として検出する方法です。「株式会社ABC」と「ABC株式会社」、「田中太郎」と「田中 太郎」(スペースの有無)のような表記ゆれを検出できます。ただし、検出範囲が広がる分、誤検出(異なる実体を同一と判定)のリスクがあるため、最終的な判断は人間が行う運用が望ましいです。
アプローチ3:ルールベースマッチング
「会社名が同一」かつ「電話番号の下4桁が一致」のように、複数の条件を組み合わせたルールで名寄せ候補を検出する方法です。自社の業務特性に合わせたカスタマイズが可能で、完全一致とあいまい一致の中間的なバランスを取れます。
重複レコードを統合する際には、どのレコードを残し(マスターレコード)、どのレコードを統合先に吸収させるかを決めるルールが必要です。以下の優先順位で判断することをおすすめします。
HubSpotのマージ機能では、マスターレコードを選択した上で、統合元レコードのプロパティ値を個別に引き継ぐかどうかを選べます。活動履歴やチケット、取引などの関連レコードは、統合後のレコードにすべて引き継がれます。
重複管理は、「発生した重複を統合する」だけでは不十分です。「防止」「検知」「統合」の3層構造で仕組みを設計することが、持続的なデータ品質維持の鍵です。ここでは各層の具体的な施策を順に見ていきます。
効果的な重複管理の基本は、そもそも重複を発生させないことです。以下の施策を組み合わせることで、重複の発生を抑制しやすくなります。
施策1:一意キーの自動照合
レコード作成時に一意キー(メールアドレス、ドメイン等)で自動照合を行い、既存レコードが存在する場合はアラートを出す、または自動的に既存レコードを更新する仕組みを構築します。HubSpotでは、コンタクトのメールアドレスによる自動重複防止が標準機能として備わっています。
施策2:インポート時のプレチェック
外部データのインポート前に、既存データとの照合チェックを実施します。インポートファイルと既存レコードの一意キーを突合し、一致するレコードは「新規作成」ではなく「更新」として処理します。HubSpotのインポート機能では、一意識別子(メールアドレスやレコードID)を指定することで、新規作成と更新を自動で振り分けることが可能です。
施策3:フォーム送信時の自動マッチング
Webフォームから送信されたデータが、既存コンタクトと自動的にマッチングされるよう設定します。HubSpotフォームでは、メールアドレスを必須項目にすることで、既存コンタクトとの自動照合が機能します。同じメールアドレスからのフォーム送信は、新規レコード作成ではなく既存レコードの更新として処理されます。
施策4:入力画面での既存レコード表示
レコードを手動作成する際に、入力途中で類似のレコードが存在するかどうかを画面上に表示する仕組みです。これにより、ユーザーが重複レコードを作成する前に既存レコードの存在に気づけます。
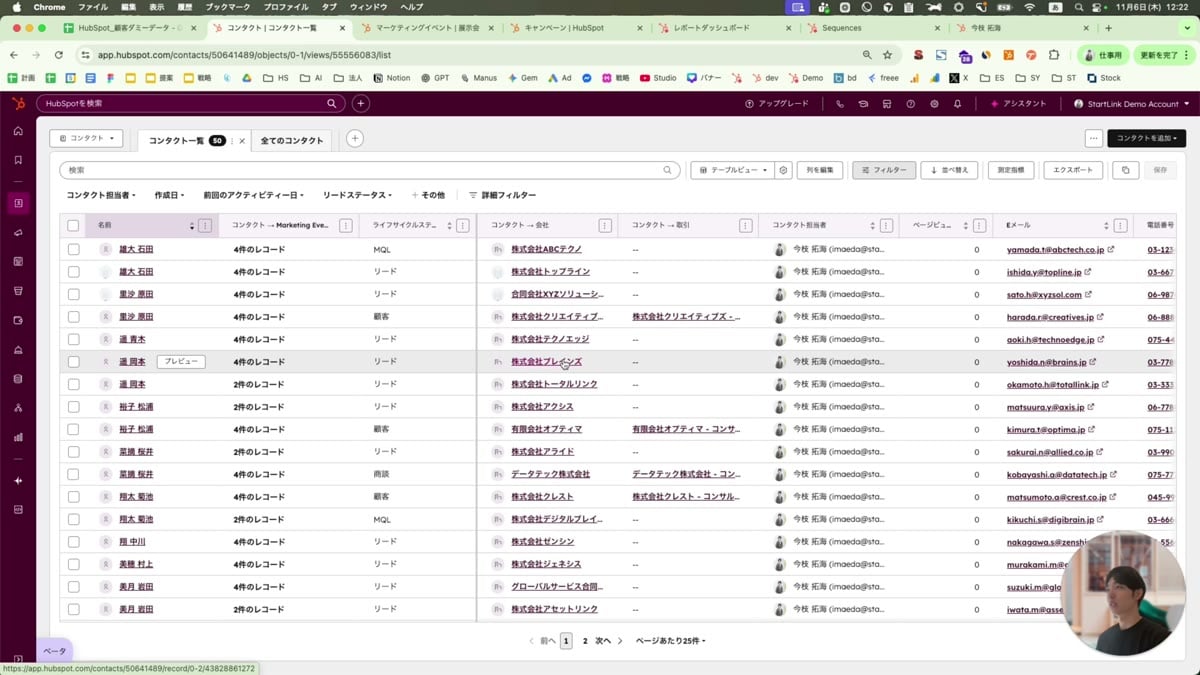
防止策を講じても、重複の発生をゼロにすることは困難です。そのため、発生した重複を速やかに検知する仕組みが必要です。
次の画面は、HubSpotのコンタクト一覧画面です。重複の兆候は、こうした一覧ビューやレポートでメールアドレスや電話番号の重なりを定期的に確認することで見つけられます。
検知方法1:CRM標準の重複管理機能
HubSpotには、AIを活用した重複管理ツールが標準で搭載されています。コンタクトと会社のレコードを自動的にスキャンし、重複候補をリストアップします。メールアドレス、氏名、会社名、電話番号などを総合的に分析し、重複の可能性があるレコードのペアを提示します。ただし、ツールが提示するのはあくまで「候補」です。同名異人やグループ企業を誤って統合すると取り消しが難しいため、最終的なマージ判断は人間が行う運用をおすすめします。
検知方法2:定期的なレポートによる監視
以下のようなレポートを作成し、定期的に確認することで重複の兆候を検知します。
検知方法3:ワークフローによるアラート
特定の条件(例:同じ会社名で新規会社レコードが作成された場合)をトリガーにしたワークフローを設定し、管理者にアラート通知を送る仕組みです。リアルタイムに近い検知が可能になります。
検知された重複レコードを実際に統合するプロセスです。統合にあたっては、以下の手順で進めます。
HubSpotでは、コンタクトと会社のマージが標準機能として提供されています。マージ時には、両方のレコードのプロパティ値を比較し、どちらの値を残すかをプロパティごとに選択できます。また、活動ログ、関連付けられた取引やチケット、リストメンバーシップなどは、統合後のレコードにすべて引き継がれます。なお、ここまでの考え方はHubSpotに限らず、リレーショナルデータベースを持つCRMであれば同様に適用できます。
ここからは、HubSpotの具体的な機能を活用したデータクレンジングの実装パターンを解説します。標準機能だけで完結する部分、Data Hubで自動化を深める部分、ワークフローで運用に組み込む部分の3つに分けて整理します。
次の画面は、HubSpotのデータ品質管理に関する設定画面です。どの機能をどこまで自動化するかを、この種の設定で設計していきます。
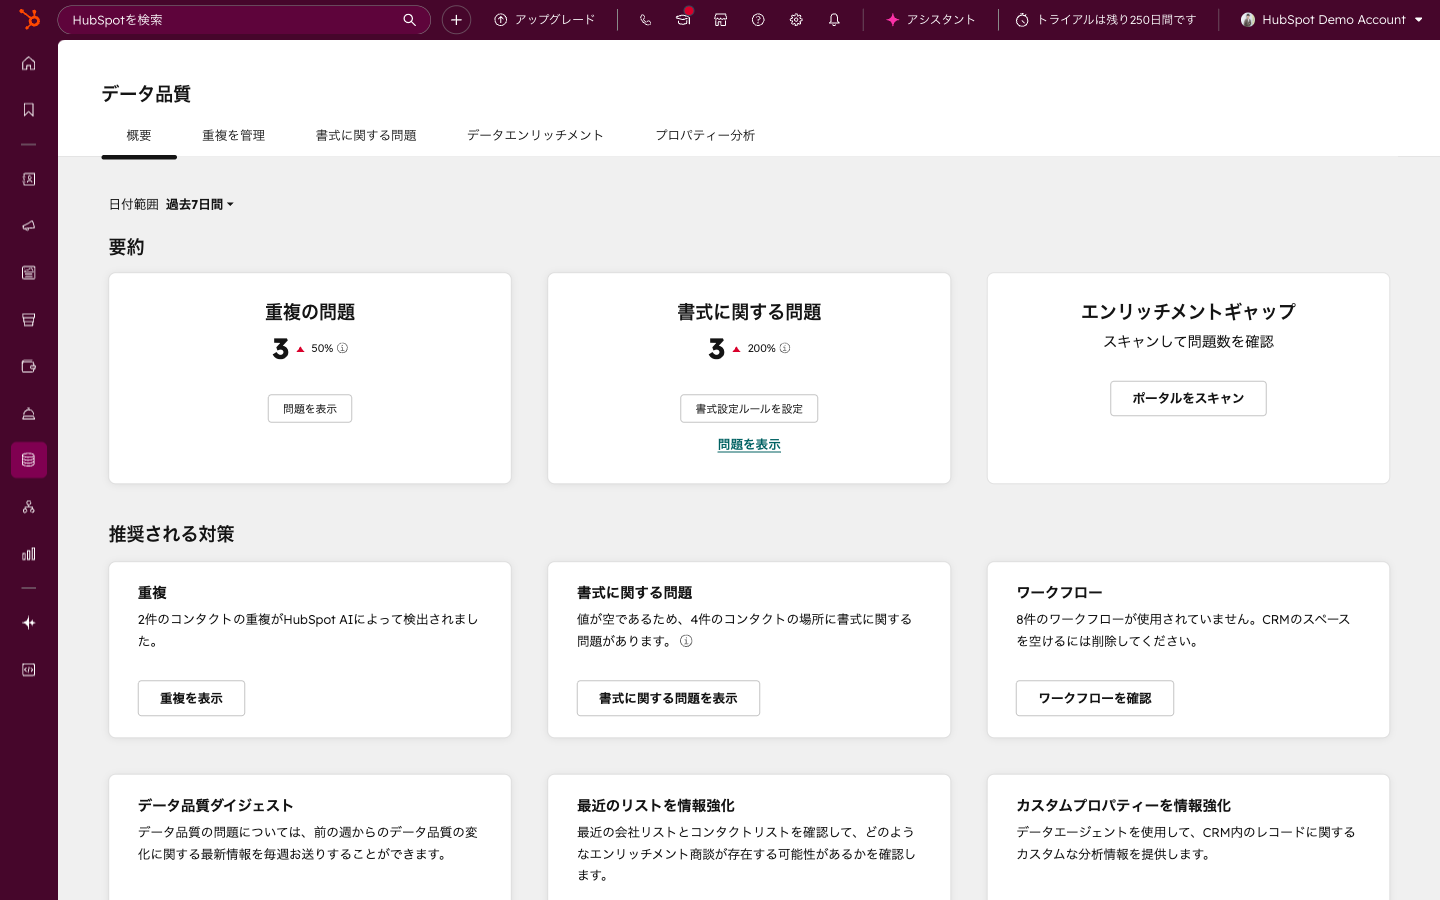
HubSpotの標準機能だけでも、基本的なデータクレンジングは十分に実行可能です。
| 機能 | 活用方法 | 対応するクレンジングアクション |
|---|---|---|
| 重複管理ツール | AIが重複候補を自動検出。手動でマージ判断・実行 | 統合(Merge) |
| プロパティ設定 | フィールドタイプの適切な選択、バリデーションの設定 | 修正(Correction)の予防 |
| インポート機能 | 一意識別子を指定した新規作成/更新の振り分け | 統合(Merge)の予防 |
| リスト機能 | 条件付きリストで品質問題のあるレコードを抽出 | 検知・修正・削除 |
| ワークフロー | プロパティの自動修正、アラート通知の自動化 | 修正(Correction)の自動化 |
HubSpotのData Hubは、データ品質の自動化に特化した機能群を提供します。標準機能では対応しきれない高度なクレンジング要件がある場合に活用します。ただし、すべての企業に必要というわけではなく、標準機能と手動運用で十分まわせるケースも多くあります。まずは標準機能で運用を確立し、自動化のニーズが明確になった段階で導入を検討する進め方が現実的です。
次の画面は、HubSpotのData Hub関連の製品画面です。外部システムとの連携やデータ品質の自動化を、こうした機能群で支える構成になっています。
データ品質自動化(Data Quality Automation)
Data Hubの「データ品質自動化」機能では、以下のようなデータ修正を自動的に実行できます。
これらの処理は、レコードが作成・更新されるたびに自動的に実行されるため、「入力された瞬間にデータがクリーンになる」という状態に近づけやすくなります。ただし、自動修正はルールが誤っていると誤った修正を大量に行ってしまう面もあるため、導入初期は修正対象を絞って挙動を確認しながら広げる進め方が安全です。
カスタムコード(Programmable Automation)
Data Hub Professional以上のプランでは、ワークフロー内にカスタムコード(JavaScript / Python)を組み込むことができます。これにより、標準機能では対応できない複雑なクレンジングロジックを実装できます。
データ同期(Data Sync)
Data Hubのデータ同期機能は、外部アプリケーションとの双方向データ同期を提供します。データ同期において重要なのは、同期フィールドのマッピングとコンフリクト解決ルールの設計です。
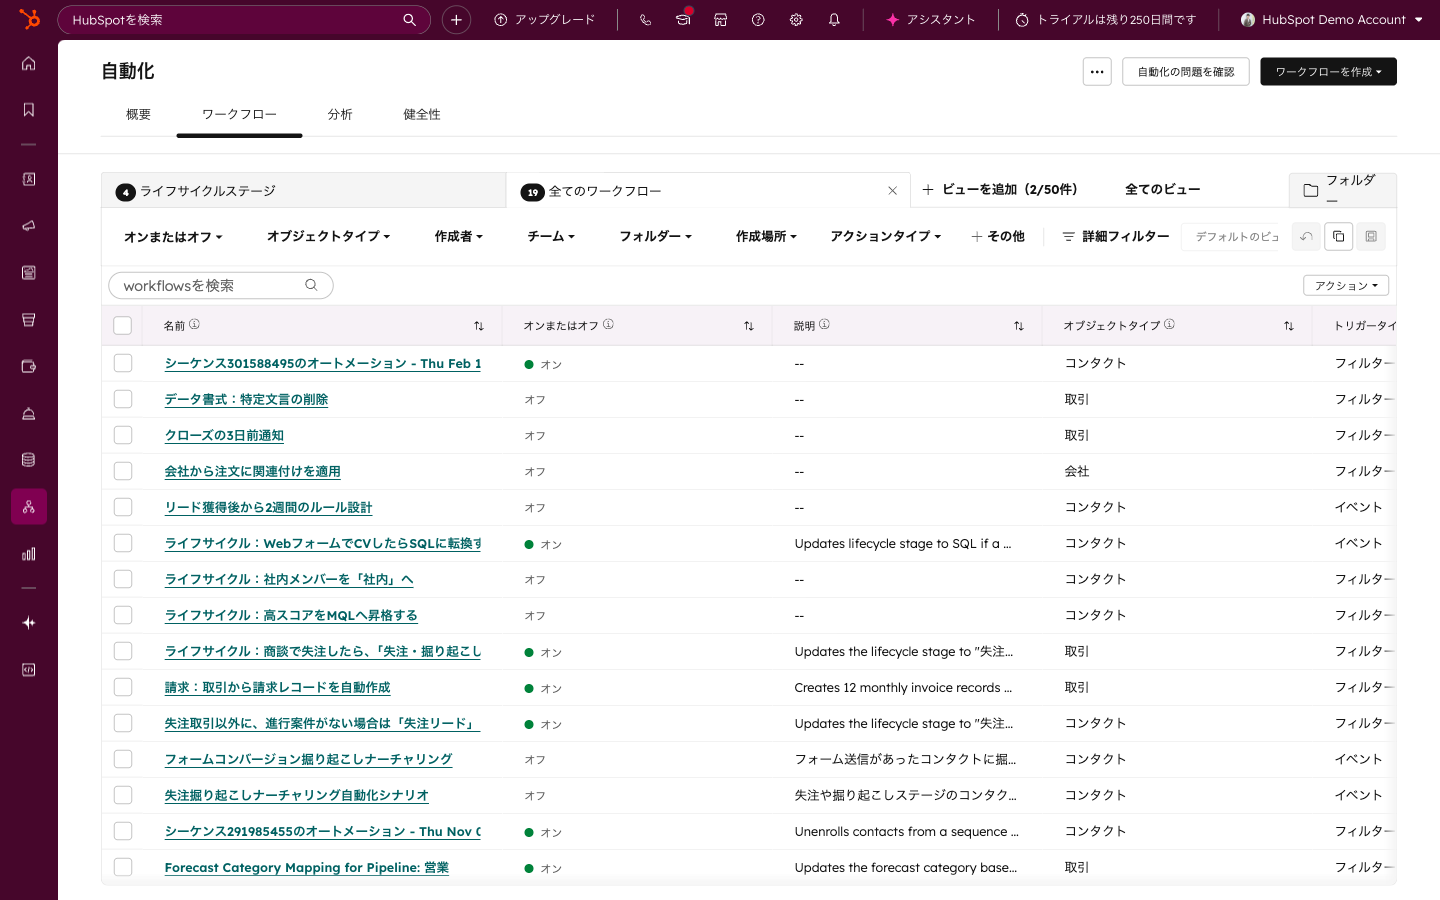
HubSpotのワークフロー機能を使って、データクレンジングの一部を自動化するパターンです。以下に実践的な例を紹介します。
次の画面は、HubSpotのワークフロー一覧画面です。こうしたワークフローを組み合わせることで、日々のクレンジング処理を自動化していきます。
例1:電話番号のフォーマット統一
トリガー:コンタクトのプロパティ「電話番号」が更新されたとき。アクション:電話番号の形式をチェックし、統一フォーマット(例:03-1234-5678形式)に変換する。Data Hubのデータ品質自動化で対応可能です。
例2:未関連付けレコードのアラート
トリガー:コンタクトが作成されてから24時間経過したとき。条件:会社との関連付けがない場合。アクション:CRM管理者にタスクを作成し、関連付けの確認を依頼する。
例3:古いレコードの再確認アラート
トリガー:コンタクトの「最終活動日」から180日が経過したとき。アクション:レコードオーナーに「情報の鮮度を確認してください」というタスクを作成する。
例4:インポートデータの自動品質チェック
トリガー:レコードのソースが「インポート」であるとき。アクション:必須項目(メールアドレス、会社名、業種)が入力されているかチェックし、不足がある場合は管理者にアラートを送信する。
データクレンジングを持続的に機能させるためには、技術的な仕組みだけでなく、組織的な運用設計が不可欠です。ポイントは、担当者個人の丁寧さに頼るのではなく、サイクル・役割・権限という「仕組み」で品質を担保することです。仕組みに落とし込んでおけば、担当者が変わっても新しいメンバーでも同じ品質で運用を回せます。
データクレンジングの運用サイクルは、以下の3つの頻度で設計することをおすすめします。
| 頻度 | 実施内容 | 担当 | 所要時間の目安 |
|---|---|---|---|
| 日次(自動) | ワークフローによる自動修正、フォーマット統一、アラート通知 | システム(自動処理) | 自動のため工数なし |
| 週次(手動) | 重複管理ツールの確認・マージ、アラートへの対応、新規インポートデータの確認 | CRM管理者 | 30分〜1時間 |
| 月次(レビュー) | データ品質スコアカードの確認、プロパティの利用状況分析、クレンジングルールの見直し | CRM管理者+各部門リーダー | 1〜2時間 |
運用を属人化させないためには、明確な役割分担の定義も重要です。
| 役割 | 責務 | 推奨する担当者 |
|---|---|---|
| データオーナー | データ品質の最終責任者。クレンジングルールの承認、例外判断 | 営業企画、RevOpsマネージャー |
| データスチュワード | 日常的なクレンジング作業の実行、品質モニタリング | CRM管理者、オペレーション担当 |
| データ入力者 | 入力ルールの遵守、自身が作成したレコードの品質担保 | 営業、マーケティング、各現場担当者 |
特に重要なのは、「データオーナー」を明確に定義することです。データ品質に対する最終的な責任者が不在だと、「誰の責任でもない」状態となり、品質はじわじわと劣化していきます。
外部データの取り込みは、データ品質を大きく左右するイベントです。以下のプロセスをインポートの標準手順として定めることをおすすめします。
発生してしまったデータ品質の問題に対処するクレンジングも重要ですが、より本質的なのは品質劣化を予防する仕組みを設計段階で組み込むことです。
予防策1:プロパティ設計による品質担保
予防策2:入力ガイドラインの整備
入力ルールを文書化し、全ユーザーがアクセスできるようにします。
予防策3:権限設計による品質ガバナンス
CRMの権限設計を活用して、データ品質に関するガバナンスを構築します。
項目は必要なものに絞る設計が、結果としてデータ品質を底上げします。
CRMにおけるAI活用が急速に進む中、「AIの判断精度=データ品質」という等式はますます重要性を増しています。AI機能がどれほど高度であっても、学習・判断の材料となるデータの品質が低ければ、アウトプットの精度は低くなります。
CRMにおけるAI機能は、蓄積されたデータを学習・分析することで価値を生み出します。具体的には、以下のようなAI機能がデータ品質に直接依存しています。
| AI機能 | 必要なデータ品質 | 品質が低い場合の影響 |
|---|---|---|
| 成約予測(Predictive Lead Scoring) | 正確な取引ステージデータ、完全な顧客属性データ | 予測精度が低下し、優先順位の判断を誤る |
| 顧客セグメンテーション | 一貫性のある属性データ、正確な行動データ | セグメントが不正確になり、施策のターゲティングが外れる |
| 売上フォーキャスト | 正確な取引金額、信頼性のあるステージ進行データ | 売上予測が外れ、経営判断に悪影響を及ぼす |
| レコメンデーション | 完全な取引履歴、正確なコンタクト属性 | 的外れな提案・コンテンツが推奨される |
| 自動メール生成・パーソナライゼーション | 正確なコンタクト情報、最新の関係性データ | 不正確な情報に基づくメールが送信され、信頼を損なう |
「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」は情報処理の古典的な原則ですが、AI時代においてはさらに深刻な意味を持ちます。従来のレポートやダッシュボードであれば、数値を見た人間が「このデータは信頼できない」と判断できました。しかし、AIが自動的に判断・実行する場面では、低品質データに基づく誤った判断がそのまま実行されるリスクがあります。
例えば、AIベースのリードスコアリングが低品質データに基づいて低い優先度をつけたリードが、実は大型案件の意思決定者だったとしたら、機会損失は計り知れません。AIが高度になればなるほど、その前提となるデータ品質の重要性は増していきます。
データクレンジングにおいても、AIに任せる領域と人間が判断する領域を分けて設計することが重要です。
| AI・自動化が得意な領域 | 人間が判断すべき領域 |
|---|---|
| 重複候補の自動検出、フォーマットの統一修正 | あいまい一致候補の最終的なマージ判断 |
AIは候補の検出や定型修正までを担い、統合や例外の最終判断は人間が行うという役割分担が、精度と安全性のバランスを取りやすい形です。クレンジングは「運用のメンテナンス」ではなく、「AI活用の基盤構築」として位置づけると、取り組みの優先度も上げやすくなります。
既にデータ品質の問題を抱えている場合、すべてを一気に解決しようとするとプロジェクトが肥大化して頓挫しがちです。重要度の高い領域から小さく始めて、段階的に範囲を広げる進め方をおすすめします。ここでは5つのステップと、典型的な成功・失敗パターンを整理します。
ステップ1:現状のデータ品質を可視化する
まず、現在のデータ品質がどの程度かを定量的に把握します。
この可視化によって、「どの領域のデータ品質が最も問題か」が明確になり、優先順位をつけた対策が可能になります。
ステップ2:優先順位を決める
すべてのデータ品質問題に同時に取り組むのは現実的ではありません。ビジネスインパクトが大きい問題から優先的に対処するのが原則です。
ステップ3:クレンジングを実行する
優先順位に基づいて、実際のクレンジング作業を実行します。大量のレコードを対象にする場合は、以下の点に注意してください。
ステップ4:予防策を導入する
クレンジングプロジェクトと並行して、前述の予防策(プロパティ設計の見直し、入力ガイドラインの整備、ワークフローによる自動化)を導入します。クレンジングだけを行って予防策を導入しなければ、時間の経過とともに同じ問題が再発します。
ステップ5:モニタリングの仕組みを確立する
データ品質スコアカードに基づく定期的なモニタリングの仕組みを確立し、品質の推移を追跡します。品質が低下した場合にすぐに気づき、対策を講じられる体制を整えることが、クレンジングプロジェクトの成果を持続させる鍵です。
データクレンジングに取り組む企業の典型的な成功パターンと失敗パターンを整理します。
成功パターン
| パターン | 特徴 | 効果 |
|---|---|---|
| 設計段階からクレンジングを組み込む | CRM設計時点で予防策と運用サイクルを設計 | 後追いの大規模クレンジングが不要になる |
| データオーナーを明確に定義する | データ品質の責任者を組織的に任命 | 品質改善のPDCAが継続的に回る |
| 自動化と手動の適切なバランス | ルール化できるものは自動化し、判断が必要なものは人間が対応 | 運用負荷を抑えつつ品質を維持 |
| 小さく始めて範囲を広げる | 重要度の高い領域からクレンジングを開始し、段階的に拡大 | 早期に成果を出し、組織の理解を得やすい |
失敗パターン
| パターン | 典型的な症状 | 原因 |
|---|---|---|
| 一度きりのクレンジングで終わる | クレンジング直後は改善するが、数ヶ月で元に戻る | 予防策と継続的な運用サイクルが未設計 |
| すべてを一気に解決しようとする | プロジェクトが肥大化し、完了しない | 優先順位をつけず全領域に手を広げる |
| ツールだけに頼る | ツールを導入したが品質が改善しない | 運用ルールと組織体制の整備が不十分 |
| 現場を巻き込まない | 管理者がクレンジングしても、現場の入力品質が改善しない | データ品質の重要性が現場に浸透していない |
A. CRM導入前のデータ移行時が最初のクレンジングタイミングです。旧システムのデータをそのまま移行すると、品質問題もそのまま引き継がれるため、移行前にクレンジングを実施してきれいなデータでスタートさせることをおすすめします。ただし導入前だけでは不十分で、導入後も週次の重複確認や月次の品質レビューといった継続的な運用を組み込むことが重要です。
A. 大量の重複がある場合は、完全一致(メールアドレスやドメインが完全に一致)のレコードから先に処理する段階的なアプローチが現実的です。次にあいまい一致の候補を重複管理ツールで確認し、明確なものから順に処理していきます。数千件規模の場合はData HubのカスタムコードやAPIを活用した半自動処理の検討も有効です。並行して発生防止策を導入し、新たな重複を止めることも忘れないようにしてください。
A. 可能です。HubSpotの標準機能(重複管理ツール、ワークフロー、リスト機能、インポート機能)だけでも、基本的なデータクレンジングは十分に実行できます。重要なのはツールの有無ではなく、運用ルールと運用サイクルの設計です。まずは標準機能でクレンジング運用を確立し、自動化のニーズが明確になった段階でData Hubの導入を検討する進め方が実践的です。
A. ビジネスインパクトの言語で説明するのが有効です。例えば、メール配信の到達率向上による「マーケティング施策の効果改善」、重複統合による「正確な顧客数・パイプライン金額の把握」、営業が正しい情報にアクセスできることによる「営業効率の向上」、AI活用の前提条件としての「データ基盤整備」です。重複率の削減や入力率の向上といった定量的な指標をビフォーアフターで示すと、投資対効果を明確に伝えられます。
A. 「会社名の一致度が80%以上、かつ電話番号の下4桁が一致する場合は同一企業と判断する」のように、判断基準を事前に明文化しておくことが重要です。自動判定で確定できないものは判断保留リストに入れ、定期的に人間が確認する運用にします。誤ったマージは取り消しが難しいため、迷うケースを無理に統合するよりも保留にして慎重に判断する方が安全です。
CRMデータクレンジングは、「汚れたデータを掃除する」という後処理ではなく、データ品質を維持・向上させるための継続的な仕組みづくりです。本記事で解説したポイントを整理すると、以下の通りです。
データクレンジングの取り組みは、短期的には地味で成果が見えにくいかもしれません。しかし、データ品質の維持・向上は、CRMの「入力→蓄積→活用」サイクルを支える基盤であり、将来のAI活用の天井を決める要素です。企業様によって最適な形は異なりますので、まずは重複の多い領域や重要プロパティの入力率から始めて、段階的に範囲を広げていただければと思います。
最初の一歩として、以下の3ステップから始めることをおすすめします。
CRMを活用した業務効率化やAIとの連携に関するご相談は、CRM特化型コンサルティングのHubSpotゴールドパートナーのStartLinkまでお気軽にお問い合わせください。
株式会社StartLinkは、事業推進に関わる「販売促進」「DXによる業務効率化(ERP/CRM/SFA/MAの導入)」などのご相談を受け付けております。 サービスのプランについてのご相談/お見積もり依頼や、ノウハウのお問い合わせについては、無料のお問い合わせページより、お気軽にご連絡くださいませ。
