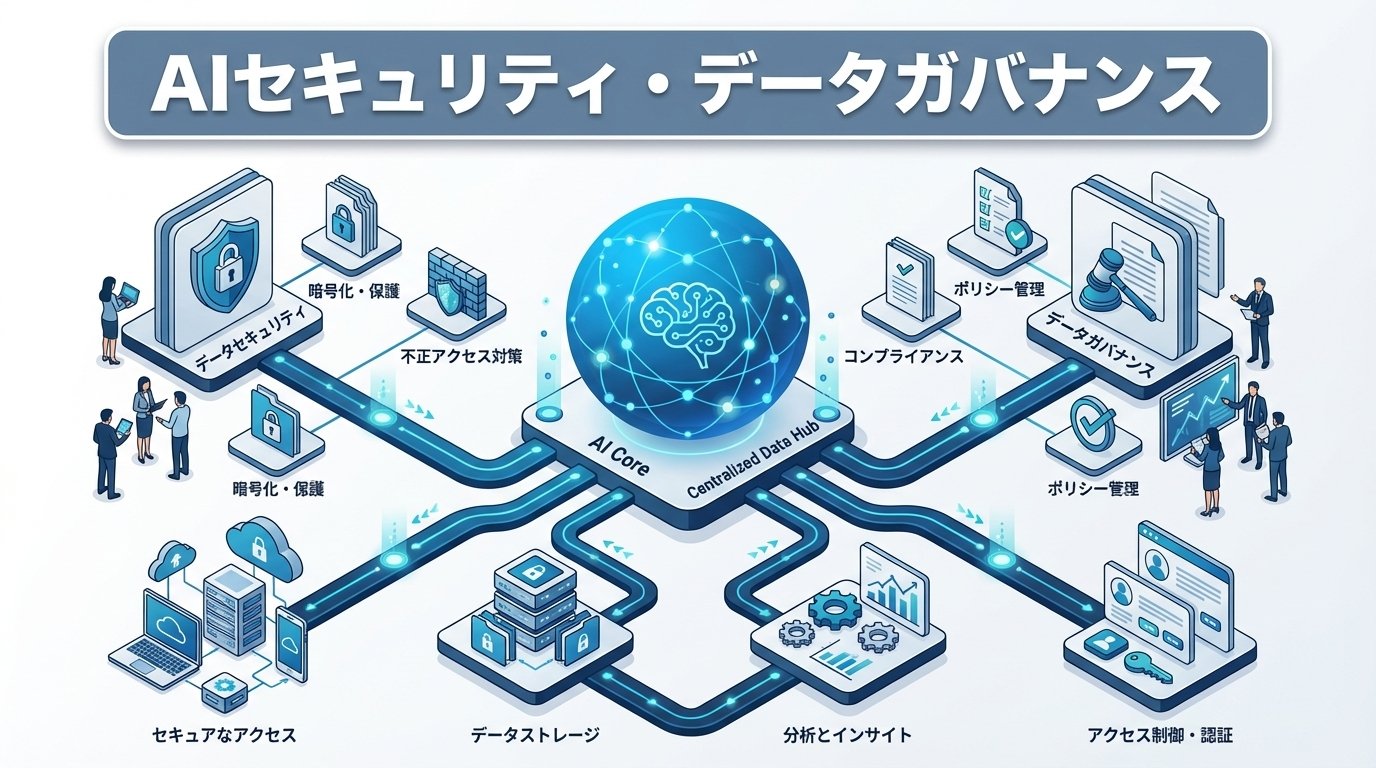
企業のAIセキュリティは「禁止から管理へ」のシフトが正解です。機密情報の分類(公開・社内・機密・極秘)をベースに、APIリスク管理・DLP連携・社内ガイドライン策定の3層で設計することで、利活用と安全性を両立できます。
AIの爆発的な普及により、企業の機密情報が意図せずAIサービスに送信されるリスクが急増しています。Samsung Electronicsの半導体部門でChatGPTへの機密コード流出が報道されたことは記憶に新しいですが、これは氷山の一角です。多くの企業で、社員が善意で業務効率化のためにAIを使った結果、知らずに情報漏洩を起こしているケースが発生しています。しかし、「AIを使うな」という全面禁止は現実的ではありません。AIを活用しない企業は競争力を失います。重要なのは、リスクを正しく理解し、適切なガバナンス体制を構築した上でAIを活用することです。ここが要点なのですが、AIセキュリティの設計で最も見落とされがちなのは、同じAIサービスでもWebUI経由とAPI経由でデータの取り扱いが根本的に異なるという点です。
この記事でわかること
AI活用におけるセキュリティとデータガバナンスを整備したい情報システム部門・経営者に向けた記事です。
- AIに入力するデータの機密レベルの分類方法 — 自社データを機密度で分けて、安全にAIを活用するための基準を解説します
- Web画面とAPI利用のセキュリティの違い — API経由はコントロールが効くが適切な設計が必要であることを紹介します
- AI利用ガイドラインの作り方 — 「顧客リストをChatGPTに貼り付けても大丈夫か?」に答えるための社内ルールの作り方を解説します
- CRM・HubSpotのデータをAIで扱う際の注意点 — 顧客データとAIの組み合わせで気をつけるべきセキュリティ設計を紹介します
- Claude・ChatGPT・Geminiのデータ取り扱い比較 — 各AIサービスがデータをどう扱うかのポリシーを比較します
AIサービスのデータリスクを正しく理解する
02
SECTION 02
AIサービスのデータリスクを正しく理解する
WebUI vs API——知らないと危険な違い
多くの企業担当者が見落としている最も重要なポイントがここです。
| 項目 |
WebUI(ブラウザ版) |
API利用 |
| モデル学習への利用 |
デフォルトでONの場合あり |
原則OFF(利用規約による) |
| データの保持期間 |
会話履歴として長期保持 |
短期間(通常30日以内) |
| アクセス制御 |
個人アカウント依存 |
APIキー管理で制御可能 |
| 監査ログ |
取得困難 |
APIログで取得可能 |
| 利用規約 |
Consumer向け |
Business/Enterprise向け |
AnthropicのConsumer Termsでは、無料版・Pro版のWebUI利用においてモデル改善のためにデータが使用される可能性があることが明記されています。一方、API利用規約では、顧客のデータをモデルの学習に使用しないことが明確に記載されています。
OpenAIも同様で、Enterprise Privacyページにおいて、API経由のデータはモデルの学習に使用されないと明示しています。ただし、ChatGPT Free/Plusの利用規約は異なるため注意が必要です。
主要AIサービスのデータポリシー比較
| サービス |
WebUI学習利用 |
API学習利用 |
データ保持 |
SOC 2認証 |
| Claude(Anthropic) |
オプトアウト可能 |
なし |
API: 30日 |
取得済み |
| ChatGPT(OpenAI) |
デフォルトON(オプトアウト可能) |
なし |
API: 30日 |
取得済み |
| Gemini(Google) |
デフォルトON(Workspace版は別) |
なし(有料APIプラン) |
プランによる |
取得済み |
| Copilot(Microsoft) |
M365版はなし |
なし |
M365規約に準拠 |
取得済み |
注意:上記は執筆時点の情報です。各サービスの利用規約は頻繁に更新されるため、導入前に必ず最新の規約を確認してください。
入力データの機密分類フレームワーク
03
SECTION 03
入力データの機密分類フレームワーク
AIサービスに安全にデータを入力するためには、まず自社のデータを機密レベルで分類する必要があります。
4段階機密分類
| レベル |
分類名 |
定義 |
AIへの入力 |
例 |
| L1 |
公開情報 |
外部に公開済みの情報 |
WebUI・API ともにOK |
Webサイト掲載情報、プレスリリース |
| L2 |
社内一般 |
社内で広く共有される情報 |
API利用のみOK |
社内マニュアル、一般的な業務手順 |
| L3 |
機密 |
特定部門・役職に限定される情報 |
エンタープライズAPI + 承認制 |
顧客リスト、未発表の事業計画 |
| L4 |
極秘 |
AI入力を原則禁止する情報 |
禁止(例外なし) |
個人情報(氏名・連絡先)、クレジットカード情報、APIキー・パスワード |
CRM・HubSpotデータの機密分類
HubSpotに蓄積されるデータを具体的に分類すると以下のようになります。
| HubSpotデータ種別 |
機密レベル |
AI利用の可否 |
注意点 |
| 公開済み企業情報(会社名・業種) |
L1 |
WebUI・API可 |
公開情報のため問題なし |
| 商談ステージ・金額 |
L3 |
API限定 |
集計・匿名化してから利用 |
| コンタクト情報(氏名・メール) |
L4 |
禁止 |
個人情報保護法の対象 |
| 会話ログ・メール本文 |
L3 |
API限定 |
個人情報を含む場合はL4 |
| カスタムプロパティ(業務固有データ) |
L2〜L3 |
内容による |
設計時に分類を決定 |
今枝(StartLink代表)は、CRMデータのAI活用について次のように語っています。
「CRMのデータをAIに分析させたいというニーズは非常に多いですが、ほとんどの企業がデータの機密分類をしていません。『とりあえず全部ChatGPTに貼り付けて分析して』というのは、社員の住所録を駅前で配っているのと同じです。まずデータの分類、次にAPIの利用、そしてガバナンスの整備——この順番を守ってください。」
社内AIガイドラインの策定手順
04
SECTION 04
社内AIガイドラインの策定手順
ガイドラインに含めるべき7要素
| # |
要素 |
内容 |
優先度 |
| 1 |
目的と適用範囲 |
なぜガイドラインが必要か、誰に適用されるか |
必須 |
| 2 |
許可されたAIサービスのリスト |
利用可能なサービスと利用条件 |
必須 |
| 3 |
データ分類と入力ルール |
4段階機密分類と各レベルの入力可否 |
必須 |
| 4 |
利用シーン別のガイド |
業務別の具体的なDo / Don't |
必須 |
| 5 |
インシデント対応手順 |
誤って機密情報を入力した場合の対処 |
必須 |
| 6 |
教育・研修計画 |
ガイドラインの周知と定期研修 |
推奨 |
| 7 |
見直しスケジュール |
四半期ごとのガイドライン更新 |
推奨 |
利用シーン別のDo / Don't
| 利用シーン |
Do(推奨) |
Don't(禁止) |
| 文章作成 |
一般的なビジネス文書のドラフト生成 |
顧客名・取引先名を含む文書の生成 |
| データ分析 |
公開データの傾向分析 |
顧客リスト・売上データの直接入力 |
| コード生成 |
汎用的なコードの生成 |
APIキー・認証情報を含むコードの入力 |
| 翻訳 |
公開向けコンテンツの翻訳 |
NDA対象の契約書の全文翻訳 |
| リサーチ |
市場動向・競合調査 |
未公開の自社戦略を含む質問 |
| メール作成 |
テンプレートのドラフト生成 |
宛先・個人情報を含む実メールの添削 |
API利用時のセキュリティ設計
05
SECTION 05
API利用時のセキュリティ設計
API経由でAIを利用する場合、WebUI利用よりもセキュリティコントロールが効きますが、適切な設計が必要です。
APIキー管理の基本
| 管理項目 |
推奨対策 |
リスク |
| APIキーの保管 |
環境変数 or Secrets Manager |
ソースコードに直書きすると流出リスク |
| アクセス制御 |
キーごとの利用者・用途を明確化 |
共有キーは責任の所在が不明確 |
| ローテーション |
90日ごとにキーを更新 |
長期利用はキー漏洩時の影響が拡大 |
| 利用量監視 |
日次でAPI利用量をモニタリング |
異常利用の早期検出 |
| 監査ログ |
全APIリクエストのログを保存 |
インシデント時の調査に必要 |
データの匿名化・マスキング
機密レベルL3のデータをAPIで処理する場合は、入力前にデータを匿名化・マスキングする処理が必要です。
匿名化の例:
- 企業名 → 「業種:製造業、従業員数:500〜1000名、売上規模:100億円台」
- 個人名 → 「担当者A」「決裁者B」
- 金額 → 範囲表記(「3000万〜5000万円の案件」)
- 日付 → 相対表記(「導入後6ヶ月時点で」)
AIツール選定とセキュリティの両立については、AIツール選定フレームワークの記事も参考にしてください。
インシデント対応——情報を入力してしまった場合
06
SECTION 06
インシデント対応——情報を入力してしまった場合
どれだけガイドラインを整備しても、ヒューマンエラーは起こり得ます。重要なのは、発生時の迅速な対応です。
インシデント対応フロー
| ステップ |
アクション |
時間目標 |
| 1. 検知 |
入力者本人または監視システムが検知 |
即座 |
| 2. 報告 |
セキュリティ担当者に報告 |
1時間以内 |
| 3. 影響評価 |
入力されたデータの機密レベル・範囲を特定 |
4時間以内 |
| 4. 対処 |
AIサービス側への削除依頼、会話履歴の消去 |
24時間以内 |
| 5. 通知 |
影響を受ける顧客・関係者への通知(必要な場合) |
72時間以内 |
| 6. 再発防止 |
ガイドラインの更新、追加研修の実施 |
1週間以内 |
AIサービス別の削除対応
ここが要点なのですが、WebUI経由で入力したデータは、会話履歴を削除しても、すでにモデルの学習に使用されている可能性があるという点を理解しておく必要があります。だからこそ、機密データのAI処理はAPI経由に限定すべきなのです。
コンプライアンスと法規制
関連する法規制
| 法規制 |
対象 |
AI利用への影響 |
| 個人情報保護法(日本) |
個人情報を取り扱う全企業 |
個人データのAI入力には本人同意が必要 |
| GDPR(EU) |
EU居住者のデータを扱う企業 |
データの越境移転制限、削除権の保障 |
| AI規制法(EU AI Act) |
EU市場でAIを提供・利用する企業 |
リスクベースの分類と適合義務 |
| 不正競争防止法(日本) |
営業秘密を保有する企業 |
営業秘密のAI入力は秘密管理性の喪失リスク |
特に注意すべきは不正競争防止法です。営業秘密として法的保護を受けるためには、秘密として管理されていることが要件です。社員が自由にAIに入力できる状態は、秘密管理性を失わせるリスクがあります。
個人情報保護委員会のガイドラインを確認し、自社のAI利用ポリシーとの整合性を検証してください。
HubSpot × AI利用の具体的なセキュリティ設計
08
SECTION 08
HubSpot × AI利用の具体的なセキュリティ設計
CRMデータをAIで活用する場合の、具体的なセキュリティ設計を解説します。Claude Codeを使った経営データの可視化にも、こうした考え方が反映されています。
HubSpot MCP利用時のセキュリティ
HubSpot MCPサーバーを通じてCRMデータにAIからアクセスする場合、以下の設計が必要です。
| 設計項目 |
推奨設定 |
理由 |
| アクセストークンのスコープ |
必要最小限の権限のみ |
過剰な権限はデータ漏洩リスク |
| 取得データの範囲 |
フィルタリングで限定 |
全件取得は不必要なデータ露出 |
| ログの保存 |
全MCPリクエストをログ保存 |
監査・インシデント対応 |
| 実行環境 |
ローカル実行を推奨 |
クラウド実行はデータの経路が複雑化 |
AIファースト組織全体のセキュリティ設計については、AIファースト組織設計の記事を参照してください。
Breezeの活用とリスク
HubSpotの組み込みAI「Breeze」は、HubSpotのデータセキュリティ基盤の上で動作するため、外部AIサービスに比べてリスクが低い選択肢です。HubSpot Trust Centerで最新のセキュリティ情報を確認できます。
導入ロードマップ
Phase 1:現状把握とリスク評価(2週間)
- 社内でのAI利用実態調査(どのサービスを、誰が、何に使っているか)
- データの機密分類
- 主要リスクの特定
Phase 2:ガイドライン策定と承認(2週間)
- 7要素を含むガイドラインのドラフト作成
- 法務・情報セキュリティ部門のレビュー
- 経営層の承認
Phase 3:展開と教育(1ヶ月)
- 全社員への周知(説明会・Eラーニング)
- 部門別の具体的なDo / Don'tリストの配布
- 質問窓口の設置
Phase 4:運用と改善(継続的)
- 四半期ごとのガイドライン見直し
- インシデント対応訓練
- 新しいAIサービスのセキュリティ評価
正直な限界と注意点
完全なリスク排除は不可能:どれだけガバナンスを整備しても、ヒューマンエラーをゼロにすることはできません。テクノロジーによる制御(DLP: Data Loss Prevention ツールの導入)と、教育による意識向上の両方が必要です。
ガイドラインの形骸化リスク:一度作ったガイドラインが更新されず形骸化するケースが多発しています。四半期ごとの見直しと、実際のインシデント事例を反映した更新が不可欠です。
AI技術の急速な変化:AIサービスの利用規約やデータポリシーは頻繁に変更されます。ガイドラインに「最新の利用規約を確認すること」という原則を組み込んでください。
過剰な制限による生産性低下:セキュリティを厳しくしすぎると、社員がシャドーAI(会社に報告せず個人アカウントでAIを利用する行為)に走るリスクがあります。現実的なバランスが重要です。
まとめ——「使わない」のではなく「正しく使う」
AIセキュリティとデータガバナンスの目的は、AIの利用を禁止することではありません。リスクを適切に管理した上で、AIの恩恵を最大限に享受することです。このテーマの全記事はAI経営・戦略ガイドでご覧いただけます。
4段階機密分類でデータを整理し、WebUI/APIの違いを理解し、実践的なガイドラインを策定してください。そして何より、ガイドラインを「一度作って終わり」にせず、四半期ごとに見直す運用を確立してください。
HubSpotゴールドパートナーのStartLinkでは、CRM × AIの活用を前提としたセキュリティとガバナンス設計のコンサルティングを提供しています。HubSpotのデータ活用とセキュリティの両立、社内AIガイドラインの策定支援を行っています。データガバナンスにお悩みの方は、お気軽にご相談ください。
関連記事:
参考リンク:
よくある質問(FAQ)
Q1. 無料版のChatGPTを社員が業務で使うのは問題ですか?
業務内容によります。公開情報の調査やアイデア出しなど、L1レベルのデータのみを扱う場合は許容できます。ただし、顧客情報や社内機密を入力するのは禁止すべきです。可能であれば、API利用またはBusiness/Enterprise版への移行を推奨します。無料版はデフォルトでモデル学習にデータが使用される点を社員に周知してください。
Q2. API経由なら機密データを入力しても安全ですか?
API経由のほうがWebUI利用より安全ですが、「完全に安全」ではありません。APIでもデータはネットワーク経由で送信されるため、通信経路の暗号化(TLS)、APIキーの適切な管理、入力データの匿名化・マスキングは必要です。また、L4レベル(極秘)のデータはAPIでも入力を禁止すべきです。
Q3. 自社でLLMをホスティングすればセキュリティリスクはなくなりますか?
外部へのデータ送信リスクはなくなりますが、別のリスクが発生します。自社ホスティングには、モデルの保守・更新コスト、インフラのセキュリティ管理、専門人材の確保が必要です。また、ローカルで動作するモデルの性能は商用APIサービスに比べて劣る場合が多く、費用対効果の慎重な検討が必要です。
Q4. 社内ガイドラインを作っても守られない場合はどうすべきですか?
3つのアプローチを組み合わせてください。(1)テクノロジーによる制御(DLPツールで機密データの外部送信を検知・ブロック)、(2)教育と啓発(実際のインシデント事例を使った研修)、(3)インセンティブ設計(ガイドライン遵守を評価に反映)。特に(1)のテクノロジー制御は、人間の意識に頼らない対策として効果的です。
Q5. CRMデータをAIで分析したい場合、最も安全な方法は何ですか?
最も安全な方法は、HubSpotの組み込みAI「Breeze」を活用することです。BreezeはHubSpotのセキュリティ基盤上で動作し、外部にデータが送信されません。より高度な分析が必要な場合は、HubSpot MCP経由でClaude APIに接続し、データを匿名化した上で処理する方法を推奨します。いずれの場合も、個人情報(コンタクト名・メールアドレス等)はマスキングしてから処理してください。